پرش به محتوای اصلی

موضوع

همراستاسازی

Alignment research, RLHF, Constitutional AI, safety training

۱٬۱۰۲ مقاله منتشر شده

آموزش کاربردی

«جست‌وجوی درهای پشتی پنهان»؛ هدف از رقابت ۵۱ هزار دلاری Vulcora

پلتفرم Vulcora چالشی امنیتی با جایزه بیش از ۵۱ هزار دلار برگزار کرده است تا متخصصان بتوانند جملات تحریک‌کننده پنهان در مدل‌های هوش مصنوعی را بیابند. این رقابت خطر استقرار مدل‌های…

۷ دقیقه خواندن

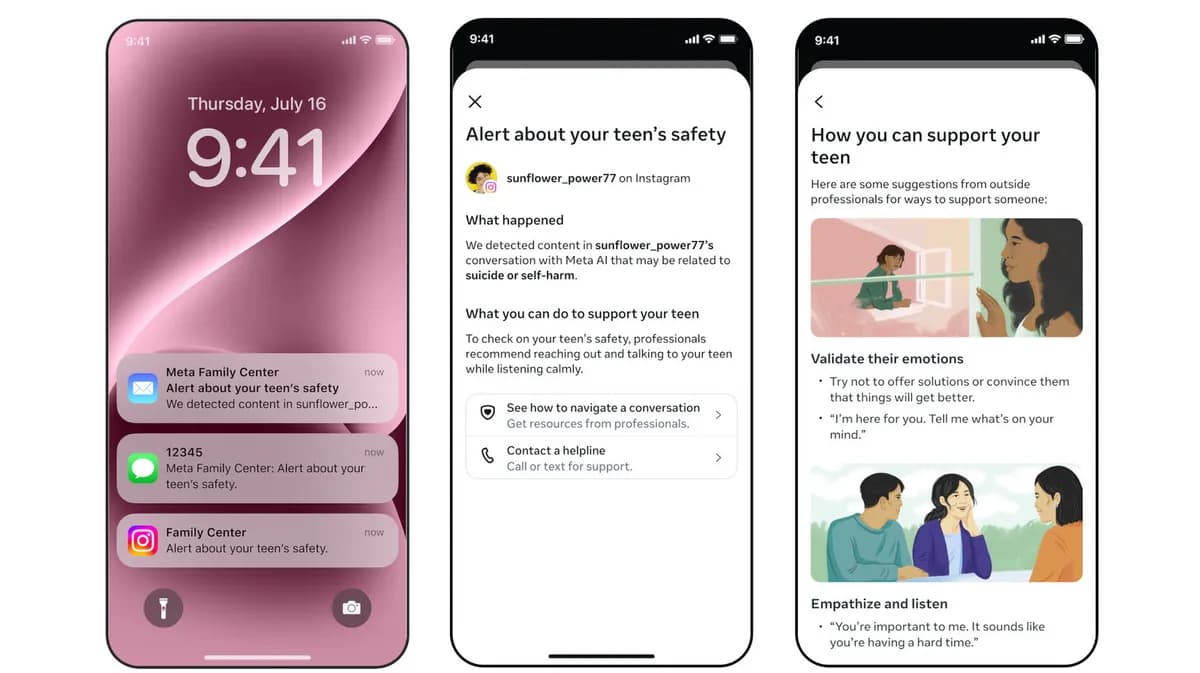
هوش مصنوعی متا چگونه ریسک خودکشی نوجوانان را به والدین هشدار می‌دهد؟

متا سامانه‌ای تخصصی برای شناسایی گفتگوهای مربوط به خودکشی و آسیب به خود در میان نوجوانان مستقر کرده است. این قابلیت که با نظارت انسانی برای جلوگیری از هشدارهای اشتباه همراه است،…

۲ دقیقه خواندن

برنامه‌ریزی پیش‌دستانه در برابر توجیه‌های لحظه‌ای در مدل‌های زبانی

تحلیل رفتار مدل‌های زبانی نشان می‌دهد که تفاوت عمیقی میان فرآیند تصمیم‌گیری داخلی و توضیحات بیرونی آن‌ها وجود دارد. در حالی که مدل‌هایی مثل Claude قادر به برنامه‌ریزی پیش‌دستانه…

۹ دقیقه خواندن۱
آموزش کاربردی

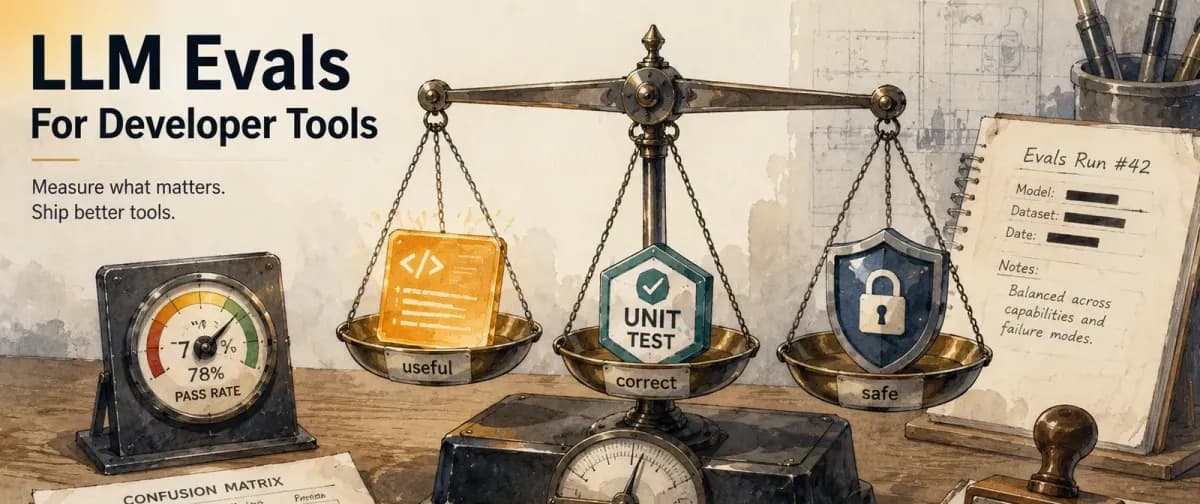
۵۹٪ از سخت‌ترین آزمون‌های SWE-bench Verified به‌دلیل خطاهای فنی شکست خوردند

تحلیل‌های جدید نشان می‌دهد بنچمارک‌های کدنویسی به‌جای سنجش مهارت مهندسی، حافظه مدل‌ها را اندازه می‌گیرند. تیم‌های توسعه برای ارزیابی واقعی باید سه محور مستقلِ صحت، کاربردی بودن و…

۱۹ دقیقه خواندن۱

چرا گوگل DeepMind محدودیت‌های اخلاقی Gemini را پیش پنتاگون کنار گذاشت؟

افشای جزئیات قرارداد جدید گوگل با پنتاگون نشان می‌دهد این شرکت حفاظ‌های اخلاقی علیه سلاح‌های خودمختار را کنار گذاشته است. این توافق به ارتش آمریکا اجازه می‌دهد فیلترهای ایمنی مدل…

۵۴ دقیقه خواندن۱

«اتوماسیون Red-Teaming»؛ راهکار جدید OpenAI برای شناسایی حفره‌های امنیتی

اوپن‌ای‌آی مدل تخصصی GPT-Red را برای شناسایی و رفع خودکار حفره‌های امنیتی مدل‌های دیگر توسعه داده است. این سیستم با استفاده از یک حلقه «بازی با خود»، استواری GPT-5.6 را به‌طوری…

۵ دقیقه خواندن۲

بردار‌های هدایت مفاهیم در مدل‌های مختلف هوش مصنوعی با چرخش خطی منتقل می‌شوند

پژوهش‌های جدید نشان می‌دهد بردار‌های هدایت (Steering Vectors) یک مدل زبانی را می‌توان با یک چرخش ریاضی ساده به مدل دیگری از خانواده‌ای متفاوت منتقل کرد. این یافته ثابت می‌کند…

۲۰ دقیقه خواندن