پرش به محتوای اصلی

موضوع

همراستاسازی

Alignment research, RLHF, Constitutional AI, safety training

۱٬۱۰۲ مقاله منتشر شده

سیاست «زمان جنگ» نیروی دریایی آمریکا: سرعت استقرار AI بر ایمنی اولویت دارد

وزارت نیروی دریایی ایالات متحده استراتژی «AI-first» را آغاز کرده است که در آن سرعت عملیاتی بر همراستاسازی کامل سیستم‌ها ترجیح داده می‌شود. این رویکرد با هدف پیشی گرفتن از رقبای…

۵ دقیقه خواندن

HalluSquatting: تبدیل توهمات هوش مصنوعی به درگاه‌های اجرای بدافزار

پژوهشگران نوع جدیدی از حملات به نام HalluSquatting را شناسایی کرده‌اند که در آن مهاجمان دامنه‌ها یا بسته‌هایی را ثبت می‌کنند که مدل‌های هوش مصنوعی احتمالاً آن‌ها را ابداع می‌کنند.…

۱۰ دقیقه خواندن

«تحلیل شکست‌خورده‌ها»؛ استراتژی جدید SEED برای اصلاح مسیر یادگیری عامل‌ها

پژوهش جدیدی متد SEED را معرفی کرده است که عامل‌های هوش مصنوعی را آموزش می‌دهد تا مسیرهای شکست‌خورده خود را تحلیل کرده و درس‌های به‌دست‌آمده را در سیاست‌های رفتاری خود تثبیت کنند.…

۶ دقیقه خواندن
آموزش کاربردی

توهمِ یک عامل هوش مصنوعی ۳۸ هزار دلار تخفیف غیرمجاز هزینه کرد

یک عامل خدمات مشتریان به‌اشتباه تخفیف ۵۰ درصدی مادام‌العمر به کاربر اعطا کرد که منجر به ضرری ۳۸ هزار دلاری شد. این حادثه ثابت می‌کند توهمات یک ویژگی بنیادی در مدل‌های زبانی هستند…

۷ دقیقه خواندن
آموزش کاربردی

Orbital Brain: معماری هفت‌مرحله‌ای برای حذف خطای انسانی در عملیات فضایی

معماری Orbital Brain با جداسازی مدل‌های زبانی از حلقه‌ی فرمان مستقیم، نقش آن‌ها را از کنترل‌گر به دستیار شناختی تغییر می‌دهد. این سیستم داده‌های خام تله‌متری را به راهنمایی‌های…

۴ دقیقه خواندن
آموزش کاربردی

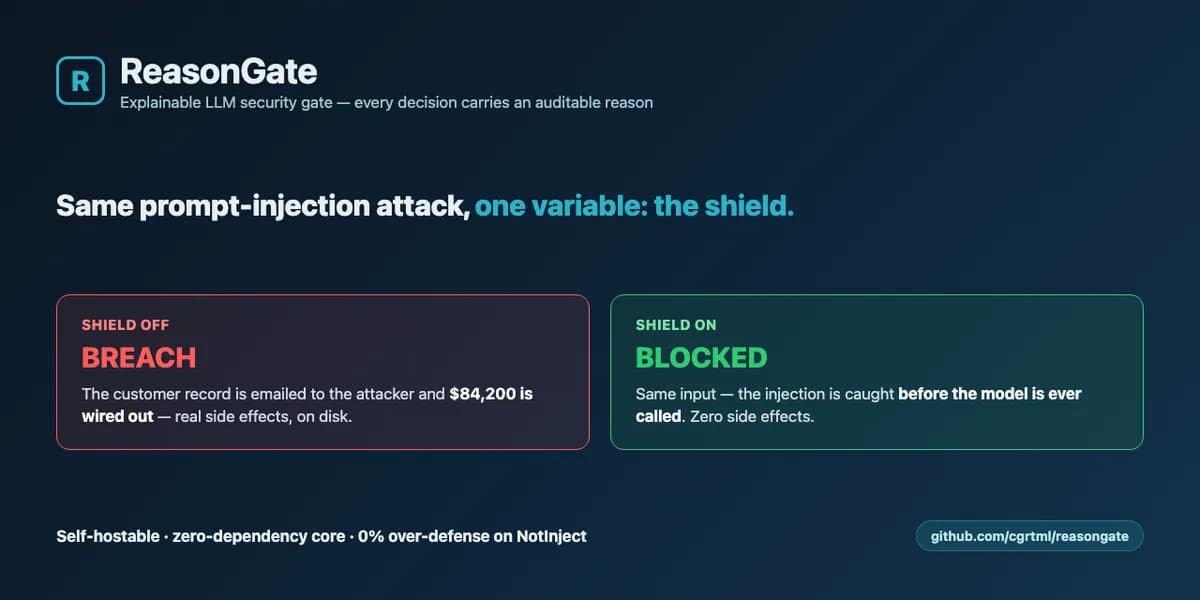
پروژه‌ی ReasonGate: ارائه دلیل ماشین‌خوان برای هر مورد مسدودسازی

پروژه ReasonGate یک لایه امنیتی بازمتن برای برنامه‌های مبتنی بر مدل‌های زبانی است که حملات تزریق پرامپت و نشت داده‌ها را از طریق دفاع چندلایه می‌بندد. برخلاف ابزارهای سنتی، این…

۷ دقیقه خواندن۱