پرش به محتوای اصلی

موضوع

آموزش توزیع‌شده

روشی برای آموزش مدل‌های هوش مصنوعی با استفاده از چندین پردازنده یا سرور به‌صورت همزمان

۹۰ مقاله منتشر شده

ارزش Etched به ۱۰.۳ میلیارد دلار رسید؛ به چالش کشیدن انویدیا با سخت‌افزار تخصصی

استارت‌آپ سخت‌افزاری Etched با جذب ۳۰۰ میلیون دلار سرمایه در راند Series C، ارزش خود را در هفت ماه به ۱۰.۳ میلیارد دلار رساند. این شرکت با طراحی تراشه‌هایی که صرفاً برای استنتاج…

۵ دقیقه خواندن
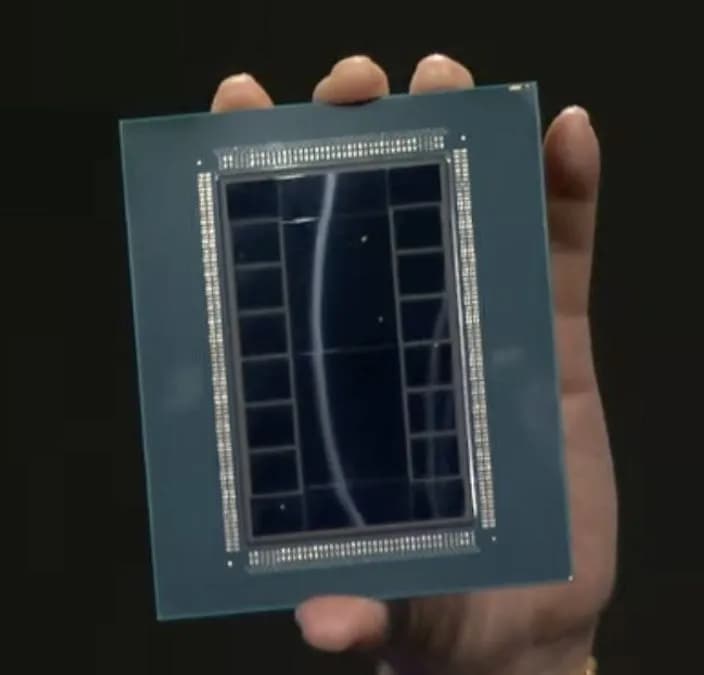
تغییر معماری MI455X؛ افزایش رجیسترهای VGPR برای تقابل با Blackwell

تحلیل کدهای LLVM از معماری جدید شتاب‌دهنده‌های سری MI400 شرکت AMD پرده برداشت. مدل MI455X با افزایش چشمگیر تخصیص رجیستر و یکپارچه‌سازی حافظهٔ کش، قصد دارد کارایی استنتاج مدل‌های…

۱۳ دقیقه خواندن۱
آموزش کاربردی

چطور NeMo Automodel محدودیت‌های مقیاس‌پذیری در مدل‌های پخش را برطرف می‌کند؟

کتابخانه NeMo Automodel با ادغام در Diffusers، امکان تنظیم دقیق مدل‌های عظیم تصویر و ویدیو را بدون نیاز به تبدیل فرمت وزن‌ها فراهم کرد. این ابزار آموزش توزیع‌شده در مقیاس صنعتی را…

۸ دقیقه خواندن۱
آموزش کاربردی

Flash-MSA هزینه آموزش مدل‌های میلیون‌توکنی را با هسته‌های پراکنده کاهش داد

پیاده‌سازی متن‌باز جدیدی از توجه پراکنده Minimax (MSA)، آموزش مدل‌ها با پنجره‌های متنی میلیونی را روی GPUهای Hopper و Blackwell ممکن کرد. این ابزار با استفاده از پراکندگی بلوکی و…

۹ دقیقه خواندن۲
آموزش کاربردی

«تبدیل مدل عمومی به عامل منطقی»؛ دستاورد جدید در تنظیم دقیق Gemma-3

یک گردش‌کار فنی جدید نشان می‌دهد چگونه می‌توان مدل Gemma-3 گوگل را با استفاده از بهینه‌سازی سیاست نسبی گروهی (GRPO) و آداپتورهای لورا برای ریاضیات تنظیم دقیق کرد. این فرآیند یک…

۸ دقیقه خواندن۲