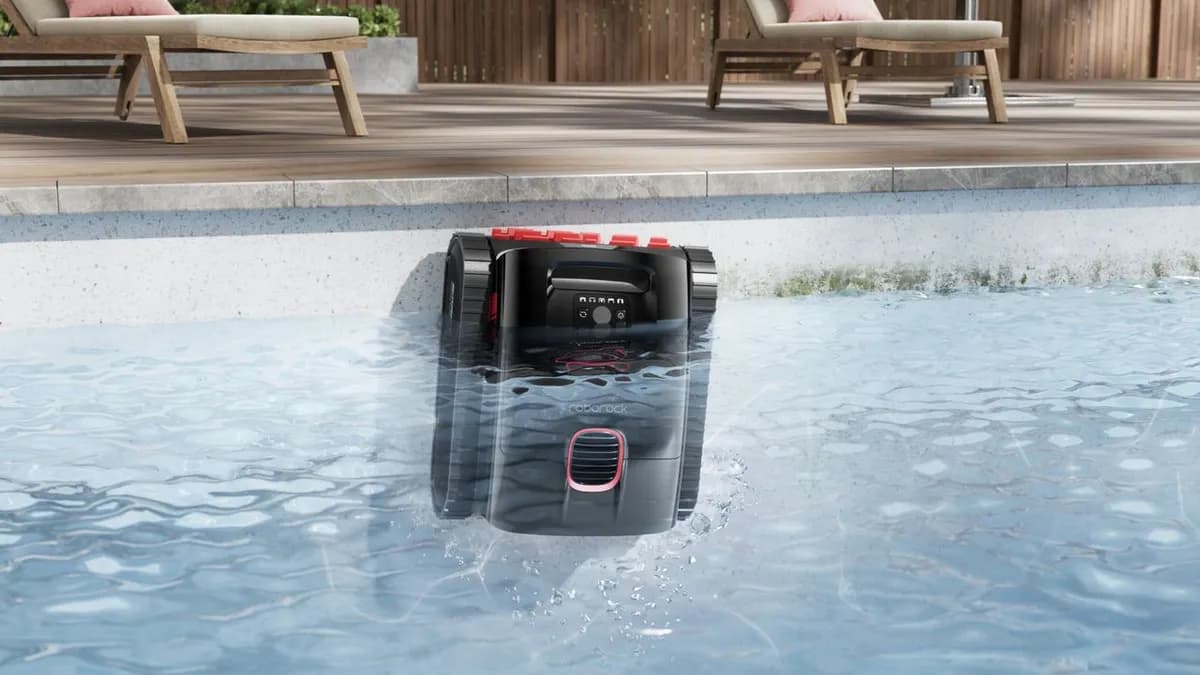
IFA ۲۰۲۶: ورود روبوراک به بازار رباتهای نظافت فضای باز
شرکت روبوراک با معرفی جاروبرقی استخر RockAqua Q1 و ماشینزن RockNeo Q2، قلمرو خود را از کف خانه به حیاط گسترش داد. تمرکز این محصولات بر حذف سیمهای مرزی از طریق ناوبری مبتنی بر…
۳ دقیقه خواندن
موضوع
SLMs, on-device inference, mobile AI, AI PCs
۲٬۰۴۹ مقاله منتشر شده
شرکت روبوراک با معرفی جاروبرقی استخر RockAqua Q1 و ماشینزن RockNeo Q2، قلمرو خود را از کف خانه به حیاط گسترش داد. تمرکز این محصولات بر حذف سیمهای مرزی از طریق ناوبری مبتنی بر…
انویدیا با معرفی سوپرچیپ RTX Spark N1X، معماری Arm را به اکوسیستم ویندوز میآورد تا اجرای محلی عاملهای هوش مصنوعی را ممکن کند. این تراشه که در لپتاپهای لنوو، دل و ایسوس عرضه…
یک تحلیل فنی فاش میکند که چگونه میتوان با دور زدن محدودیتهای وب و تقلید از API خصوصی اندروید، میلیاردها داده از تیکتاک استخراج کرد. این سیستم با عبور از چهار لایه امنیتی…
یک دستورالعمل تنظیم دقیق سبک با استفاده از GRPO، توانایی مدل کوچک ۳۵۰ میلیون پارامتری را در پیروی از طرحهای JSON و YAML بهشدت بهبود بخشید. این فرآیند تنها با ۱۰۰ گام آموزشی و…
توسعهدهندهای به نام gulding با ساخت مدل EmsyAI (V4) از صفر، چالشهای پایداری در مقیاسبندی مدلهای زبانی را بررسی کرد. این پروژه نشان میدهد که مدلهای بسیار کوچک حتی در صورت…
سامانه Antigravity CLI با ترکیب دادههای هزاران ایستگاه هواشناسی خانگی و عاملهای هوش مصنوعی Gemini، فورانهای آتشفشانی را پیشبینی میکند. این سیستم میتواند هشدارهای اضطراری را…
مدل باز Spark-X2.5-4B با وجود اندازه کوچک، در وظایف عاملمحور، ریاضیات و کدنویسی عملکردی مشابه مدلهایی با اندازه سه برابر خود نشان داد. این مدل در چندین محک کلیدی، رقبایی چون…
استارتاپ کرهای VIDRAFT سرویس AI Foundry را برای بهینهسازی و استقرار امن مدلهای هوش مصنوعی در محیطهای ایزوله (Air-gapped) معرفی کرد. این پلتفرم با تمرکز بر صنایع حساس،…
استارتاپ Mostik روشی را ابداع کرده که مدلهای هوش مصنوعی بهجای تبادل متن، از طریق مقادیر ریاضی وزنها با یکدیگر ارتباط برقرار کنند. این تکنیک به مدلهای کوچک اجازه میدهد هوشمندی…
شرکت Reliance Jio دسترسی به سرویس رایانههای ابری خود را برای تمام کاربران اینترنت هند باز کرد. این اقدام به کاربران اجازه میدهد با پرداخت اشتراک، اپلیکیشنهای مدرن هوش مصنوعی را…
پروژه WebLLM با بهرهگیری از استاندارد WebGPU، امکان اجرای کامل مدلهای زبانی بزرگ را بدون نیاز به سرور و مستقیماً در مرورگر فراهم میکند. این رویکرد با حذف پردازشهای ابری، حریم…
کوانتایزیشن با کاهش دقت عددی وزنها و فعالسازها، مصرف حافظه و انرژی را بهشدت کم میکند. برخلاف هرس کردن، این روش ساختار مدل را حفظ کرده و سرعت استنتاج را روی سختافزارهای لبه…