پرش به محتوای اصلی

موضوع

چندوجهی

Models that natively process text+image+audio+video

۱٬۶۶۴ مقاله منتشر شده

زندگی با AI

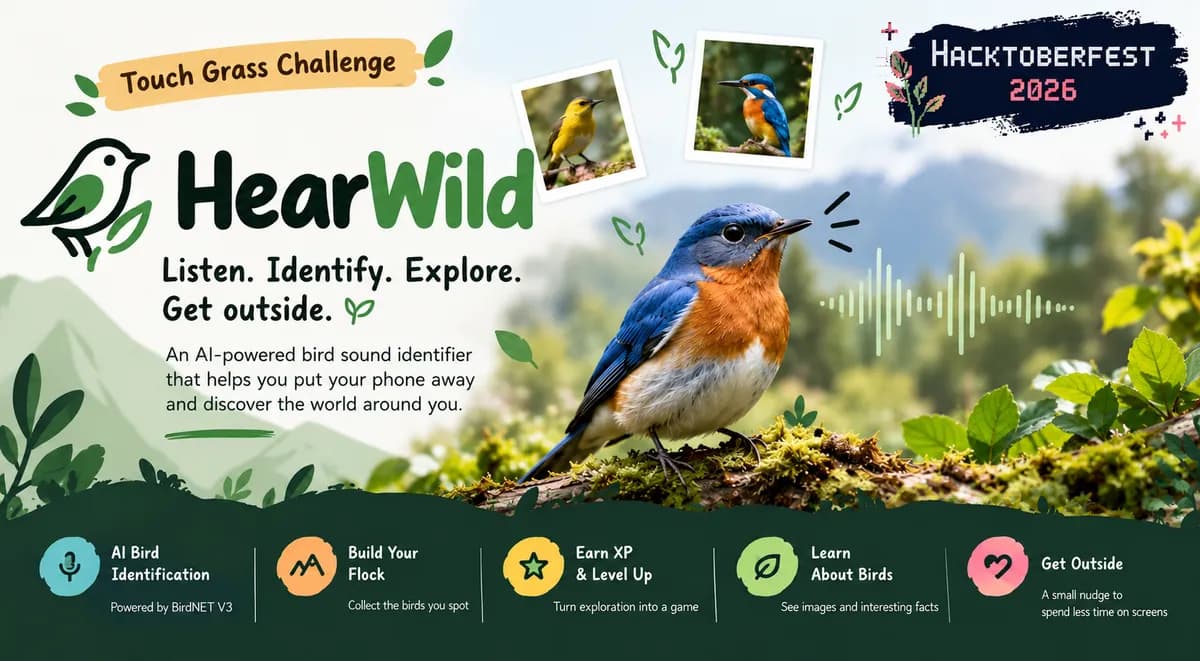
درون سامانهٔ Đi đây؛ ترکیب غربالگری خودکار و نظارت تصویری بر کاربر

یک توسعه‌دهنده با استفاده از مدل Gemma 4 سامانه «Đi đây» را ساخت تا لیست‌های جایزه و هکاتون‌ها را به‌صورت خودکار غربال کند. این سیستم برای جلوگیری از اعتیاد دیجیتال، نتایج را تنها…

۸ دقیقه خواندن
آموزش کاربردی

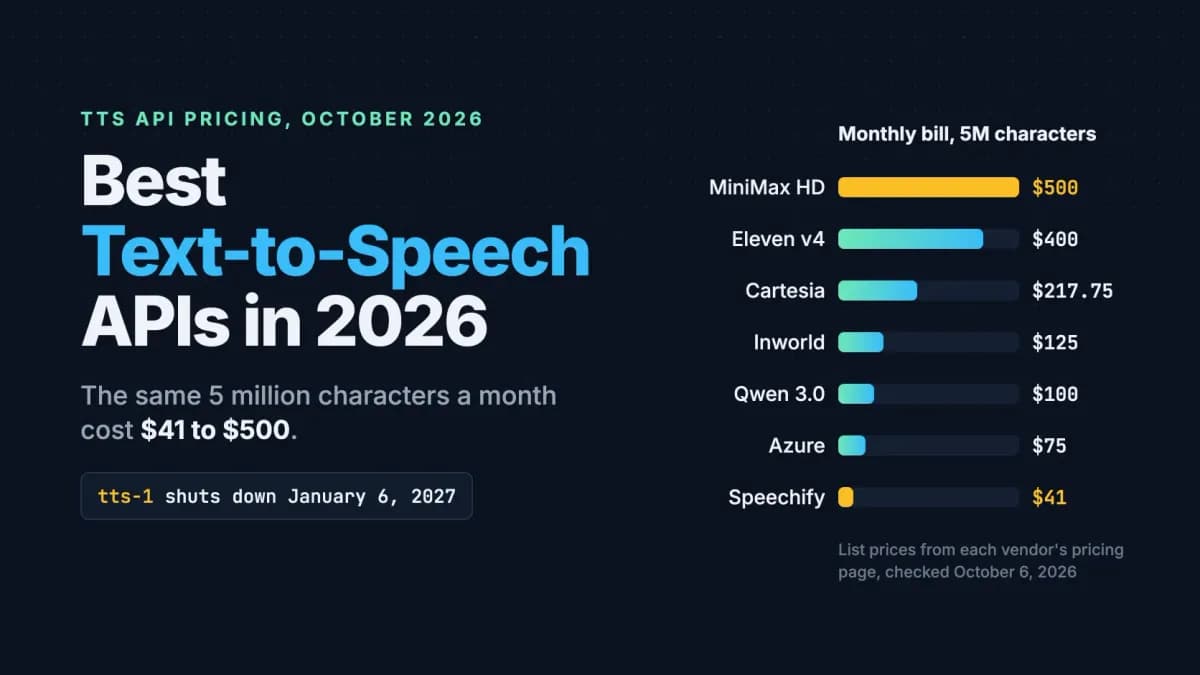
استقرار Wrapper ای‌پی‌آی ElevenLabs روی سرور مجازی برای دسترسی ۲۴ ساعته

یک راهنمای فنی جدید روش انتقال سرویس‌های تبدیل متن به گفتار از محیط محلی به سرورهای VPS را بررسی می‌کند. توسعه‌دهندگان با ایجاد یک Wrapper بر پایه Flask، می‌توانند دسترسی دائمی و…

۵ دقیقه خواندن
آموزش کاربردی

«تمرکز بر استدلال شفاهی»؛ رویکرد جدید DeepOffer در مصاحبه‌های فنی

پلتفرم DeepOffer با بهره‌گیری از تعاملات صوتی زنده، محیط پرفشار مصاحبه‌های مهندسی یادگیری ماشین را بازسازی می‌کند. این ابزار به‌جای پرسش‌وپاسخ‌های متنی، بر توانایی استدلال شفاهی…

۲ دقیقه خواندن

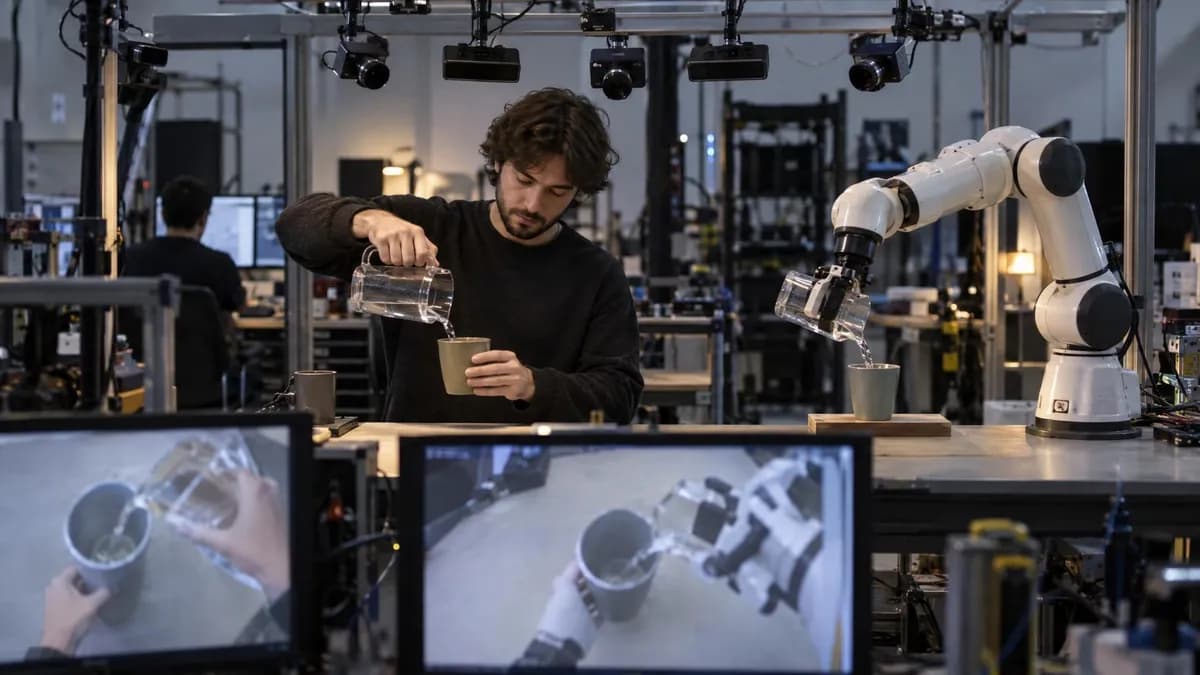
سرمایه‌گذاری ۶۰ میلیون دلاری Mecka برای ساخت لایهٔ دادهٔ هوش مصنوعی فیزیکی

شرکت Mecka با جذب ۶۰ میلیون دلار سرمایه در دور سری B، زیرساختی برای ثبت حرکات انسانی و نیروهای لمسی جهت آموزش ربات‌ها ایجاد می‌کند. هدف این شرکت تبدیل داده‌های فیزیکی به بازاری…

۴ دقیقه خواندن
آموزش کاربردی

چگونه TokenSaver مصرف توکن‌های تصویری را در لایهٔ مرورگر کنترل می‌کند؟

افزونهٔ TokenSaver با بهینه‌سازی ابعاد اسکرین‌شات‌ها پیش از ارسال به مدل‌های هوش مصنوعی، مصرف توکن را کاهش و حریم خصوصی توسعه‌دهندگان را حفظ می‌کند. این ابزار پردازش تصاویر را…

۳ دقیقه خواندن

پژوهش NVIDIA: دسترسی به ابزارها شکست‌های ایمنی را ۶۸.۷٪ افزایش داد

پژوهش جدید انویدیا نشان می‌دهد مدل‌های چندوجهی هنگام دسترسی به ابزارها، حفاظ‌های ایمنی خود را نادیده می‌گیرند. این مطالعه «رقیق‌شدن زمینه» و «جابه‌جایی تمرکز ایمنی» را عامل اصلی…

۷ دقیقه خواندن۱