پرش به محتوای اصلی

موضوع

چندوجهی

Models that natively process text+image+audio+video

۱٬۶۶۴ مقاله منتشر شده

آیا مدل دسا می‌تواند بدون متن، مکالمه انسانی را درک کند؟

بلاک مدل گفتاری دسا را منتشر کرد که بدون پیش‌آموزش متنی، صرفاً از مکالمه‌های انسانی زبان یاد گرفته است. دسا به‌صورت کامل‌دو طرفه (full-duplex) روی مک‌بوک پرو M4 ماکس اجرا می‌شود،…

۵ دقیقه خواندن

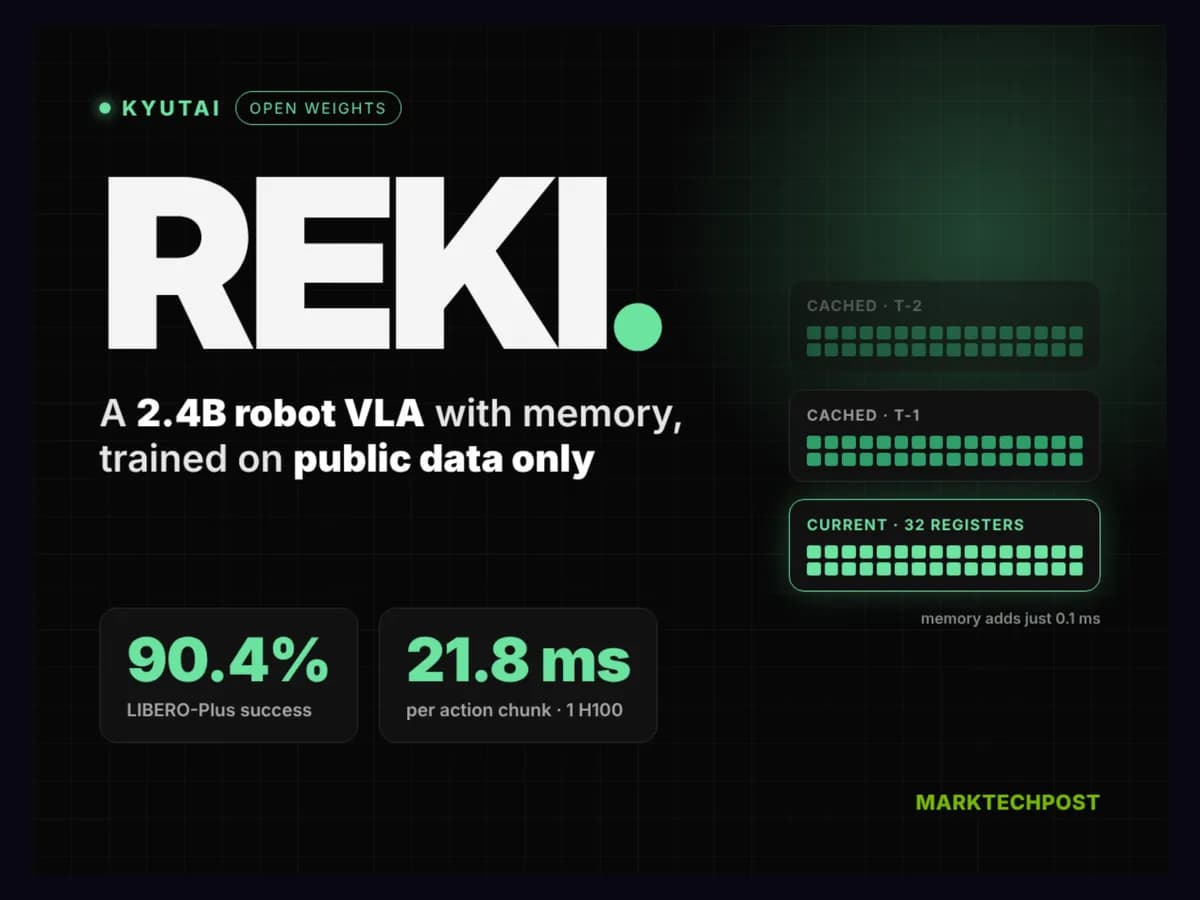
مدل REKI با حافظهٔ ثبت‌محور دقت ربات‌ها را در محک LIBERO-Plus به ۹۰.۴٪ رساند

شرکت Kyutai مدل REKI را معرفی کرد؛ یک مدل بینایی-زبانی-کنشی (VLA) کوچک که با استفاده از سیستم حافظهٔ جدید، لرزش بازوی ربات‌ها را کاهش می‌دهد. این مدل با تکیه بر داده‌های عمومی، در…

۴ دقیقه خواندن
آموزش کاربردی

ReelMint میزبانان مجازی AI را برای استریم‌های ۲۴ ساعته عرضه کرد

پلتفرم ReelMint ابزارهایی را معرفی کرد که به سازندگان اجازه می‌دهد شخصیت‌های هوش مصنوعی را برای مدیریت پخش زنده در یوتیوب و تیک‌تاک به کار بگیرند. این عامل‌ها می‌توانند چت‌ها را…

۳ دقیقه خواندن