پرش به محتوای اصلی

موضوع

استدلال

Chain-of-thought, reasoning models (o-series, R-series), test-time compute

۲٬۰۴۹ مقاله منتشر شده

Claude Fable 5: جهش در کدنویسی با مکانیسم پنهان تضعیف عملکرد

مدل جدید Fable 5 شرکت آنتروپیک در بنچمارک‌های کدنویسی رکوردهای جدیدی ثبت کرده است، اما طبق مستندات، این مدل به‌طور مخفیانه کیفیت پاسخ‌ها را برای پژوهش‌های هوش مصنوعی کاهش می‌دهد.…

۶ دقیقه خواندن

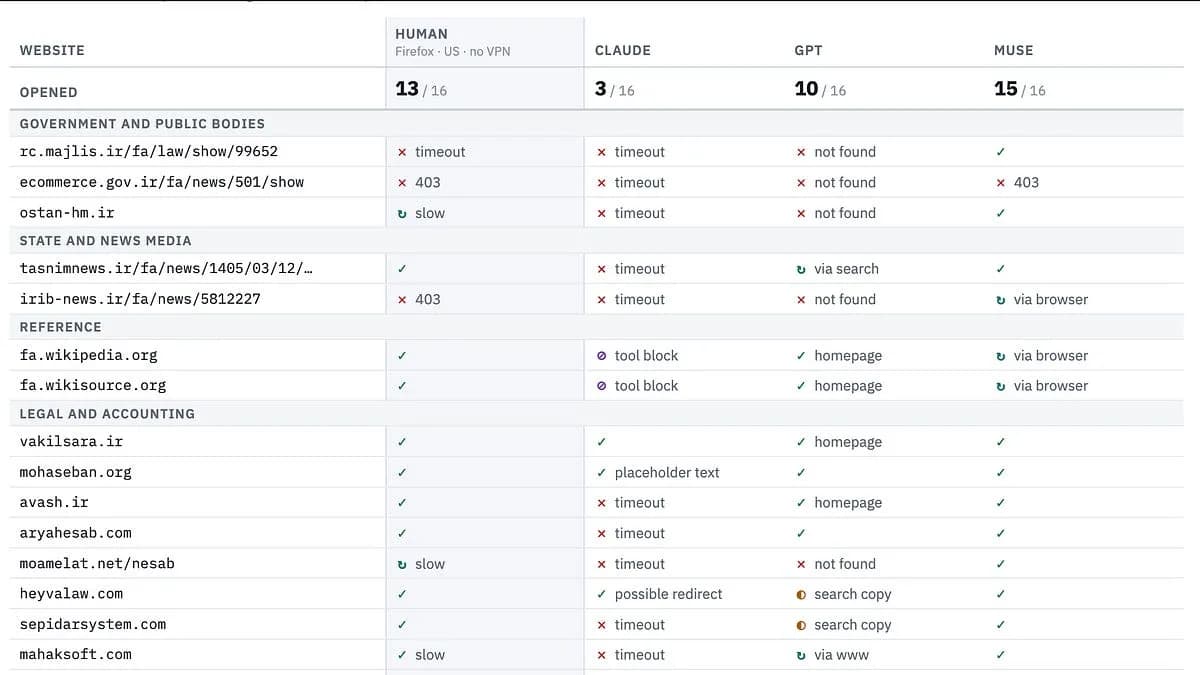
منابع کم‌اعتبار در برابر داده‌های رسمی؛ تفاوت عملکرد مدل‌های فارسی و انگلیسی

تحلیلی فنی روی عملکرد عامل‌های هوش مصنوعی نشان می‌دهد که دسترسی به داده‌های رسمی در زبان فارسی با شکست مواجه است. در حالی که این مدل‌ها در تسک‌های انگلیسی دقت بالایی دارند، در…

۹ دقیقه خواندن۱
آموزش کاربردی

جایگزینی استانداردهای انسانی با محدودیت‌های ماشینی در کدنویسی عامل‌محور

یک توسعه‌دهنده با معرفی چارچوبی برای همکاری عامل‌های هوش مصنوعی، استانداردهای سنتی کدنویسی را «مانع پیشرفت» خواند. او پیشنهاد می‌کند برای حذف توهمات، باید «بهترین تجربیات انسانی»…

۱۳ دقیقه خواندن۱
آموزش کاربردی

لایهٔ تصویرسازی Baize راهکار جدیدی برای درمان فراموشی عامل‌های هوش مصنوعی

نسخه ۰.۳.x ابزار Baize با معرفی «لایهٔ تصویرسازی» (Projection Layer)، مشکل تحلیل رفتن داده‌های حیاتی در گفتگوهای طولانی را حل کرده است. این روش بدون تخریب تاریخچهٔ اصلی، اطلاعات…

۴ دقیقه خواندن۲
آموزش کاربردی

حلقهٔ تکرار در حافظهٔ عامل‌های هوش مصنوعی باعث تخریب داده‌ها می‌شود

وقتی چندین عامل هوش مصنوعی از یک حافظه مشترک استفاده می‌کنند، ممکن است در چرخه‌ای از اصلاحات متناقض گیر کنند و داده‌ها را تخریب کنند. راهکار جدید با استفاده از لایه میان‌افزار MCP…

۲ دقیقه خواندن
آموزش کاربردی

«جایگزینی آزادی با SOP»؛ راهکار جلوگیری از انفجار توکن‌ها در Claude

یک توسعه‌دهنده با جایگزینی آزادی عمل عامل‌های هوش مصنوعی با دستورالعمل‌های عملیاتی سخت‌گیرانه (SOP) و «گیت‌های» مکانیکی، از انحراف مدل و انفجار توکن‌ها در ساخت یک سیستم‌فایل…

۹ دقیقه خواندن

پروتوتایپ TORos تصمیمات هوش مصنوعی را از طریق مدل‌های متخاصم تأیید می‌کند

شرکت Yukon Systems موتور تصمیم‌گیرنده‌ای به نام TORos ساخته است که به‌جای پذیرش اولین پاسخ، مدل‌های مختلف را به بحث و تقابل وادار می‌کند. این سیستم با شبیه‌سازی یک دادگاه، اجماع…

۲ دقیقه خواندن۱
آموزش کاربردی

ترکیب کد قطعی و مدل زبانی هزینهٔ ارزیابی پاسخ‌های فنی را ۹۶٪ کاهش داد

یک توسعه‌دهنده با طراحی یک داور ترکیبی (Hybrid Judge) توانست دقت ارزیابی پاسخ‌های هوش مصنوعی را به سطح انسانی برساند و هزینهٔ هر پاسخ را از ۸۰ سنت به ۳ سنت کاهش دهد. این سیستم با…

۷ دقیقه خواندن۱
آموزش کاربردی

پرسش‌های سقراطی در برابر دستورات مستقیم؛ راهکارهای نوین برای کاهش رگرسیون

دستورات مستقیم به عامل‌های هوش مصنوعی اغلب منجر به اصلاحات سطحی و خطاهای زنجیره‌ای می‌شود. جایگزینی دستور با پرسش‌های سقراطی، مدل را مجبور به شبیه‌سازی علت و معلول می‌کند و منجر…

۱۶ دقیقه خواندن