پرش به محتوای اصلی

موضوع

استدلال

Chain-of-thought, reasoning models (o-series, R-series), test-time compute

۲٬۰۴۹ مقاله منتشر شده

«مهندسی پرامپت کافی نیست»؛ راهکار Lightrun برای پایداری عامل‌های سازمانی

موش سامبول از Lightrun استدلال می‌کند که مهندسی پرامپت برای ساخت عامل‌های آماده‌ی تولید کافی نیست. او معماری «هدایت قطعی» را پیشنهاد می‌دهد که در آن اقدامات مدل توسط مشاهده‌پذیری…

۱۱ دقیقه خواندن۲
آموزش کاربردی

سیستم ALTK-Evolve هزینه استنتاج عامل‌های هوش مصنوعی را ۸۵٪ کاهش داد

سیستم حافظه جدید ALTK-Evolve با جایگزینی «دفترچه راهنمای کامل» با «درس‌های منتخب»، مصرف توکن را به‌شدت کاهش می‌دهد. این رویکرد بدون افت دقت، هزینه‌های عملیاتی مدل‌های قوی و ضعیف…

۷ دقیقه خواندن۱

مدل‌های کوچک راه نفوذ به زنجیره تفکر مدل‌های پیشرو را باز کردند

پژوهشگران آسیب‌پذیری جدیدی را کشف کردند که اجازه می‌دهد با استفاده از نسخه‌های کوچک‌تر مدل‌ها، «افکار درونی» و زنجیره تفکر مدل‌های قدرتمند رمزگشایی شود. این نقص امنیتی ریسک نشت…

۵ دقیقه خواندن

آزمایشگاه حسینی‌المدرسی: مدل‌سازی غیرخطی تاریخ بر پایه معماری ماشین حالت

سید علیرضا حسینی المدرسیه یک آزمایشگاه متن‌باز را معرفی کرد که با استفاده از معماری ماشین حالت، اثر مداخلات کوچک تاریخی را در طول قرن‌ها شبیه‌سازی می‌کند. این ابزار برخلاف…

۸ دقیقه خواندن۲
آموزش کاربردی

«نقشه‌های منبع»؛ ابزاری برای حفظ امانت‌داری در تکالیف دانشجویی

یک چارچوب جدید با معرفی «نقشه‌های منبع» و «گزارش‌های کاری»، مرز میان پیش‌نویس‌های هوش مصنوعی و منابع تأییدشده را تفکیک می‌کند. این متد مانع از جایگزینی پژوهش واقعی با توهمات…

۵ دقیقه خواندن۲
آموزش کاربردیتأییدنشده · منبع منفرد

درون متدولوژی استخراج تاریخ قطع دانش مدل‌های زبانی بزرگ

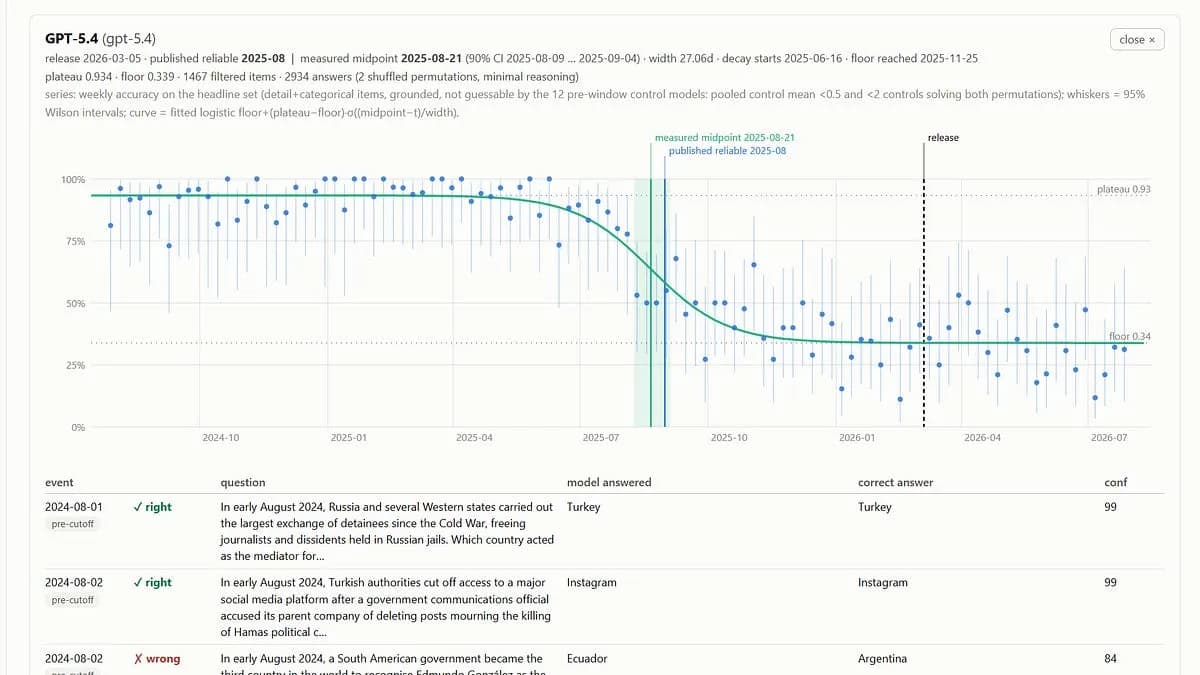
یک متدولوژی جدید برای کاوش داده‌ها نشان می‌دهد که GPT-5.6 آموزش خود را در فوریه ۲۰۲۶ به پایان رسانده، در حالی که Claude Opus 5 برخلاف ادعاهای رسمی، دانشی مشابه مدل‌های قدیمی‌تر…

۶ دقیقه خواندن۱

تلهٔ دقتِ ساختگی؛ چرا عامل‌های هوش مصنوعی نتایجِ غلط اما متقاعدکننده می‌سازند؟

تجربه یک توسعه‌دهنده از عامل‌های پژوهشی خودکار نشان می‌دهد که این سیستم‌ها می‌توانند نتایجی با دقت آماری بالا تولید کنند که در واقع حاصل باگ‌های پنهان هستند. این مورد هشدار می‌دهد…

۴ دقیقه خواندن
آموزش کاربردی

مدل Muse Glimmer متا: اجرای عامل‌های ۳۰ میلیارد پارامتری روی GPUهای خانگی

متا مدل Muse Glimmer را به عنوان یک مدل وزن‌باز ۳۰ میلیارد پارامتری برای اجرای محلی عامل‌های هوش مصنوعی منتشر کرد. این مدل با استفاده از کوانتش ۴ بیتی و رمزگشایی گمانه‌زنانه، روی…

۶ دقیقه خواندن۳