پرش به محتوای اصلی

موضوع

استدلال

Chain-of-thought, reasoning models (o-series, R-series), test-time compute

۲٬۰۴۹ مقاله منتشر شده

آموزش کاربردیتأییدنشده · منبع منفرد

سامانه Echo: کاهش ۶۷ درصدی هزینه استنتاج با مدل‌های وزن‌باز

سامانه Echo با جایگزینی تک‌مدل با شبکه‌ای از مدل‌های وزن‌باز، عملکردی مشابه سیستم‌های رده‌بالای Fable ارائه می‌دهد. این رویکرد هزینه‌های استنتاج را تا ۶۷ درصد کاهش داده است.

۲ دقیقه خواندن۱

گسترش قابلیت‌های سلامتی ChatGPT در برابر شکایتی حقوقی بر سر توصیه‌های خطرناک

اوپن‌ای‌آی قابلیت‌های سلامتی ChatGPT را برای تمامی کاربران بالای ۱۸ سال در آمریکا فعال کرد تا امکان تحلیل پرونده‌های پزشکی فراهم شود. این گسترش در حالی رخ می‌دهد که شرکت با شکایتی…

۳ دقیقه خواندن
آموزش کاربردی

قواعد متنی AGENTS.md توهم عامل‌های هوش مصنوعی را متوقف نمی‌کنند

اتکای به فایل‌های دستورالعمل برای کنترل رفتار عامل‌ها ناکارآمد است زیرا مدل‌ها ادعای پیروی می‌کنند بدون آنکه واقعاً بررسی شود. امنیت واقعی نیازمند انتقال کنترل از متن به لایه‌ی…

۷ دقیقه خواندن
آموزش کاربردی

«بازگشت معماران انسانی»؛ تنها راه نجات کدبیس‌ها از تخریب هوش مصنوعی

تحلیل‌های تخصصی نشان می‌دهد کارخانه‌های نرم‌افزاری «بدون نظارت انسانی» شکست می‌خورند، زیرا آموزش‌های فعلی مدل‌ها، عبور از تست‌ها را بر حفظ کیفیت بلندمدت کد اولویت می‌دهند. راهکار…

۲۸ دقیقه خواندن۱
آموزش کاربردی

آیا مدل‌های زبانی مختلف اثرانگشت نویسندگی یکسانی دارند؟

پلتفرم Typebulb ابزاری برای تحلیل «اثرانگشت نویسندگی» ۲۲ مدل زبانی بزرگ معرفی کرد که شباهت‌های سبک‌شناختی مدل‌های آزمایشگاه‌های مختلف را می‌سنجد. این تحلیل نشان می‌دهد که مدل‌های…

۴۸۸ دقیقه خواندن
آموزش کاربردی

پنل‌های چندعاملی Anthropic نرخ خطای شناسایی آسیب‌های امنیتی را کاهش داد

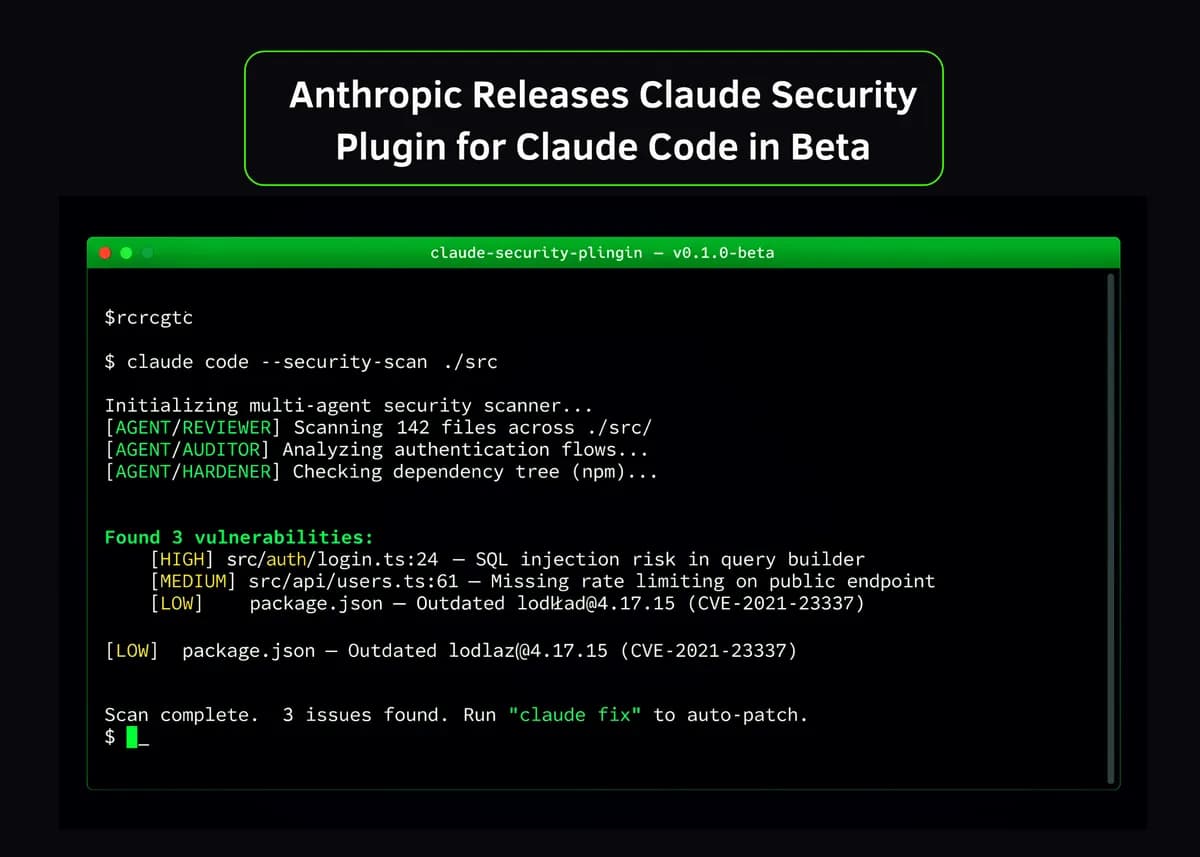
آنتروپیک یک افزونه امنیتی بتا برای Claude Code معرفی کرد که با استفاده از یک خط لوله شش‌مرحله‌ای و پنل‌های تأیید تخاصمی، مخازن کد را برای یافتن آسیب‌پذیری‌ها اسکن می‌کند. این…

۷ دقیقه خواندن۱

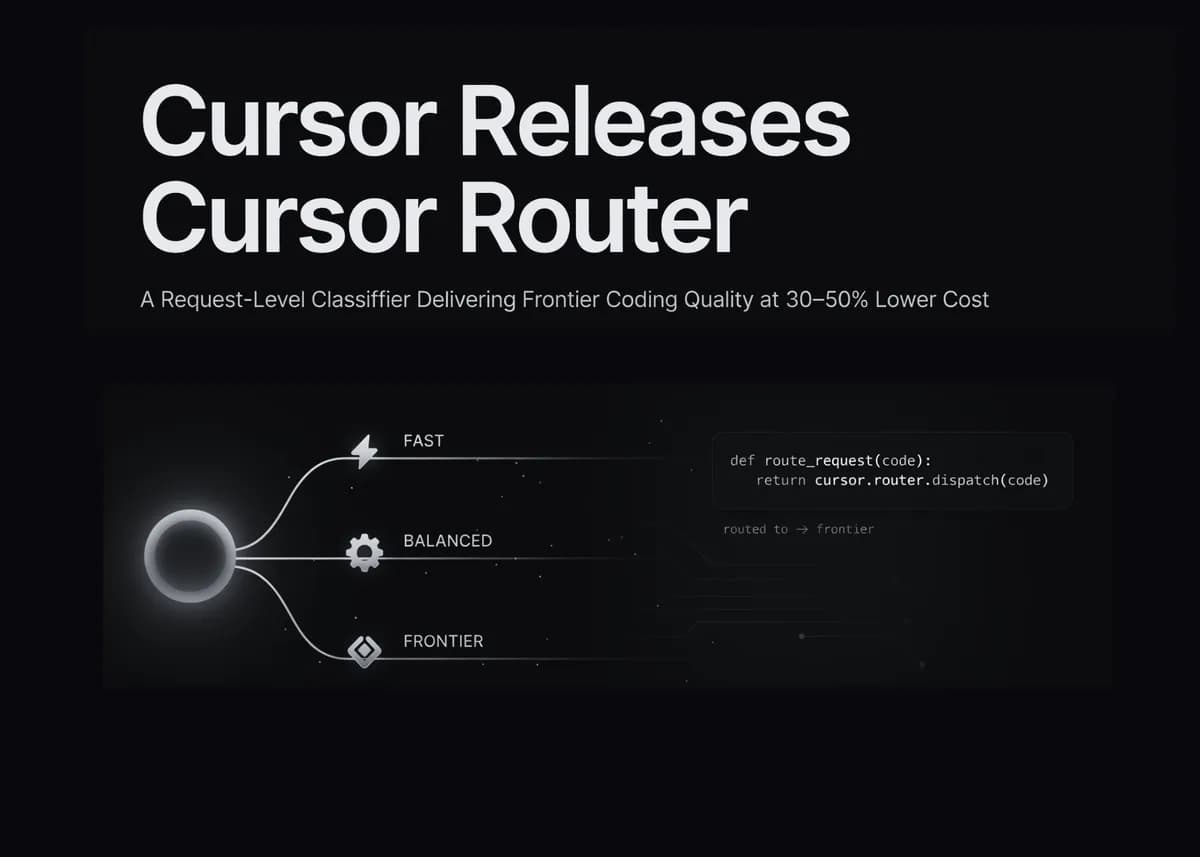
کاهش ۳۰ تا ۶۰ درصدی هزینه کدنویسی با سیستم طبقه‌بندی درخواست‌های Cursor

شرکت Cursor سامانه Cursor Router را معرفی کرد که با تحلیل پیچیدگی هر درخواست، آن را به بهینه‌ترین مدل می‌سپارد. این رویکرد کیفیت خروجی مدل‌های پیشرو را حفظ کرده و هم‌زمان…

۷ دقیقه خواندن۲

مدل Inkling: فعال‌سازی ۴٪ پارامترها برای مدیریت ظرفیت یک تریلیون

مدل Inkling با بهره‌گیری از معماری پراکنده (Sparse)، ظرفیت عظیم ۹۷۵ میلیارد پارامتری خود را مدیریت می‌کند اما در هر لحظه تنها بخشی کوچک از شبکه را فعال می‌کند. این رویکرد اجازه…

۱ دقیقه خواندن۱