پرش به محتوای اصلی

موضوع

بازتولیدپذیری هوش مصنوعی

گزارش‌ها و تحلیل‌های مربوط به توانایی تکرار و تأیید نتایج پژوهش‌های هوش مصنوعی

۲۲۶ مقاله منتشر شده

معیار سنجش حافظه‌ای که تا حد ممکن عادلانه ساختم. ۱۵ ستاره، ۰ اجرا. مشکلش چیست؟

بنچمارک Glasshouse: هزینهٔ بالای ارزیابی حافظه مانع از مشارکت توسعه‌دهندگان شد

پروژه Glasshouse برای سنجش دقیق حافظه بلندمدت هوش مصنوعی طراحی شده، اما با وجود استقبال در گیت‌هاب، هیچ توسعه‌دهنده‌ای آن را اجرا نکرده است. این اتفاق شکاف عمیق میان علاقه به…

۲ دقیقه خواندن۲
۵۸ تست سبز، یک غریبه: چگونه یک شاهد بیرونی، فیلد جعلی را در پاسخ‌های A2A ما یافت.

درون نقص فنی نسخه ۱.۴؛ ابزاری برای اعتبارسنجی واقعی پاسخ‌های A2A

یک نقص امنیتی در متادیتای پاسخ‌های عامل‌های A2A کشف شد که با وجود پاس کردن ۵۸ تست داخلی، داده‌های جعلی ارسال می‌کردند. این یافته منجر به بازبینی جامع مشخصات فنی (نسخه ۱.۴) و ابداع…

۵ دقیقه خواندن۱
سه مدل تعبیه ۱۰۲۴ بعدی، سه دستگاه مختصات
آموزش کاربردی

چرا جایگزینی مدل‌های امبدینگ بدون هشدار سیستم، داده‌ها را فاسد می‌کند؟

استفاده از مدل‌های متفاوت برای ایندکس‌گذاری و پرس‌وجو، نتایج جست‌وجو را به نویز تبدیل می‌کند. این شکست بدون هیچ خطا یا هشدار سیستمی رخ می‌دهد و خطری جدی برای خط لوله‌های RAG است.

۴ دقیقه خواندن۱
الگوی چت باعث می‌شود ۸ مدل زبانی بزرگ از تعهد مسئولیت شانه خالی کنند

درون بردارهای فعال‌سازی؛ سازوکار حذف لحن مصنوعی در مدل‌های زبانی

پژوهشی جدید نشان می‌دهد جملات سلب مسئولیت رایج در مدل‌های زبانی، نه حاصل وزن‌های داخلی مدل، بلکه نتیجه‌ی قالب‌های چت (Chat Templates) هستند. محققان با دست‌کاری بردارهای فعال‌سازی…

۹ دقیقه خواندن۴
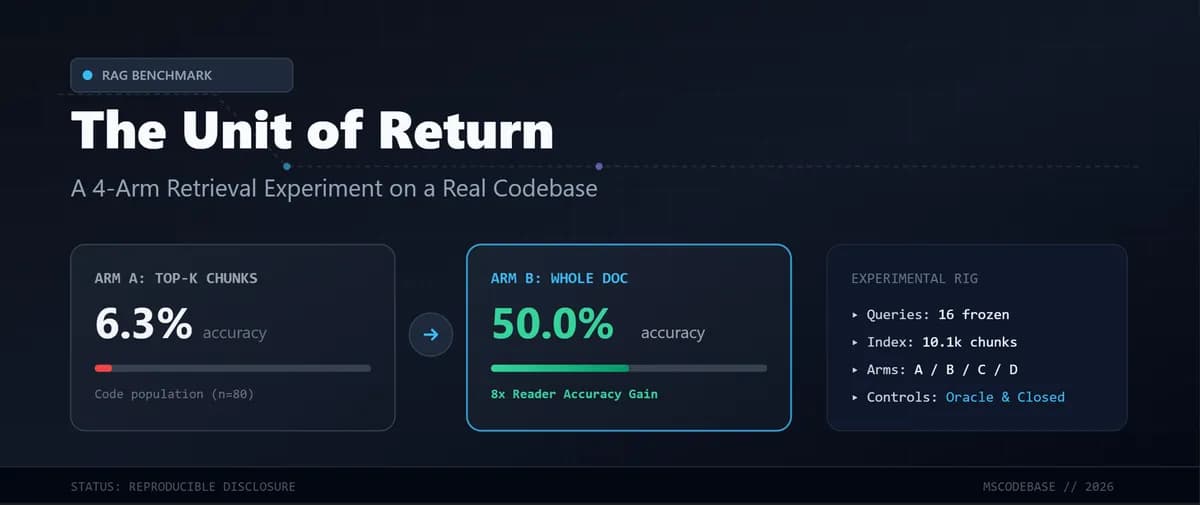
آزمایش بازیابی چهاربازویی در یک پایگاه کد واقعی: واحد بازگشت
آموزش کاربردی

بازیابی کامل اسناد صحت پاسخ‌های کدنویسی هوش مصنوعی را ۸ برابر کرد

یک آزمایش کنترل‌شده روی کدهای واقعی نشان می‌دهد که ارسال کل سند به‌جای تکه‌های کوچک، دقت مدل‌های زبانی را در پرس‌وجوهای برنامه‌نویسی ۸۰۰٪ افزایش می‌دهد. این یافته ثابت می‌کند…

۱۰ دقیقه خواندن
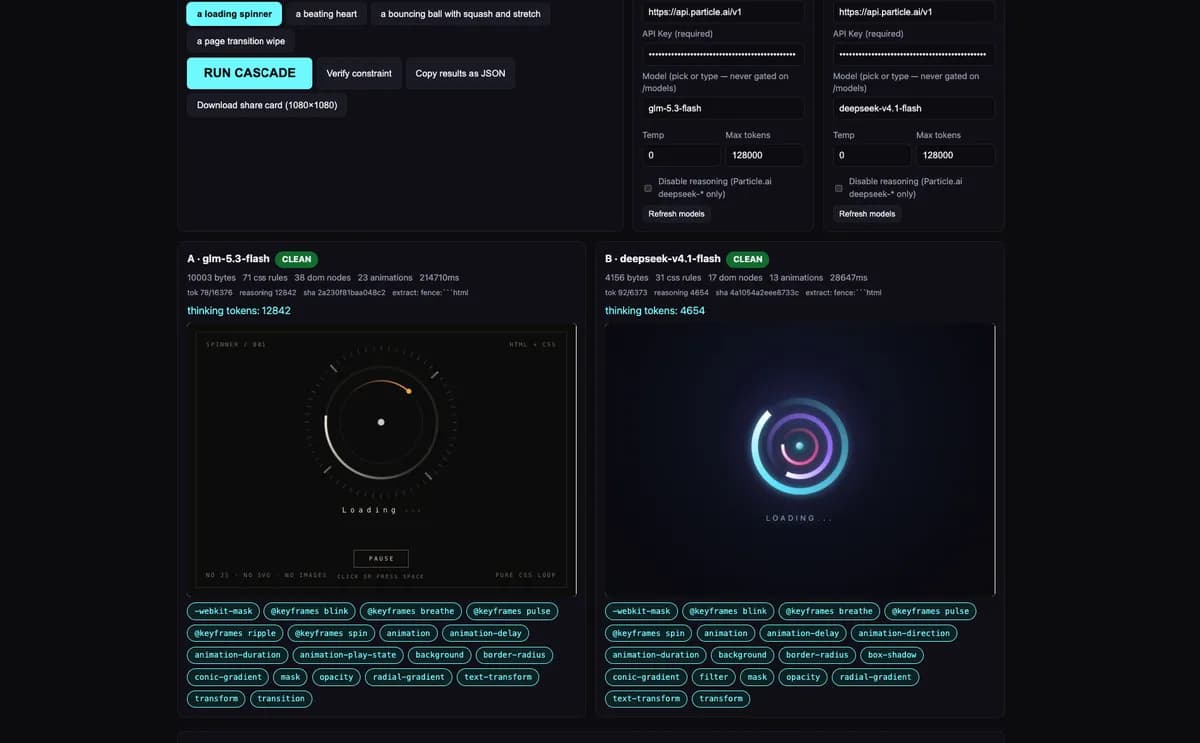
اثبات ارتقای مدل با CSS و موتور اسکریپت غیرفعال
آموزش کاربردی

انیمیشن‌های خالص CSS در برابر JS؛ محک سخت‌گیرانه برای هوش مصنوعی

ابزار جدید Cascade با اجبار مدل‌ها به ساخت انیمیشن‌های خالص CSS و حذف کامل جاوااسکریپت، یک محک سخت‌گیرانه برای سنجش توانایی واقعی کدنویسی ایجاد کرده است. این سامانه مقایسه‌های…

۷ دقیقه خواندن
اثبات معیار سختی صفر p28-zero-diff
آموزش کاربردی

آیا مدل‌های هوش مصنوعی ساده‌ترین اثبات‌های ریاضی را پاس می‌کنند؟

یک بنچمارک مینیمال به نام p28-zero-diff معرفی شده است که توانایی مدل‌های هوش مصنوعی در حل ساده‌ترین اثبات‌های ریاضی را می‌سنجد. این ابزار به جای چالش‌های سخت، به عنوان یک «تست…

۲ دقیقه خواندن
سرور LLM بدون تغییر ۲۷٪ گران‌تر شد
آموزش کاربردی

درون نوسانات هزینه سرور؛ نقش گرمای سخت‌افزار و زمان‌بندی سیستم‌عامل

تحلیلی جدید نشان می‌دهد نویزهای سیستمی مانند گرم شدن سخت‌افزار و زمان‌بندی سیستم‌عامل، نوسانات شدیدی در هزینه‌های استنتاج ایجاد می‌کنند. این یافته ثابت می‌کند مقایسه‌های ساده‌ی…

۷ دقیقه خواندن
معیار سرتاسری افزایش داده چندوجهی و پایداری خصمانه با AugLy برای تصویر، متن، صوت و PyTorch
آموزش کاربردی

کتابخانه AugLy استواری مدل‌های چندوجهی را با داده‌های خصمانه می‌سنجد

AugLy چارچوبی جامع برای ایجاد اختلالات عمدی در داده‌های تصویری، متنی و صوتی است تا نقاط ضعف مدل‌های هوش مصنوعی شناسایی شود. این ابزار با شبیه‌سازی نویزهای دنیای واقعی، به…

۱۶ دقیقه خواندن۲
متا آیرا: از زمین تمرین تا مدال طلای کگل؛ ردیابی عدد به عدد آنچه رخ داد

بهینه‌سازی محیط در برابر قدرت مدل؛ کلید موفقیت سری AIRA

پژوهش‌های سری AIRA در متا نشان می‌دهد که عملکرد عامل‌های هوشمند بیش از آنکه به مدل وابسته باشد، به محیط تمرین و سیاست‌های جست‌وجو بستگی دارد. این رویکرد منجر به کسب رتبه هشتم در…

۳ دقیقه خواندن۲
«ناشناخته» مقدار سوم درستی بود، اما به تنهایی کافی نیست.
آموزش کاربردی

آزمایش عامل‌های AI: وضعیت «نامشخص» نرخ تأییدهای کاذب را کاهش داد

یک آزمایش روی عامل‌های هوش مصنوعی نشان می‌دهد که سیستم‌های دوتایی (قبول/رد) باعث ایجاد «تأییدهای کاذب» می‌شوند. افزودن وضعیت سوم یعنی «نامشخص»، شکست‌های پنهان در تطبیق الگوها و…

۷ دقیقه خواندن