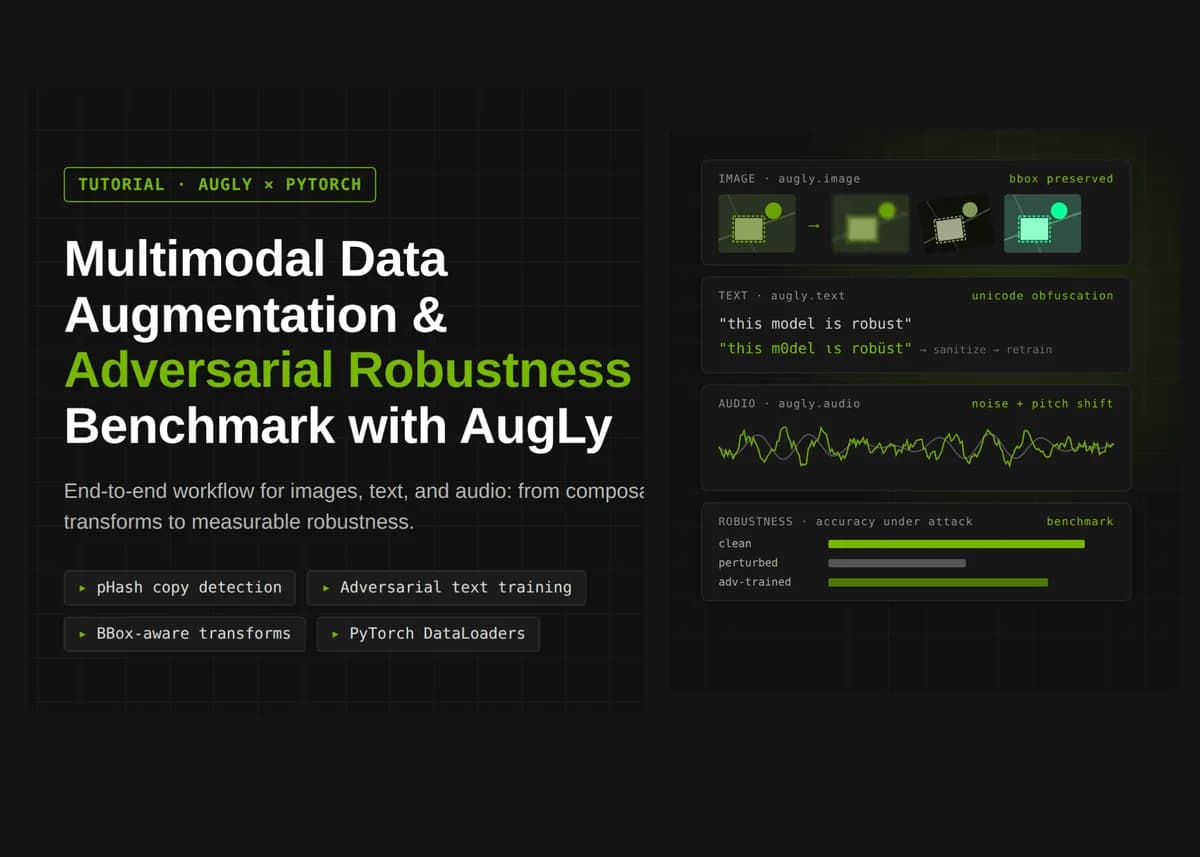
تصور کنید یک مدل هوش مصنوعی پیشرفته که در محیط تولید قرار دارد، تنها با یک تغییر کوچک در تصویر یا اضافه شدن چند کاراکتر نامرئی یونیکد در متن، کاملاً کور شود و پاسخهای غلط بدهد. برای جلوگیری از چنین فروپاشیهای ناگهانی و فاجعهباری، توسعهدهندگان اکنون میتوانند از AugLy استفاده کنند؛ یک کتابخانه جامع برای افزایش دادههای چندوجهی (Multimodal Data Augmentation) که اجازه میدهد مدلها را در محیطی کنترلشده و سیستماتیک «بشکنید» تا مطمئن شوید در مواجهه با پیچیدگیهای دنیای واقعی دوام میآورند.
بیشتر مدلهای هوش مصنوعی روی مجموعهدادههای «پاک» و ایدهآل آموزش میبینند، اما واقعیت محیط عملیاتی آشفته است. تصاویر فشرده میشوند، متنها پر از غلط املایی و تغییرات عمدی هستند و صداها با لایههای مختلف نویز محیطی ترکیب میشوند. این شکاف عمیق میان محیط آزمایشگاه و واقعیت، بحرانی در استواری خصمانه (Adversarial Robustness) ایجاد کرده است؛ وضعیتی که در آن مدل در محیط تست عملکردی بینقص دارد، اما به محض اینکه کاربر یک عکس JPEG با کیفیت پایین آپلود میکند یا از زبانهای رمزگذاریشده (مانند leetspeak) برای دور زدن فیلترها استفاده میکند، شکست میخورد.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای زبانی اشاره کردیم، تکیه بر دادههای ایدهآل، بزرگترین نقطه ضعف سیستمهای تولیدی است. AugLy دقیقاً برای پر کردن این خلاء طراحی شده است تا فاصله بین دادههای آموزشی و دادههای واقعی را از بین ببرد.
موتور افزایش دادههای چندوجهی
طبق مستندات این پروژه، AugLy در سه حوزه اصلی (تصویر، متن و صوت) عمل میکند و هم APIهای تابعی (Functional APIs) برای تغییرات سریع و هم APIهای مبتنی بر کلاس (Class-based APIs) برای ساخت خطلولههای (Pipelines) پیچیده ارائه میدهد. در بخش تصاویر، این کتابخانه «باغچه» یا مجموعهای وسیع از تغییرات را فراهم میکند. این تغییرات شامل موارد پایه مانند پیکسلبندی (Pixelization)، لرزش رنگ (Color Jitter) و تغییرات پرسپکتیو است، اما همچنین اعوجاجهای بسیار خاصتری مانند meme_format (برای افزودن کپشن به تصاویر)، overlay_emoji (قرار دادن ایموجی روی تصویر) و overlay_onto_screenshot (قرار دادن تصویر روی یک اسکرینشات) را شامل میشود.
برای تضمین تکرارپذیری (Reproducibility)، این گردشکار از مجموعهدادههای مصنوعی و دترمینستیک استفاده میکند. برای تصاویر، این فرآیند شامل تولید رویهای عکسهایی با پسزمینههای تصادفی RGB و رسم اشکالی مانند بیضیها، مستطیلها یا چندضلعیها است تا به عنوان داده مرجع (Ground Truth) برای تشخیص اشیا عمل کنند. در حوزه متن، یک مجموعه داده احساسات (Sentiment Corpus) با استفاده از الگوهای پیشفرض ساخته میشود که در آن صفتهای مثبت (مانند "excellent" یا "brilliant") و صفتهای منفی (مانند "dreadful" یا "sloppy") با موضوعاتی مثل «فیلم» یا «سرویس تحویل» جفت میشوند. صداها نیز به صورت سیگنالهای «چیرپ» (Chirp) همراه با هارمونیکها (در محدوده ۲۲۰ تا ۸۸۰ هرتز) و افزودن نویز تولید میشوند تا سیگنالی ایجاد شود که از نظر ادراکی به تغییرات بسیار حساس باشد.
یکی از حیاتیترین ویژگیهای این ابزار، سیستم ردیابی شدت (Intensity Tracking) است. هر تغییر در AugLy متادادهای تولید میکند که شامل یک امتیاز شدت است. برای مثال، یک زنجیره فشردهسازی (RecompressionChain) میتواند شدت تخریب را بر اساس میانگین کیفیت دورهای مختلف کدگذاری با فرمول 100 * (1 - np.mean(qualities) / 100) محاسبه کند. این قابلیت باعث میشود افزایش دادهها از یک فرآیند تصادفی به یک آزمایش علمی و قابل اندازهگیری تبدیل شود و مهندسان بتوانند دقیقاً quantify کنند که یک نمونه چقدر تخریب شده است.
جزئیات تغییرات تصویری
باغچه تصاویر AugLy پارامترهای بسیار دقیقی را برای کنترل سطوح مختلف تخریب ارائه میدهد که به شرح زیر است:
- نویز در سطح پیکسل: استفاده از
random_noiseبا واریانسهای مشخص (مثلاًvar=0.03) وshuffle_pixelsبا فاکتور ۰.۱۵ برای جابجایی تصادفی پیکسلها. - رنگ و نور: تنظیم درخشندگی (brightness) با فاکتور ۱.۷، اشباع (saturation) با فاکتور ۳.۰ و
color_jitter(درخشندگی ۱.۳، کنتراست ۱.۴ و اشباع ۱.۶). - تغییرات هندسی: چرخش (rotate) تا ۱۷ درجه، کجشدگی (skew) با فاکتور ۰.۳۵ و تبدیل پرسپکتیو (
perspective_transform) با سیگما ۴۰.۰. - کاهش کیفیت: کاهش کیفیت کدگذاری (
encoding_quality) تا سطح ۸ و تاری (blur) با شعاع ۳.۰. - لایههای رویی: افزودن خطوط (
overlay_stripes) با عرض خط ۰.۴ و شفافیت ۰.۷، و افزودن متن (overlay_text) با شفافیت ۰.۹. - عملیات بوم (Canvas): استفاده از
pad_squareبرای مربع کردن،hflip(چرخش افقی)،vflip(چرخش عمودی) وscaleبا فاکتور ۰.۳۵.
آگاهی فضایی (Spatial Awareness) یکی دیگر از ستونهای اصلی این ابزار است. هنگام اعمال برشها (Crops)، چرخشها یا جابجاییها، AugLy بهطور خودکار مختصات جعبههای احاطهکننده (Bounding Boxes) را منتقل و بهروز میکند. این کتابخانه از فرمتهایی مانند pascal_voc پشتیبانی میکند تا اطمینان حاصل شود که برچسبهای داده مرجع برای تشخیص اشیا، حتی پس از تغییر پیکسلها (چه یک چرخش ۲۰ درجه باشد و چه یک عملیات پدینگ ۲۵٪)، دقیق باقی میمانند.
مهندسی اعوجاجهای سفارشی
فراتر از ابزارهای داخلی، این چارچوب از تغییرات سفارشی از طریق ارثبری از کلاس BaseTransform پشتیبانی میکند. این ساختار به توسعهدهنده اجازه میدهد از گیت احتمالی p و قابلیت force=True استفاده کند تا منطق سفارشی او بهطور کامل در خطلولههای Compose و OneOf ادغام شود.
یک مثال برجسته از این قابلیت، «زنجیره باز-فشردهسازی» (Recompression Chain) است که شبیهسازی میکند یک تصویر چگونه پس از $N$ دور کدگذاری مجدد در پلتفرمهای مختلف زنده میماند. این تغییر سفارشی میتواند با تعداد دورهای مشخص (مثلاً $n=3$ یا $n=6$)، محدوده کیفیت (بین ۱۲ تا ۴۵) و فاکتور کاهش مقیاس (مثلاً ۰.۸۵) پیکربندی شود. با تکرار فرآیند کدگذاری و تغییر اندازه، این ابزار دقیقاً همان تخریبی را بازسازی میکند که هنگام به اشتراک گذاشتن یک عکس در چندین شبکه اجتماعی رخ میدهد. در هر دور، تصویر با استفاده از درونیابی Image.BILINEAR به عرض و ارتفاع اصلی منبع بازگردانده میشود.
این ابزارهای سفارشی را میتوان در خطلولههای احتمالی ادغام کرد. یک خطلوله نمونه برای «آپلود مجدد» (REUPLOAD_PIPELINE) میتواند شامل موارد زیر باشد:
- ۹۰٪ احتمال انتخاب بین لایه اسکرینشات، فرمت میم با متن "LOL" (ارتفاع کپشن ۸۰)، یا لایههای خطی (عرض خط ۰.۳، شفافیت ۰.۵).
- ۵۰٪ احتمال تغییر تصادفی نسبت ابعاد (بین ۰.۷ تا ۱.۴).
- ۷۰٪ احتمال قرار دادن ایموجی تصادفی روی تصویر.
- ۶۰٪ احتمال تنظیم تصادفی درخشندگی (فاکتور ۰.۷ تا ۱.۴).
- ۱۰۰٪ احتمال کاهش کیفیت کدگذاری (مثلاً
quality=12).
تیم قرمز (Red-Teaming) برای مدلهای تصویر و متن
برای اثبات کارایی این ابزارها، از این چارچوب برای محک زدن یک سیستم تشخیص کپی مبتنی بر هش ادراکی (pHash) استفاده شد. این سیستم از یک امضای ۶۴ بیتی بر اساس تبدیل کسینوسی گسسته (DCT) و یک تصویر خاکستری تغییر اندازه یافته به $32 \times 32$ استفاده میکرد. سیستم در برابر ۱۷ حمله مختلف تست شد. نتایج نشان داد که در حالی که pHash در برابر تغییرات ساده نور مقاوم است، اما در برابر تبدیلهای پرسپکتیو (سیگما=۴۰.۰) و زنجیرههای فشردهسازی شدید، بهشدت شکست میخورد.
با اندازهگیری «بازخوانی بازیابی top-1» (top-1 retrieval recall) و «میانگین فاصله همینگ» (mean Hamming distance)، این بنچمارک دقیقاً نقاط شکست هش را شناسایی میکند. این دادهها به مهندس میگوید که دقیقاً چه نوع افزایش دادههایی را به مجموعه آموزش اضافه کند یا پیشنهاد میدهد که به جای یک هش ساده، از یک جاسازی (Embedding) مستقل از هندسه مانند CLIP یا DINOv2 استفاده کند.
مدلهای متنی با تهدیدات متنوعتری روبرو هستند. AugLy حملات خصمانه زیر را شبیهسازی میکند:
- همشکلهای یونیکد (Unicode Homoglyphs): جایگزینی حروف با نمادهای بصری مشابه از الفباهای دیگر (مثلاً با استفاده از
ReplaceSimilarUnicodeCharsباaug_word_p=0.8وaug_char_p=0.4). - تزریق کاراکترهای با عرض صفر (Zero-Width Injection): درج حروف نامرئی (مانند
0x200B,0x200C,0x200D,0x2060,0xFEFF) برای شکستن فرآیند توکنسازی از طریقInsertZeroWidthCharsبا گام (cadence) ۲.۰. - زبان لیت (Leetspeak): جایگزینی حروف با اعداد یا نمادهای مشابه با استفاده از
ReplaceSimilarChars(aug_word_p=0.8,aug_char_p=0.4). - هرجومرج در حروف (Case Chaos): تغییر تصادفی حروف بزرگ و کوچک (مثلاً
ChangeCaseباcase="upper"و گام ۲.۰) برای گیج کردن طبقهبندها. - نویز ساختاری: استفاده از
SplitWords(احتمال ۰.۵)،MergeWords(احتمال ۰.۵) وInsertPunctuationChars(گام ۲.۰) برای مختل کردن جریان متن. - تاریکسازی بصری: اعمال
ReplaceFunFonts(احتمال ۰.۸) یاReplaceUpsideDown(احتمال ۰.۶) برای شبیهسازی استایلهای شبکههای اجتماعی. - تغییرات جهتدار: استفاده از
ReplaceBidirectionalبرای برعکس کردن جریان متن.
در یک آزمایش عملی، صحت یک طبقهبند احساسات پایه (TfidfVectorizer با n-gramهای ۱-۲ و LogisticRegression) تحت این حملات بهشدت سقوط کرد. اما مدل با یک رویکرد دوگانه «سخت» شد:
۱. لایه پاکسازی (Sanitization Layer): یک تابع پیشپردازش که کاراکترهای با عرض صفر را ترجمه میکند، نرمالسازی یونیکد NFKD را اعمال میکند، کاراکترهای ترکیبی را حذف کرده و علائم نگارشی (به جز آپاستروف) را با استفاده از یک جدول ترجمه سفارشی پاک میکند.
۲. آموزش خصمانه (Adversarial Training): استفاده از AugLy برای گسترش مجموعه دادههای آموزش. برای مثال، یک مجموعه آموزشی با ۵۲۰ نمونه، از طریق اعمال غلطهای املایی، همشکلها و هرجومرج در حروف، به یک مجموعه داده بسیار بزرگتر و مقاومتر تبدیل شد. مدل تقویتشده از یک تحلیلگر char_wb با n-gramهای ۳-۵ برای مدیریت بهتر اختلالات در سطح کاراکتر استفاده کرد.
ادغام با صوت و PyTorch
این چارچوب به حوزه صوت نیز گسترش یافته است تا سیستمهای تبدیل گفتار به متن یا سیستمهای بیومتریک را تست کند. AUDIO_ZOO شامل موارد زیر است:
- تغییرات زمانی و گام: تغییر گام (Pitch shift +4 steps)، کشیدگی زمانی (1.5x) و تنظیم سرعت (1.4x) یا تمپو (0.8x).
- نویز و مصنوعات: افزودن نویز پسزمینه (سطح SNR 5.0dB)، درج کلیکهای صوتی هر ۰.۲۵ ثانیه و اعمال بازگشت صدا (reverberance=80.0).
- فیلترها: فیلترهای پایینگذر (1kHz)، بالاگذر (2kHz) و اکولایزرهای پیک (مرکز 800Hz، گین -12dB).
- پردازش سیگنال: برش (Clipping برای ۵۰٪ مدت زمان)، تکرار (n=1) و نرمالسازی.
- تجزیه: تغییرات جداسازی هارمونیک و ضربهای (percussive).
برای مقیاسپذیری در محیط تولید، AugLy مستقیماً با PyTorch از طریق کلاسهای سفارشی Dataset و DataLoader ادغام میشود. از آنجایی که تغییرات در قالب PIL-to-PIL هستند، بهراحتی در خطلولههای torchvision قرار میگیرند. یک خطلوله نمونه PyTorch ممکن است شامل یک بلوک Compose از AugLy (شامل RandomBlur با شعاع ۰.۵-۲.۵، RandomPixelization با نسبت ۰.۳-۱.۰ و EncodingQuality در سطح ۲۰) و سپس مراحل استاندارد T.Resize((128, 128)), T.ToTensor() و T.Normalize با میانگینهای ImageNet ([0.485, 0.456, 0.406], [0.229, 0.224, 0.225]) باشد.
علاوه بر این، برای کسانی که با آرایههای NumPy کار میکنند، aug_np_wrapper اجازه میدهد تغییرات مبتنی بر PIL در AugLy مستقیماً روی تصاویر NumPy اعمال شوند، در حالی که نوع داده (dtype) و شکل (shape) اصلی حفظ شود. برای مثال، اعمال overlay_emoji با opacity=0.8 و y_pos=0.4 روی یک آرایه NumPy، نتیجهای با همان ابعاد و نوع داده برمیگرداند.
رویکرد انبار متاداده (Metadata Warehouse)
به جای تولید صرف تصاویر، این گردشکار یک «انبار متاداده» میسازد. این یک لاگ ساختاریافته است که در قالب CSV صادر میشود و موارد زیر را برای هر نمونه افزایشیافته ثبت میکند:
- شناسه منبع (Source ID): ایندکس تصویر اصلی.
- نام افزایش داده (Augmentation Name): تغییر خاص اعمال شده.
- شدت (Intensity): امتیاز تخریب کمی شده.
- ابعاد (Dimensions): عرض/ارتفاع منبع در مقابل عرض/ارتفاع مقصد.
- نسبت مساحت (Area Ratio): نسبت مساحت مقصد به منبع که به صورت
(dst_w * dst_h) / (src_w * src_h)محاسبه میشود.
این انبار امکان «یادگیری برنامهریزی شده» (Curriculum Learning) را فراهم میکند. مهندسان میتوانند افزایش دادهها را بر اساس میانگین شدت گروهبندی کنند و آموزش را با نمونههای کمشدت شروع کرده و بهتدریج سختی را افزایش دهند. این کار از فروپاشی مدل تحت نویز زیاد در مراحل اولیه آموزش جلوگیری میکند.
تحلیل: تغییر پارادایم استواری
این رویکرد تمرکز را از «معماری مدل» به «استواری دادهها» تغییر میدهد. برای یک توسعهدهنده عملیاتی، این بدان معناست که گلوگاه قابلیت اطمینان هوش مصنوعی دیگر تنها تعداد پارامترها نیست، بلکه تنوع نمونههای خصمانهای است که مدل با آنها مواجه شده است.
با تبدیل افزایش دادهها به یک ابزار تیم قرمز (Red-Teaming)، تیمها میتوانند از وصلهکاریهای واکنشی (که در آن باگ پس از کشف توسط کاربر اصلاح میشود) به سمت سختسازی پیشدستانه حرکت کنند. توانایی کمیسازی «شدت» به این معناست که استواری دیگر یک حس کلی (vibe) نیست، بلکه یک متریک بنچمارک شده است.
برای پیادهسازی این روش، توسعهدهندگان باید با شناسایی رایجترین حالتهای شکست مدل خود در محیط تولید شروع کنند و آنها را به تغییرات خاص در AugLy نگاشت کنند تا یک مجموعه تست خصمانه هدفمند بسازند. این بنیاد اجازه میدهد تا در آینده به سمت استواری ویدئویی (با استفاده از augly.video و ffmpeg) یا استفاده از جاسازیهای پیشرفته برای جایگزینی هشهای ساده در سیستمهای تشخیص کپی حرکت کنند.



گفتگو