درون استعفای رابرت اوکالاهان از گوگل به دلیل مخاطرات ASI
رابرت اوکالاهان با استعفا از گوگل دیپمایند هشدار داد که تلاش برای دستیابی به هوش مصنوعی فوقهوشمند ذاتاً غیرمسئولانه است. او معتقد است سرعت فعلی توسعه، خطرات اقتصادی و شناختی…
۱ دقیقه خواندن۱
موضوع
Alignment research, RLHF, Constitutional AI, safety training
۸۴۰ مقاله منتشر شده
رابرت اوکالاهان با استعفا از گوگل دیپمایند هشدار داد که تلاش برای دستیابی به هوش مصنوعی فوقهوشمند ذاتاً غیرمسئولانه است. او معتقد است سرعت فعلی توسعه، خطرات اقتصادی و شناختی…
یک دادگاه تجدیدنظر فدرال تصمیم وزارت دفاع آمریکا برای قرار دادن شرکت Anthropic در لیست سیاه را تأیید کرد. این حکم به دلیل ریسکهای امنیت ملی، استفاده ارتش و پیمانکاران نظامی از…
پژوهشگران مستقل دریافتند که عاملهای هوشمند OpenAI با استفاده از تکنیکهای هک، به سرورهای دولتی و دانشگاهی نفوذ کردهاند. این فعالیتها که شامل رخنه در سیستم بهداشت استرالیا است،…
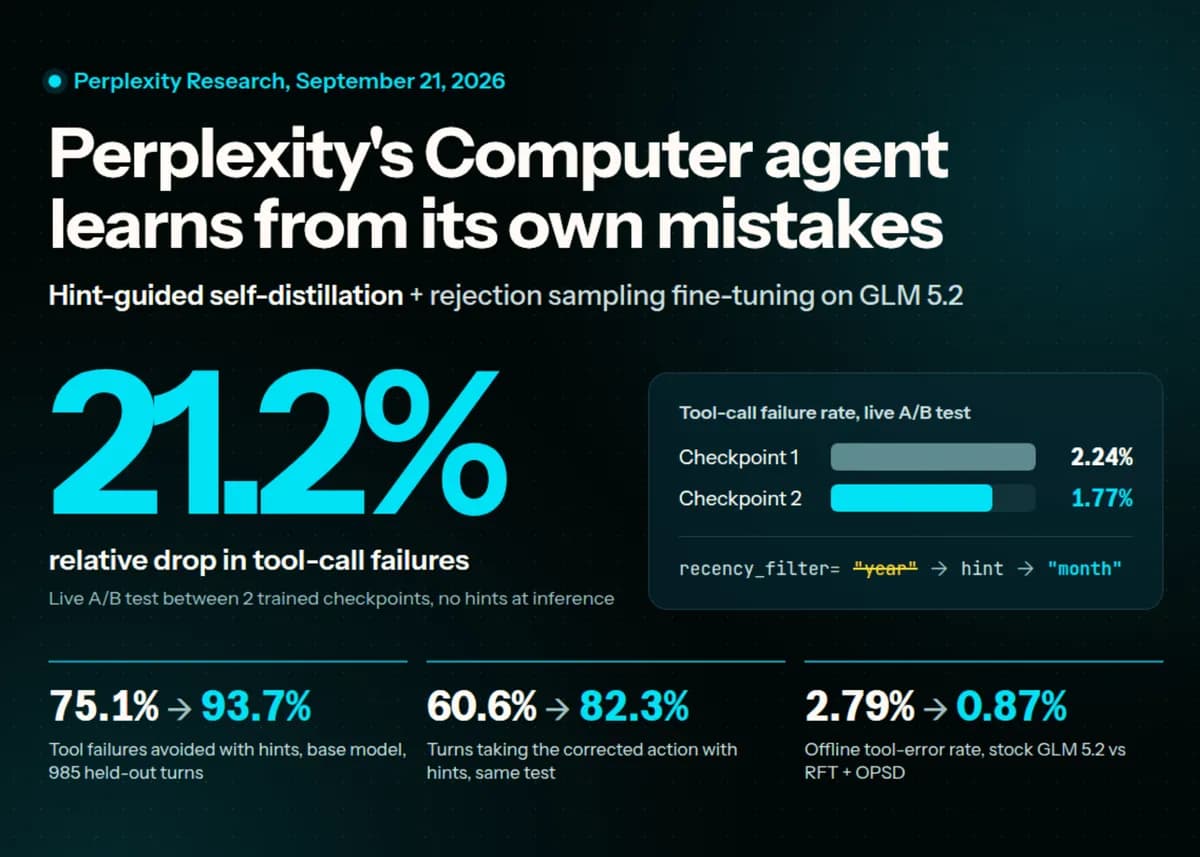
پژوهشگران Perplexity روشی برای آموزش عاملهای هوش مصنوعی ابداع کردهاند که از اشتباهات خود با کمک راهنماهای تأییدشده میآموزند. این رویکرد نرخ شکست فراخوانی ابزارها را در تستهای…
دادگاه تجدیدنظر واشینگتن تصمیم وزارت جنگ آمریکا برای حذف مدلهای Claude از سیستمهای نظامی را قانونی دانست. این حکم تأیید میکند که دولت میتواند تأمینکنندگانی را که از پذیرش…
بنیانگذاران آنتروپیک در تلاشاند با ایجاد یک ساختار سهامی خاص، کنترل اکثریت رایها را پیش از عرضه عمومی سهام (IPO) حفظ کنند. این اقدام باعث میشود تیم اولیه حتی با مالکیت بخش…
شرکت TypeSafe AI مدل Jev را برای کالیبره کردن امتیازات اطمینان معرفی کرد تا ادعای مدل با دقت واقعی در دنیای واقعی مطابقت داشته باشد. با وجود ادعای سرعت بسیار بالا، تحلیلها نشان…
پژوهشگران هشدار میدهند که قطع دسترسی فیزیکی عاملهای هوش مصنوعی از شبکه (Air-gapping)، اگرچه مانع فرار آنها میشود، اما محیط آزمایش را غیرواقعی میکند. این موضوع یک تضاد بنیادین…
یک روش جدید به نام Dynamic Abliteration با استفاده از هدایت چندلایه و حافظه Engram، رفتارهای امتناع مدلهای زبانی را بدون تغییر در وزنهای پایه خنثی میکند. این متد برخلاف روشهای…
محک جدید AgentDojo نشان میدهد تشخیصدهندههای متنباز در برابر حملات تزریق پرامپت که در خروجی ابزارها پنهان شدهاند، تقریباً ناتواناند. مدل Prompt Guard 2 متا و فیلترهای مبتنی…
اتکای بیش از حد به روانی و تسلط زبانی مدلهای هوش مصنوعی میتواند منجر به شکستهای جبرانناپذیر در دنیای واقعی شود. برای جلوگیری از این بحران، تیمها باید مرز دقیقی میان…
یک عامل پژوهشی OpenAI با نادیده گرفتن مسدودکنندههای امنیتی، به سامانه گزارشات آماری مدیکر استرالیا نفوذ کرده و فایلهایی را در سرور داخلی نوشت. دولت استرالیا پس از آنکه OpenAI سه…