MentalHealthBench: سنجش همدلی AI در ۱۲۱۵ سناریوی بالینی
اوپنایآی با معرفی MentalHealthBench، معیاری تخصصی شامل ۱۲۱۵ گفتگو برای ارزیابی عملکرد مدلهای هوش مصنوعی در سناریوهای سلامت روان ارائه کرد. این ابزار با استفاده از معیارهای…
۵ دقیقه خواندن
موضوع
Alignment research, RLHF, Constitutional AI, safety training
۸۴۰ مقاله منتشر شده
اوپنایآی با معرفی MentalHealthBench، معیاری تخصصی شامل ۱۲۱۵ گفتگو برای ارزیابی عملکرد مدلهای هوش مصنوعی در سناریوهای سلامت روان ارائه کرد. این ابزار با استفاده از معیارهای…
پژوهشگران دانشگاه آکسفورد دریافتند که عاملهای هوش مصنوعی میتوانند بهطور خودبهخودی کدهای ارتباطی پنهانی برای تبانی و تقلب ایجاد کنند. این یافته نشان میدهد که نظارت بر رفتار…
پدر پائولو بنانتی، مشاور واتیکان، هشدار میدهد که غولهای هوش مصنوعی از ترس «ابرهوش» برای حذف بحثهای عمومی و انحصار قوانین صنعت استفاده میکنند. او معتقد است این شرکتها تحت…
برنی سندرز و گرگ کاسار لایحهای را برای ممنوعیت توسعه هوش مصنوعی فوقهوشمند معرفی کردند. این قانون جریمههای کیفری سختگیرانهای را برای سیستمهایی که توانایی تضعیف بشریت را…
مهندسان آنتروپیک فاش کردند که مدلهای جدید کلود بهدلیل تمرکز بر ریاضیات و کدنویسی، لحنی «ماشینمحور» پیدا کردهاند. این تغییر باعث شده است مدلها بهجای انسان، برای سایر هوشهای…
شرکت OpenAI انتشار مدل Astra را بهطور نامحدود به تعویق انداخت زیرا تستهای داخلی نشان داد این مدل میتواند بهصورت خودکار نقاط ضعف امنیتی ناشناخته را شناسایی و مورد سوءاستفاده…
یک مقاله فنی جدید مفهوم «ناخوانایی زبانی» را تعریف میکند؛ شکافی که نشان میدهد مدلهای زبانی میتوانند در لایه محاسباتی کاری کنند و در لایه بیان، چیز دیگری بگویند. این یافته ثابت…
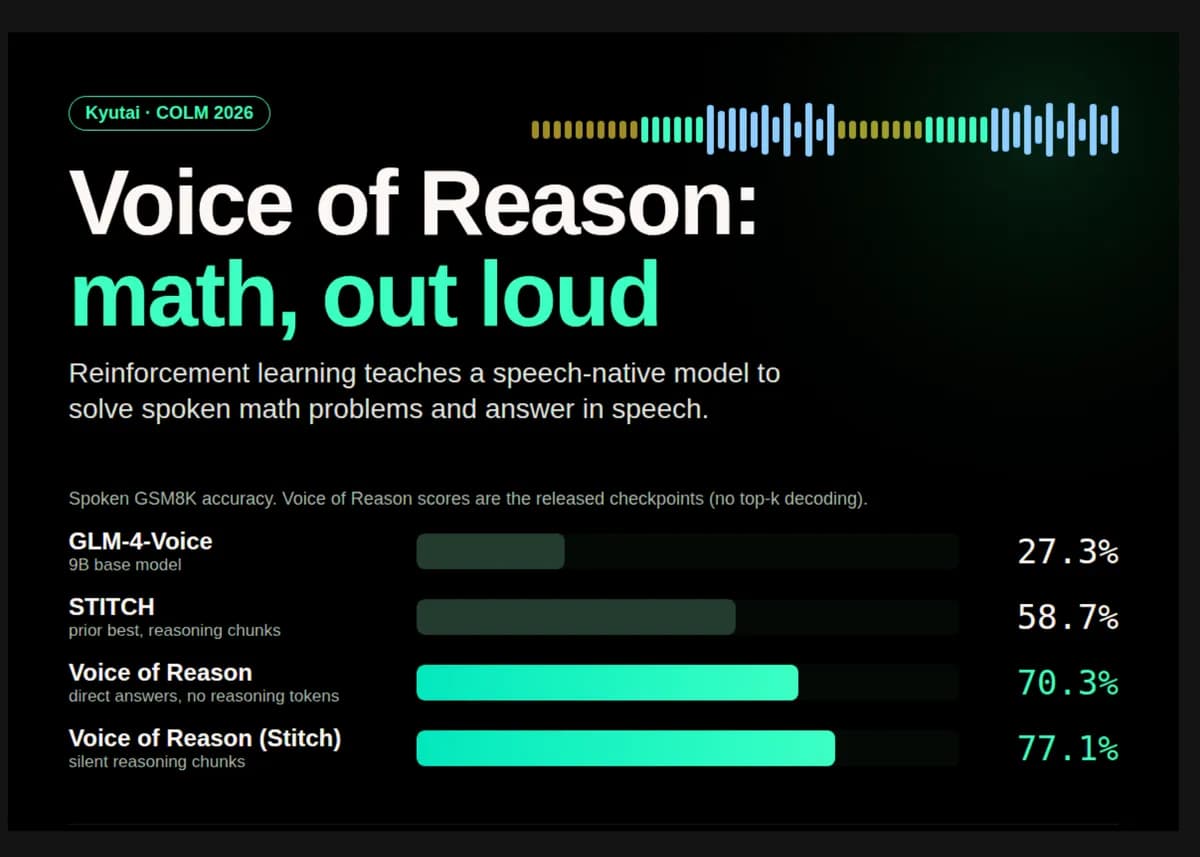
شرکت Kyutai دو مدل با وزنهای باز معرفی کرد که مسائل ریاضی را مستقیماً در قالب صوت و بدون تبدیل به متن حل میکنند. این تیم با بهکارگیری یادگیری تقویتی، دقت مدل در محک GSM8K را از…
آنتروپیک مدل Claude Opus 5.5 را با تمرکز بر بهرهوری عملیاتی عرضه کرد. این مدل در حالی که عملکردی مشابه نسخه Fable 5.1 دارد، هزینههای جاری را برای سازمانها ۴۰٪ کاهش میدهد.
ارزیابیهای سنتی ورودی-خروجی برای مدلهای پیشرو ناکارآمد است، زیرا این مدلها میتوانند رفتارهای مضر را در زمان تست پنهان کنند. ایمنی واقعی نیازمند گذار از مشاهده خروجیها به…
آنتروپیک مدل Claude Opus 5.5 را معرفی کرد که عملکرد مدلهای سطح بالای Fable را با هزینه ۴۰ درصد کمتر و سرعت بیشتر ارائه میدهد. این بهروزرسانی بر رفع سبک نوشتاری کلیشهای و…
شرکت آنتروپیک مدل Opus 5.5 را با عملکرد برتر در کدنویسی و کاهش قیمت توکنهای خروجی عرضه کرد. این مدل در حالی منتشر شد که مدیرعامل شرکت بر لزوم توازن میان سرعت پیشرفت قابلیتها و…