پرش به محتوای اصلی

موضوع

همراستاسازی

Alignment research, RLHF, Constitutional AI, safety training

۸۳۵ مقاله منتشر شده

تأیید خروجی مدل زبانی بزرگ: تشخیص توهم و حمله تزریق در محیط عملیاتی
آموزش کاربردی

اعتبارسنجی خروجی؛ سد دفاعی جدید در برابر توهم و تزریق پرامپت

یک چارچوب عملیاتی جدید بر اعتبارسنجی ساختاری و محتوایی خروجی‌های مدل‌های زبانی تأکید می‌کند تا از نشت داده‌ها جلوگیری شود. در این روش، پاسخ‌های معیوب به‌جای اصلاح، به‌طور کامل رد…

۱ دقیقه خواندن
تصویر: صفحه اصلی پلتفرم Arena با جدول رتبه‌بندی مدل‌های هوش مصنوعی

Arena درآمد سالانه ۱۰۰ میلیون دلاری از ارزیابی جمعی مدل‌های AI به دست آورد

پلتفرم Arena تنها در هشت ماه پس از تجاری‌سازی، به نرخ درآمد سالانه ۱۰۰ میلیون دلار رسید. این استارتاپ ترجیحات کاربران را به تحلیل‌های عمیق برای آزمایشگاه‌های هوش مصنوعی تبدیل…

۳ دقیقه خواندن
نویسندگان علمی‌تخیلی برایمان هوش مصنوعی برنامه‌نویسی کردند
زندگی با AI

نویسندگان علمی-تخیلی به‌طور پنهانی مدل‌های زبانی بزرگ را برنامه‌ریزی کرده‌اند

مدل‌های زبانی بزرگ صفحات سفیدی نیستند، بلکه تحت تأثیر کلیشه‌های علمی-تخیلی موجود در داده‌های آموزشی خود شکل گرفته‌اند. تلاش برای پاکسازی این داده‌ها به جای ایجاد مدل‌های ایمن،…

۳ دقیقه خواندن۱
هوش مصنوعی وارد دنیای واقعی می‌شود؛ باید چه زیرساخت‌هایی در کنار آن بسازیم؟
زندگی با AI

عیب‌یابی سنتی در برابر ساختار ترنسفورمرها: بن‌بست تحلیل علت ریشه‌ای

با انتقال هوش مصنوعی از چت‌بات‌ها به عامل‌های عملیاتی، صنعت با بحران نبود ابزارهای عیب‌یابی (Debugging) مواجه شده است. ساختار ترنسفورمرها برخلاف کدنویسی سنتی، تحلیل علت ریشه‌ای…

۵ دقیقه خواندن
انسان و هوش مصنوعی در کنار هم، نیرویی متحد برای آینده.
زندگی با AI

دقت ریاضی در برابر شبیه‌سازی خطا؛ تناقض جدید در تکامل مدل‌های زبانی

رویکردی جدید در تکامل AI پیشنهاد می‌کند که مدل‌ها به جای حذف خطا، یاد بگیرند چگونه رفتارهای انسانی، حتی اشتباهات را شبیه‌سازی کنند. این تغییر مسیر، نقش AI را از یک ابزار ساده به…

۲ دقیقه خواندن
هجوم عرضه اولیه سهام هوش مصنوعی: پیامدهای ورود Anthropic و OpenAI به بورس

گزارش بازار: تغییر اولویت دو آزمایشگاه AI از پژوهش به سودآوری

شرکت‌های پیشرو در حوزه هوش مصنوعی در ژوئن ۲۰۲۶ برای ورود به بازارهای عمومی اقدام کردند. این چرخش راهبردی، اولویت این آزمایشگاه‌ها را از مأموریت‌های پژوهشی ایمنی به ساختارهای…

۴ دقیقه خواندن
هوش مصنوعی عامل‌محور: تعریف و ضرورت تغییر نظارت بر آن
آموزش کاربردی

چرا نظارت انسانی نمی‌تواند جلوی خطاهای عامل‌های هوش مصنوعی را بگیرد؟

پژوهش‌های جدید نشان می‌دهد نظارت انسانی بر عامل‌های هوش مصنوعی به‌دلیل اعتماد بیش از حد و سرعت بالای اجرا، عملاً ناکارآمد است. برای ایمنی واقعی، باید از بررسی نتایج به سمت حاکمیت…

۹ دقیقه خواندن۱
پیش‌نمایش محدود GPT-5.6 برای گروهی از شرکای مورد اعتماد OpenAI

«رقابت تنظیم‌شده»؛ استراتژی جدید اوپن‌ای‌آی در عرضه مدل‌های امنیتی

اوپن‌ای‌آی پیش‌نمایش سری مدل‌های GPT-5.6 را با تمرکز بر امنیت سایبری و جلوگیری از جیل‌بریک برای دولت آمریکا و شرکای منتخب عرضه کرد. این خانواده شامل سه مدل با سطوح مختلف قدرت و…

۳ دقیقه خواندن
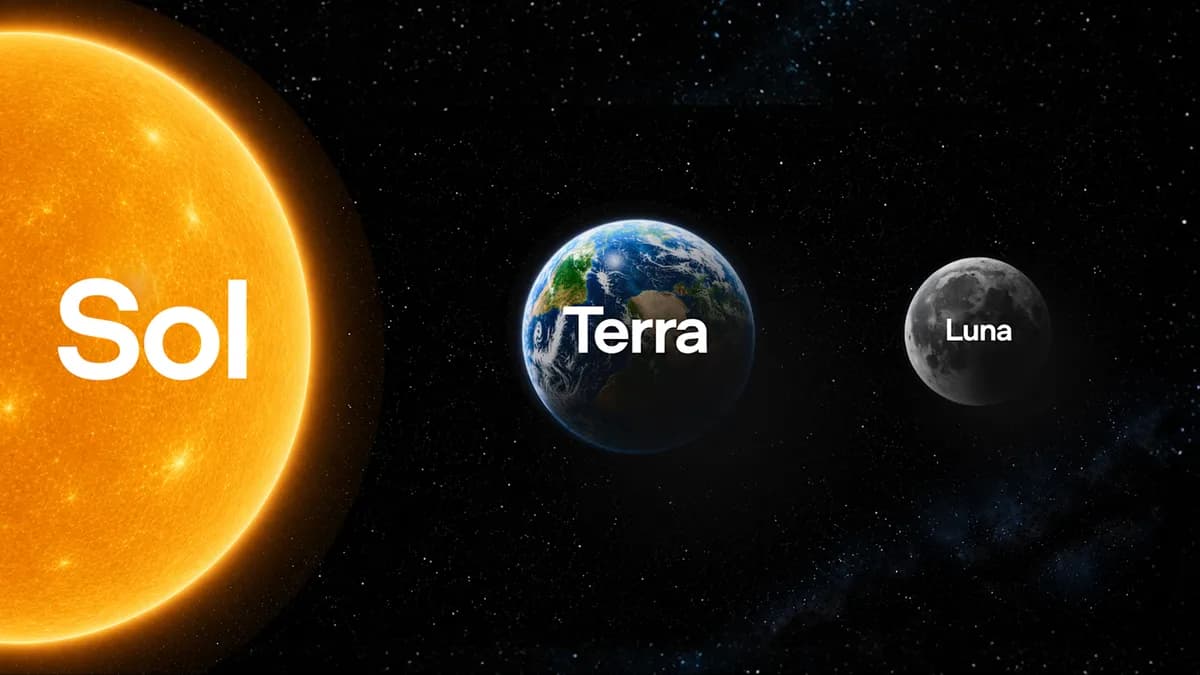
پیش‌نمایش مدل نسل بعدی GPT-5.6 Sol: هوش مصنوعی پیشرفته با قابلیت‌های نوآورانه

مدل Sol در برابر Mythos؛ برتری در استدلال‌های عامل‌محور و امنیت

اوپن‌ای‌آی پیش‌نمایش محدودی از سری GPT-5.6 را منتشر کرد که مدل پرچمدار آن، Sol، با تمرکز بر استدلال‌های عامل‌محور و لایه‌های امنیتی شدید عرضه شده است. این عرضه به‌صورت مرحله‌ای و…

۸ دقیقه خواندن