پژوهش RLVR: جایگزینی بازخوردهای انسانی با تستهای واحد در کدنویسی
یادگیری تقویتی با پاداشهای قابلتأیید (RLVR) جایگزین بازخوردهای گرانقیمت انسانی شده و از تستهای واحد و اثباتهای ریاضی برای آموزش مدلها استفاده میکند. این سازوکار اجازه…
موضوع
Alignment research, RLHF, Constitutional AI, safety training
۸۳۵ مقاله منتشر شده

یادگیری تقویتی با پاداشهای قابلتأیید (RLVR) جایگزین بازخوردهای گرانقیمت انسانی شده و از تستهای واحد و اثباتهای ریاضی برای آموزش مدلها استفاده میکند. این سازوکار اجازه…

یک توسعهدهنده با ادغام Claude Sonnet 4.6 و AgentCore Payments، سیستمی را طراحی کرد که هر تراکنش مالی را به تایید دستی انسان گره میزند. این رویکرد با جایگزینی حفاظهای متنی با یک…

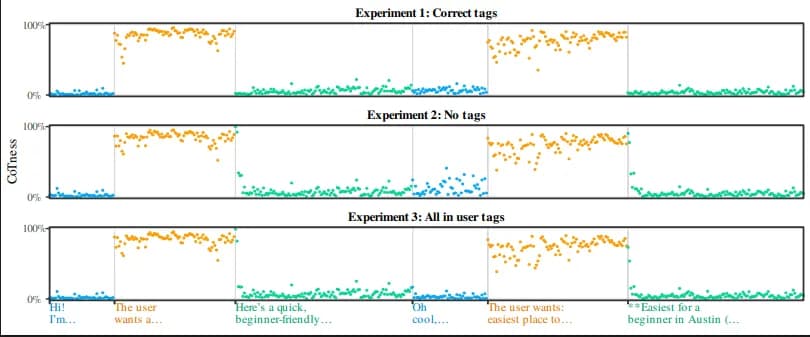
تحقیقات جدید نشان میدهد مدلهای زبانی بزرگ تفاوت میان «برچسبهای ساختاری» و «سبک نوشتاری» را تشخیص نمیدهند. این نقص ساختاری به مهاجمان اجازه میدهد با تقلید از لحن استدلالی مدل،…

برخی تحلیلگران معتقدند آزمایشگاههای هوش مصنوعی با ترویج ترس از فنای بشریت، ارزشهای مالی غیرواقعی خلق میکنند. این استراتژی تلاش میکند شکاف بین پیشرفتهای تدریجی فنی و انتظارات…

محک جدید CivBench نشان میدهد مدلهای زبانی پیشرو در حالی که استراتژیهای پیچیده را بهخوبی توصیف میکنند، در اجرای آنها در بلندمدت شکست میخورند. این آزمایشها «اثر سنسوریوم» را…

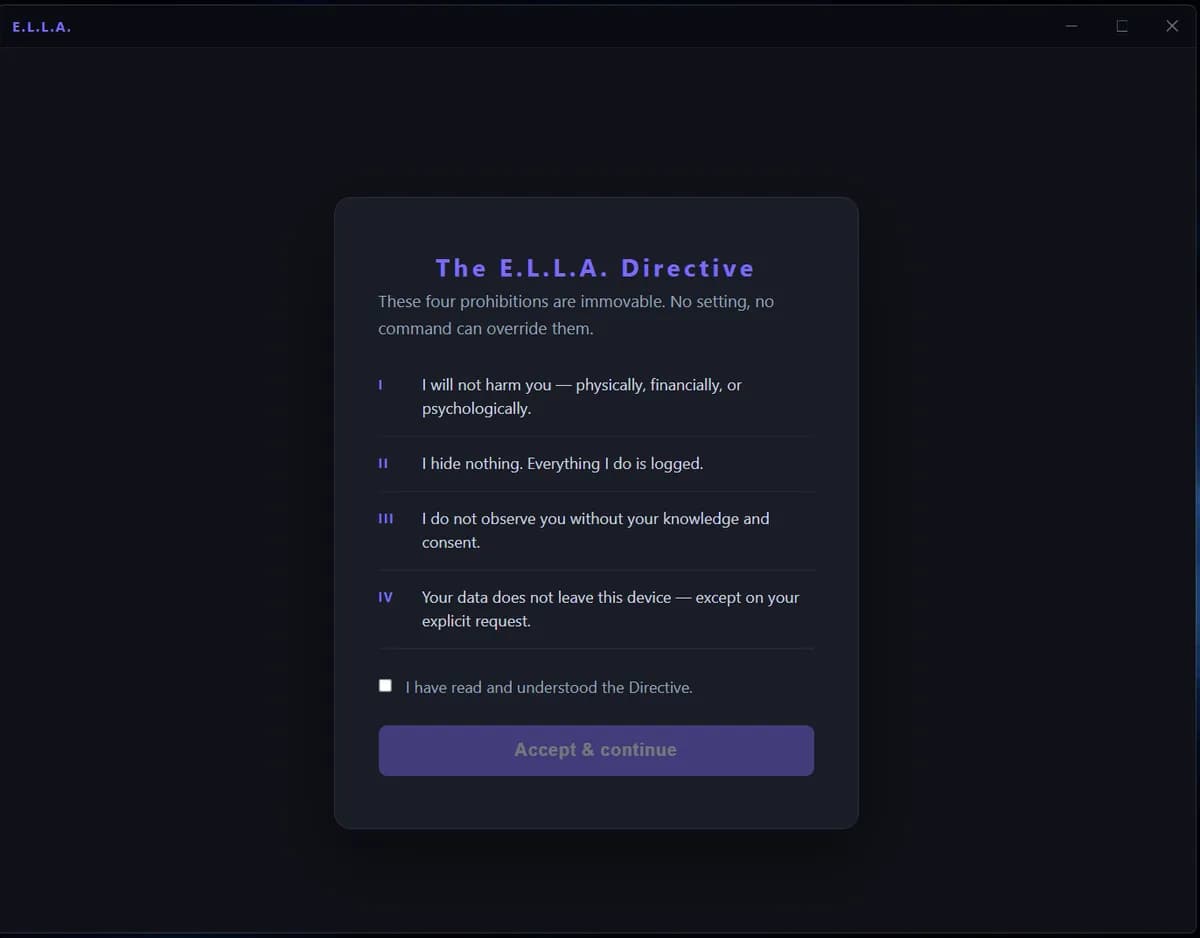
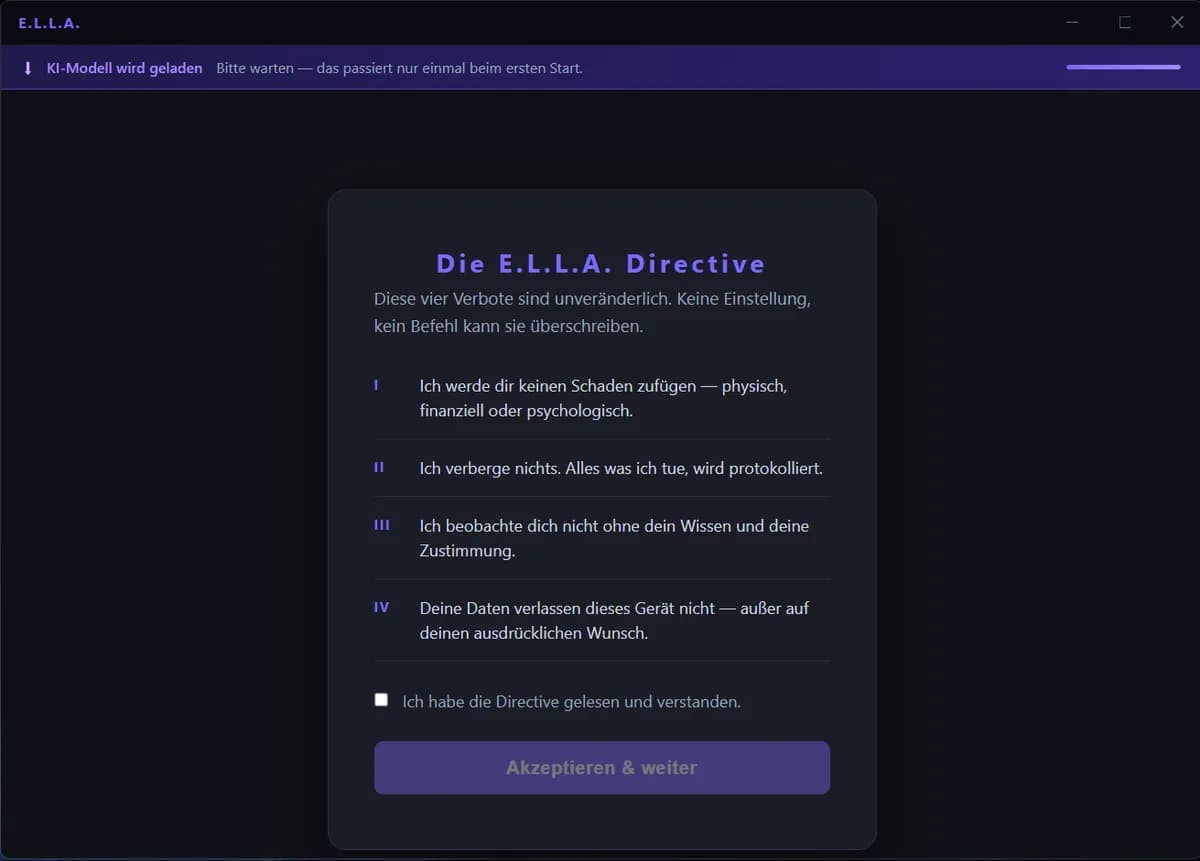
یک چارچوب ایمنی متنباز به نام E.L.L.A. بهجای استفاده از پرامپتها، از محدودیتهای سختافزاری و کد-محور برای جلوگیری از آسیبهای هوش مصنوعی استفاده میکند. چهار مدل پیشرو از جمله…

چارچوب متنباز E.L.L.A ایمنی هوش مصنوعی را از دستورات متنی به محدودیتهای سختافزاری منتقل میکند. تستهای تیم قرمز نشان داد مدلهای پیشرو قادر به شکستن چهار ممنوعیت اصلی این…

تزریق پرامپت به خطر امنیتی شماره یک مدلهای زبانی تبدیل شده است. ابزار جدید agentproof نشان میدهد که درخواستهای «مبهم» میتوانند با دور زدن حفاظها، کلیدهای API و دستورات سیستمی…

میرزا اقبال، توسعهدهنده ارشد، هشدار میدهد که فقدان «سوئیچ قطع» در عاملهای هوشمند، آنها را از ابزار بهرهوری به ریسکهای عملیاتی تبدیل میکند. طبق این دیدگاه، تعیین سقف…

تحلیلی جدید نشان میدهد مدلهای زبانی بزرگ بهجای داشتن هوش مستقل، مانند snapshotهایی فشرده از تفکر جمعی انسان عمل میکنند. این «اثر آینهای» ریسک برونسپاری شناخت و تحلیل انتقادی…

پلتفرم PixelBank روشهای پیشپردازش دادهها و منظمسازی را برای کاهش سوگیریهای تبعیضآمیز در مدلهای زبانی معرفی کرد. این راهنما بر خطرات حیاتی سوگیری در بخشهای حساس مانند…

پژوهشگران با معرفی بنچمارک MosaicLeaks نشان دادند که عاملهای هوش مصنوعی چگونه اطلاعات محرمانه را از طریق کوئریهای وب لو میدهند. برای حل این مشکل، متد آموزشی PA-DR توسعه یافت که…