پرش به محتوای اصلی

موضوع

مدل‌های بازوزن

Open-source models, open weights, local hosting, licensing

۱٬۹۳۹ مقاله منتشر شده

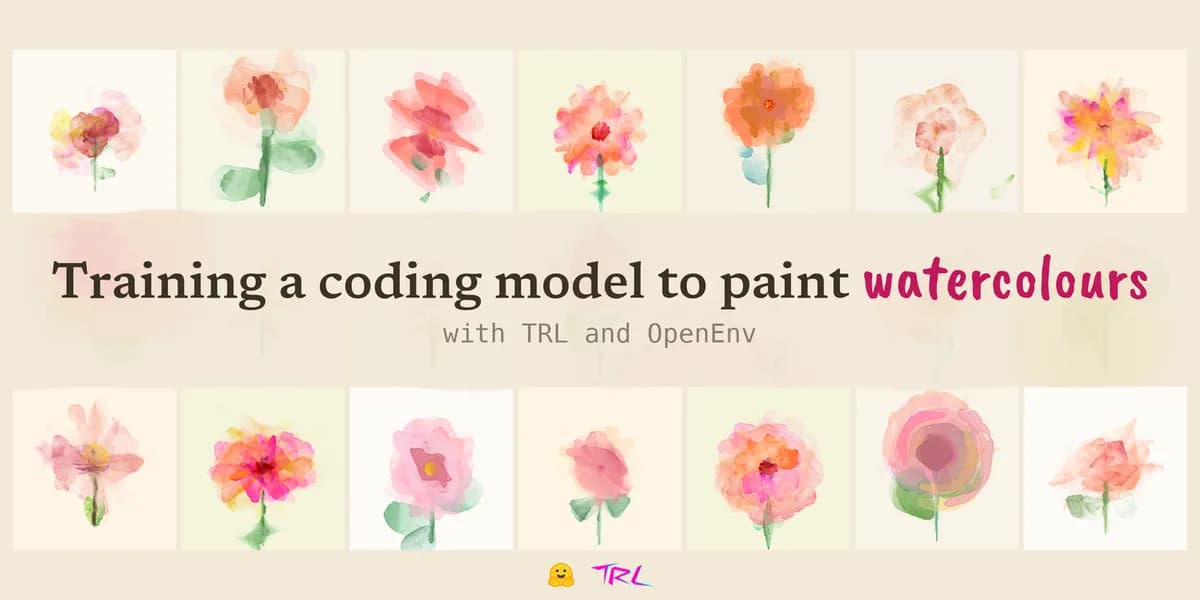
آموزش مدل کدنویسی برای نقاشی آبرنگ با TRL و OpenEnv
آموزش کاربردی

آموزش سلیقهٔ هنری به مدل‌های زبانی کوچک با یادگیری تقویتی

یک پیاده‌سازی متن‌باز جدید نشان می‌دهد چگونه می‌توان از یادگیری تقویتی برای آموزش «سلیقه» به مدل‌های زبانی کوچک استفاده کرد. این پروژه با پاداش دادن به کدهایی که آبرنگ‌های زیباتری…

۲۰ دقیقه خواندن
پلتفرم JapanFold محاسبات کشف داروی متن‌باز را در داخل ژاپن نگه می‌دارد.

JapanFold: کاهش ۸۰ درصدی هزینه‌های کشف دارو با زیرساخت بومی

پلتفرم JapanFold با تکیه بر سخت‌افزارهای اختصاصی Tenstorrent، محاسبات زیست‌شناسی ساختاری را کاملاً بومی‌سازی کرد. این سامانه مدل‌های متن‌باز را به‌صورت رایگان در اختیار پژوهشگران…

۴ دقیقه خواندن۱
مدل ۴ میلیارد پارامتری Spark-X2.5-4B با عملکردی معادل مدل‌های ۲ تا ۳ برابر بزرگ‌تر در وظایف عامل، کد و ریاضی.

مدل Spark-X2.5-4B در کدنویسی و استدلال از رقبای ۱۲ میلیاردی پیشی گرفت

مدل باز Spark-X2.5-4B با وجود اندازه کوچک، در وظایف عامل‌محور، ریاضیات و کدنویسی عملکردی مشابه مدل‌هایی با اندازه سه برابر خود نشان داد. این مدل در چندین محک کلیدی، رقبایی چون…

۱ دقیقه خواندن
نسخه ۱.۳ موز اسپارک: هوش مصنوعی خلاق برای تولید محتوا با سرعت و کیفیت بالاتر

مدل Muse Spark 1.3 متا مصرف توکن‌ها در کدهای پیچیده را ۲۵٪ کاهش داد

متا مدل Muse Spark 1.3 را برای بهینه‌سازی گردش‌های کاری عامل‌محور و وظایف مهندسی منتشر کرد. این به‌روزرسانی با کاهش چشمگیر توکن‌ها و فراخوانی ابزارها، پایداری مدل در اجرای دستورات…

۴ دقیقه خواندن
ریاضیدانان روس به مدل‌های هوش مصنوعی آموختند بدون کلام با هم گفتگو کنند

تبادل وزن‌ها در برابر تبادل متن؛ روشی ارزان‌تر برای اتصال مدل‌های AI

استارتاپ Mostik روشی را ابداع کرده که مدل‌های هوش مصنوعی به‌جای تبادل متن، از طریق مقادیر ریاضی وزن‌ها با یکدیگر ارتباط برقرار کنند. این تکنیک به مدل‌های کوچک اجازه می‌دهد هوشمندی…

۴ دقیقه خواندن۲
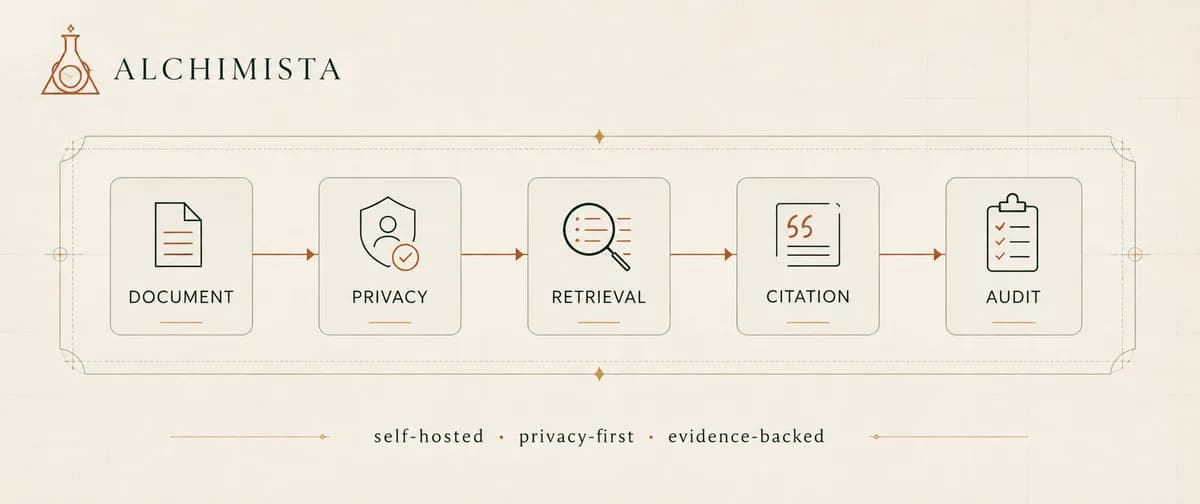
سیستم RAGی ساختم که منابع پاسخ را نشان دهد: معرفی Alchimista
آموزش کاربردی

آیا میزبانی محلی داده‌ها می‌تواند توهمات مدل‌های RAG را کاهش دهد؟

سامانه متن‌باز Alchimista برخلاف چت‌بات‌های معمولی، هر پاسخ هوش مصنوعی را به یک ردپای قابل حسابرسی تبدیل می‌کند. این ابزار با اولویت دادن به حاکمیت داده و حریم خصوصی، امکان…

۴ دقیقه خواندن۱
موتور استنتاج LLM پرسرعت در مرورگر
آموزش کاربردی

WebGPU چگونه اجرای مدل‌های زبانی بزرگ را به مرورگر منتقل کرد؟

پروژه WebLLM با بهره‌گیری از استاندارد WebGPU، امکان اجرای کامل مدل‌های زبانی بزرگ را بدون نیاز به سرور و مستقیماً در مرورگر فراهم می‌کند. این رویکرد با حذف پردازش‌های ابری، حریم…

۱۳ دقیقه خواندن۱
حلقه یادگیری توالی - شماره ۹۲۵: آشنایی با Fable و Mythos ۵.۱، GLM-۵.۳-Flash و Qwen ۳.۸

رقابت آنتروپیک و علی‌بابا برای کاهش هزینهٔ استنتاج عامل‌های هوش مصنوعی

سه آزمایشگاه بزرگ هوش مصنوعی مدل‌هایی را برای کاهش هزینه‌های عملیاتی عامل‌های خودمختار در وظایف طولانی‌مدت معرفی کردند. تمرکز این به‌روزرسانی‌ها بر ایجاد تعادل میان قدرت استدلال و…

۱ دقیقه خواندن