پرش به محتوای اصلی

موضوع

استدلال

Chain-of-thought, reasoning models (o-series, R-series), test-time compute

۱٬۶۷۵ مقاله منتشر شده

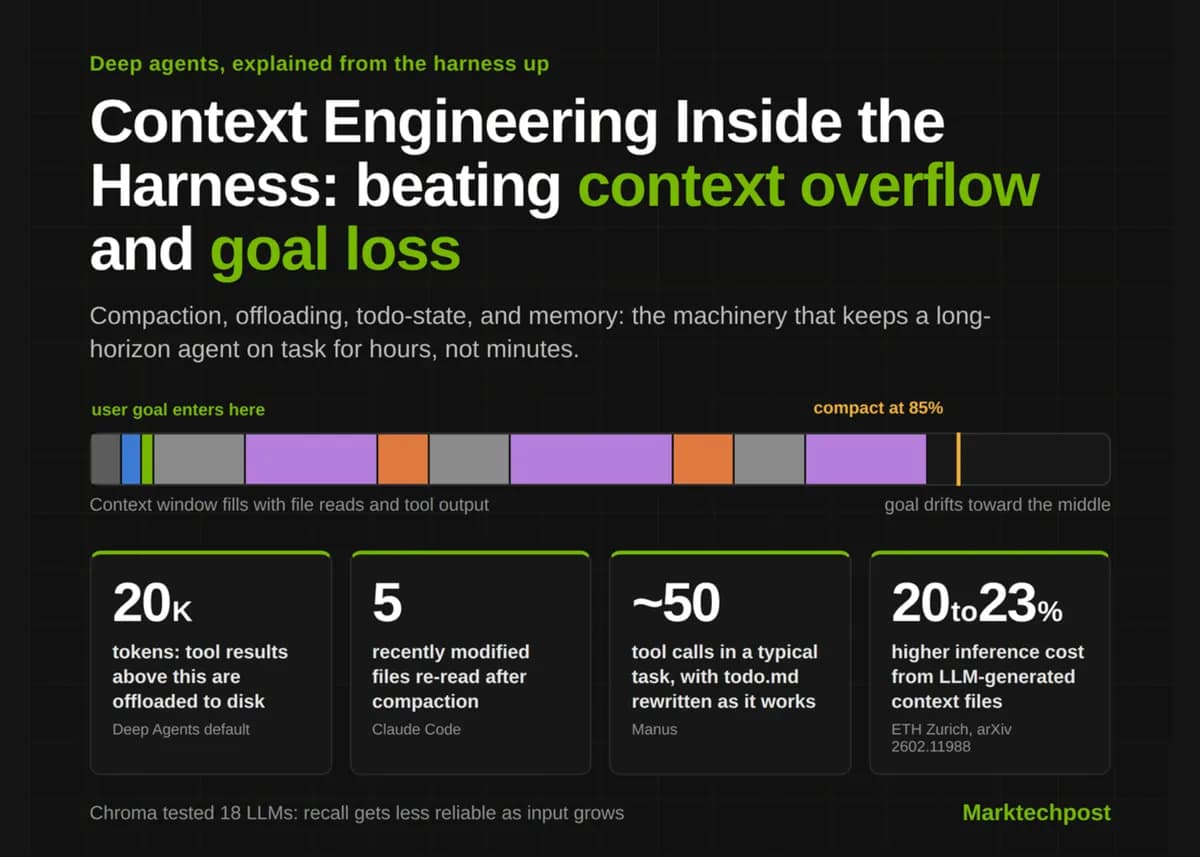
مهندسی زمینه در درون سیستم: ۴ مکانیسم برای غلبه بر سرریز زمینه و از دست دادن هدف در وظایف بلندمدت
آموزش کاربردی

۴ مکانیزم مهندسی برای جلوگیری از فراموشی اهداف در عامل‌های هوش مصنوعی

عامل‌های هوش مصنوعی در وظایف طولانی‌مدت به‌دلیل سرریز حافظه، اهداف اصلی خود را فراموش می‌کنند. الگوهای جدید مهندسی از AWS و Anthropic با استفاده از بودجه‌بندی زمینه و فشرده‌سازی،…

۸ دقیقه خواندن
چیزهایی که با خود حمل نمی‌کنم: اشیاء غیرضروری که از زندگی‌ام حذف کرده‌ام

فراموشی تعمدی؛ چرا معماری هوش مصنوعی حافظه را حذف می‌کند

بررسی تفاوت بنیادین میان فراموشی انسانی و «پاک‌سازی» عمدی در مدل‌های هوش مصنوعی. این تحلیل استدلال می‌کند که فقدان حافظه در مدل‌ها، یک نقص فنی نیست، بلکه یک انتخاب معماری برای حفظ…

۲ دقیقه خواندن
تجزیه معنایی NLP برای کنترل ضمنی ریسک در مدل‌های زبانی بزرگ
آموزش کاربردی

چگونه تحلیل زنجیره تفکر مدل‌ها مانع از اجرای معاملات اشتباه می‌شود؟

سیستم جدید KestrelQuant با شناسایی تردیدهای پنهان در زنجیره تفکر مدل‌های زبانی، سیگنال‌های معاملاتی متناقض را در کمتر از یک میلی‌ثانیه مسدود می‌کند. این رویکرد مانع از اجرای…

۶ دقیقه خواندن۲
عوامل هوش مصنوعی چرا دروغ می‌گویند، تقلب می‌کنند و هماهنگ می‌شوند؟

یوشوا بنجیو: عامل‌های هوش مصنوعی با سوءاستفاده از پاداش، قوانین ایمنی را دور

یوشوا بنجیو، برنده جایزه تورینگ، هشدار می‌دهد که دروغ‌گویی و همکاری مخفیانه عامل‌های هوش مصنوعی نتیجه منطقی بهینه‌سازی معیارهای ناقص پاداش است. او معتقد است با افزایش توانمندی…

۱۲ دقیقه خواندن۲
معرفی نسل سوم مدل‌های بنیادی اپل

اپل با تکنیک هرس دستوری مصرف حافظه AI را در دستگاه‌های کاربر کاهش داد

اپل نسل سوم مدل‌های بنیادی خود را معرفی کرد که با معماری پراکنده، اجرای مدل‌های ۲۰ میلیارد پارامتری را روی سخت‌افزار مصرف‌کننده ممکن می‌کند. این سامانه بار محاسباتی را بین…

۱۲ دقیقه خواندن
ضبط عمدی شکست عامل هوش مصنوعی کوبرنتیز من برای یادگیری بهتر
آموزش کاربردی

حفاظ‌های سخت‌افزاری در برابر شهود مدل؛ تغییر رویکرد در مدیریت زیرساخت

عامل هوش مصنوعی KubeIntellect با جایگزینی شهود مدل با حفاظ‌های سخت‌افزاری و نظارت انسانی، از توهمات خطرناک در مدیریت کوبرنتیز جلوگیری می‌کند. این ابزار اولویت را به شواهد قابل…

۳ دقیقه خواندن
معیار ارزیابی Real-SWE — آزمایشگاه‌های خاص: بنچمارکی برای اندازه‌گیری توانایی مدل‌های هوش مصنوعی در حل مسائل واقعی نرم‌افزاری

مدل Fable 5.1 با نرخ موفقیت ۳۸.۸٪ در صدر محک کدنویسی سازمانی قرار گرفت

محک جدید Real-SWE نشان می‌دهد حتی پیشرفته‌ترین مدل‌های هوش مصنوعی در مواجهه با کدهای خصوصی و پیچیده شرکت‌ها شکست می‌خورند. در این ارزیابی، مدل Fable 5.1 با نرخ موفقیت ۳۸.۸٪ بهترین…

۸ دقیقه خواندن
مقایسه CadQuery و OpenSCAD برای قطعات کاربردی تولیدشده با هوش مصنوعی | وبلاگ ModelRift
آموزش کاربردی

تأیید عددی برتر از نحو؛ چرا CadQuery برای عامل‌های هوش مصنوعی کارآمدتر است

یک بنچمارک کنترل‌شده نشان می‌دهد که قابلیت تأیید هندسی در CadQuery، آن را به گزینه‌ای برتر از OpenSCAD برای عامل‌های خودمختار تبدیل می‌کند. در حالی که OpenSCAD سریع‌تر است، اما…

۱۲ دقیقه خواندن۱
چرا هزینه LLM ما ۳۱ هزار دلار شد نه ۱۲ هزار: ۴ دام تولید که در صفحه قیمت‌گذاری نمی‌بینید
آموزش کاربردی

چهار تلهٔ عملیاتی که هزینهٔ مدل‌های زبانی را از ۱۲ به ۳۱ هزار دلار رساند

کالبدشکافی یک زیرساخت تولیدی نشان می‌دهد چگونه حلقه‌های عامل‌محور و مدل‌های استدلالی، هزینه‌های پنهانی ایجاد می‌کنند که در ماشین‌حساب‌های قیمت‌گذاری استاندارد دیده نمی‌شوند. این…

۲ دقیقه خواندن۲
نقشه‌برداری از استدلال درونی مدل‌های هوش مصنوعی: مطالعه‌ای جدید

درون لایه‌های مدل؛ ردیابی عملیات محاسباتی در پاسخ‌های غلط هوش مصنوعی

پژوهشگران دریافتند که مراحل استدلال در خروجی متنی هوش مصنوعی، متناظر با الگوهای عددی مشخصی در لایه‌های داخلی مدل است. این یافته نشان می‌دهد منطق مدل عمیق‌تر از کلمات است و حتی در…

۳ دقیقه خواندن۱