پرش به محتوای اصلی

موضوع

استدلال

Chain-of-thought, reasoning models (o-series, R-series), test-time compute

۱٬۶۷۶ مقاله منتشر شده

برنامه‌ریزی عصبی-نمادین تطبیقی برای ماموریت‌های بررسی زمین‌شناسی سیاره‌ای با محدودیت‌های سیاستی بلادرنگ
آموزش کاربردی

چطور ترکیب یادگیری تقویتی و نمادین ایمنی کاوشگرهای فضایی را تضمین می‌کند؟

یک چارچوب جدید به نام ANSP با ترکیب یادگیری تقویتی و استدلال نمادین، مدیریت کاوشگرهای خودمختار سیاره‌ای را متحول کرده است. این سیستم اجازه می‌دهد ربات‌ها اهداف علمی را دنبال کنند…

۱۰ دقیقه خواندن
مقایسه کلود پرو و چت‌جی‌پی‌تی پلاس در ۲۰۲۶: کدام دستیار هوشمند را انتخاب کنید؟
زندگی با AI

کلود پرو در برابر چت‌جی‌پی‌تی پلاس؛ تفکیک ابزارهای جراحی و سوئیسی

مقایسه اشتراک‌های ۲۰ دلاری آنتروپیک و اوپن‌ای‌آی در سپتامبر ۲۰۲۶ نشان می‌دهد که کلود پرو در کدنویسی فنی و تحلیل اسناد طولانی پیشتاز است، در حالی که چت‌جی‌پی‌تی پلاس در تطبیق‌پذیری…

۵ دقیقه خواندن
گوگل مدل Gemini 3.8 Flash را با نسخه امنیت سایبری عرضه کرد

گوگل زمان شناسایی حفره‌های امنیتی را از چند ماه به چند ساعت رساند

گوگل مدل Gemini 3.8 Flash و نسخه تخصصی Cyber را برای شناسایی خودکار آسیب‌پذیری‌ها و وصله‌زنی سریع عرضه کرد. این مدل‌ها با قابلیت تنظیم سطح استدلال، هزینه‌های عملیاتی عامل‌های…

۴ دقیقه خواندن
هوش مصنوعی عامل‌محور در مقابل هوش مصنوعی مولد: تفاوت‌های کلیدی
آموزش کاربردی

عامل‌های هوش مصنوعی: گذار از تولید محتوا به اجرای هدفمند

صنعت هوش مصنوعی از مدل‌های واکنشی که صرفاً محتوا تولید می‌کنند، به سمت سامانه‌های عامل‌محور حرکت می‌کند که قادر به برنامه‌ریزی، استفاده از ابزار و اصلاح خودکار خطاها هستند. این…

۸ دقیقه خواندن
مدل ۴ میلیارد پارامتری Spark-X2.5-4B با عملکردی معادل مدل‌های ۲ تا ۳ برابر بزرگ‌تر در وظایف عامل، کد و ریاضی.

مدل Spark-X2.5-4B در کدنویسی و استدلال از رقبای ۱۲ میلیاردی پیشی گرفت

مدل باز Spark-X2.5-4B با وجود اندازه کوچک، در وظایف عامل‌محور، ریاضیات و کدنویسی عملکردی مشابه مدل‌هایی با اندازه سه برابر خود نشان داد. این مدل در چندین محک کلیدی، رقبایی چون…

۱ دقیقه خواندن
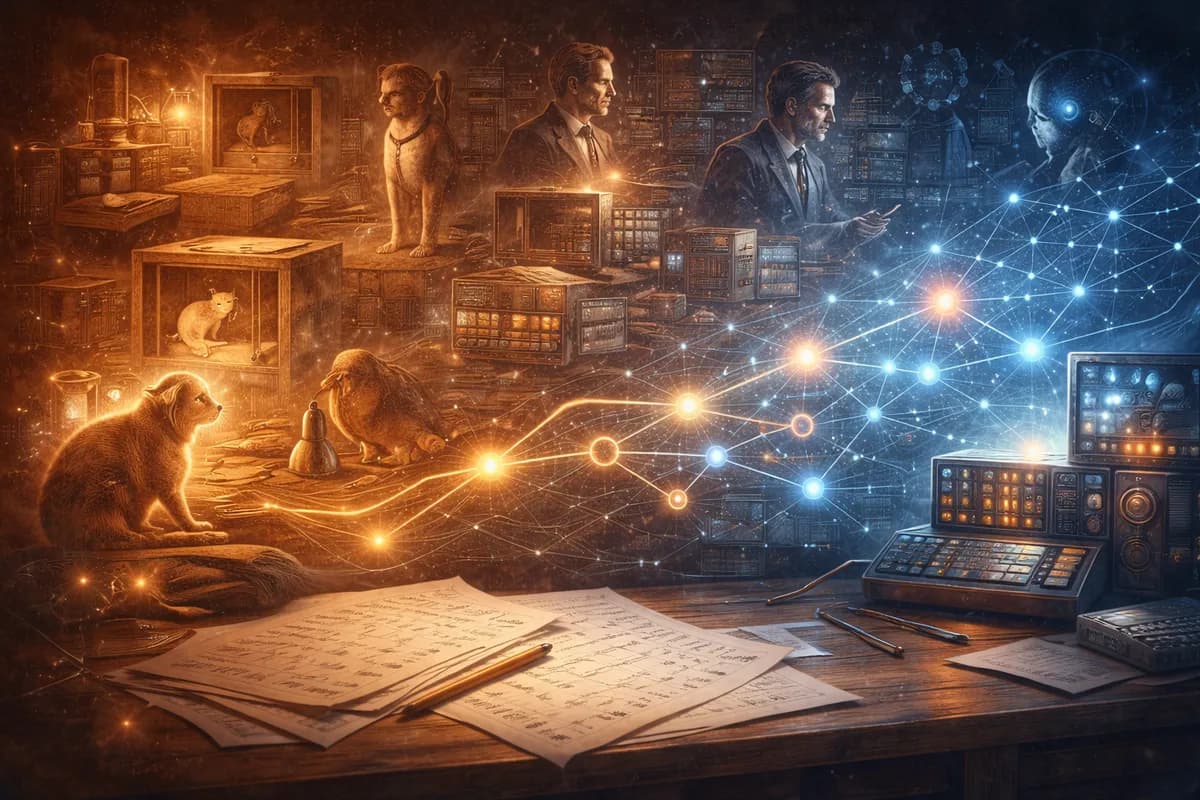
شکل ۱: بنیان‌های زیستی یادگیری تقویتی و قانون اثر تورندایک (۱۸۹۸–۱۹۴۹)
آموزش کاربردی

ریشه‌های بیولوژیک یادگیری تقویتی؛ از جعبه‌های ثورندایک تا شبکه‌های عصبی

یادگیری تقویتی مدرن بر پایه حلقه‌های رفتاری است که روان‌شناسان بین سال‌های ۱۸۹۸ تا ۱۹۴۹ کشف کردند. مفاهیمی چون پاداش، ارزش و وزن‌ها، دهه‌ها پیش از ظهور اولین پردازنده‌های گرافیکی…

۱۳ دقیقه خواندن۲
نسخه ۱.۳ موز اسپارک: هوش مصنوعی خلاق برای تولید محتوا با سرعت و کیفیت بالاتر

مدل Muse Spark 1.3 متا مصرف توکن‌ها در کدهای پیچیده را ۲۵٪ کاهش داد

متا مدل Muse Spark 1.3 را برای بهینه‌سازی گردش‌های کاری عامل‌محور و وظایف مهندسی منتشر کرد. این به‌روزرسانی با کاهش چشمگیر توکن‌ها و فراخوانی ابزارها، پایداری مدل در اجرای دستورات…

۴ دقیقه خواندن
ریاضیدانان روس به مدل‌های هوش مصنوعی آموختند بدون کلام با هم گفتگو کنند

تبادل وزن‌ها در برابر تبادل متن؛ روشی ارزان‌تر برای اتصال مدل‌های AI

استارتاپ Mostik روشی را ابداع کرده که مدل‌های هوش مصنوعی به‌جای تبادل متن، از طریق مقادیر ریاضی وزن‌ها با یکدیگر ارتباط برقرار کنند. این تکنیک به مدل‌های کوچک اجازه می‌دهد هوشمندی…

۴ دقیقه خواندن۲
جمنای ۳.۸ فلش: سومین مدل اقتصادی گوگل در شش هفته، در حالی که مدل‌های پیشرو همچنان غایب‌اند

جمینای ۳.۸ فلش با امتیاز ۷۳.۷٪ در DeepSWE رقیب مدل‌های پیشرو شد

گوگل مدل اقتصادی Gemini 3.8 Flash را با عملکردی در سطح مدل‌های گران‌قیمت در کدنویسی و امنیت سایبری معرفی کرد. با وجود قیمت رقابتی، مصرف بالای توکن در استدلال‌های پیچیده ممکن است…

۴ دقیقه خواندن۱