پرش به محتوای اصلی

موضوع

استدلال

Chain-of-thought, reasoning models (o-series, R-series), test-time compute

۱٬۶۸۱ مقاله منتشر شده

مدیرعامل پانگرام: مدل‌های زبانی با تکرار استدلال‌های یکسان خود را لو می‌دهند

خوشه‌های منطقی: ردپای پنهان هوش مصنوعی در ساختار استدلال‌ها

مدیرعامل شرکت Pangram معتقد است مدل‌های زبانی با وجود تسلط بر دستور زبان، فاقد تنوع استدلالی انسان‌ها هستند. این ابزار تشخیص AI از طریق شناسایی الگوهای ساختاری و محدود بودن طیف…

۱ دقیقه خواندن۱
DFlash: پیش‌نویسی بلوک‌های کامل توکن به صورت موازی برای افزایش ۱۵ برابری توان عملیاتی در پردازنده‌های انویدیا بلک‌ول

روش DFlash توان عملیاتی تراشه‌های Blackwell انویدیا را ۱۵ برابر کرد

پژوهشگران دانشگاه سن‌دیگو با معرفی DFlash، رمزگشایی گمانه‌زنانه را از حالت تک‌به‌تک به بلوک‌های موازی تغییر دادند. این متد بدون کاهش کیفیت خروجی، سرعت استنتاج را در سخت‌افزارهای…

۵ دقیقه خواندن۱
عوامل هوشمند در محیط شبیه‌سازی شده Qwen-AgentWorld در حال تعامل و انجام وظایف پیچیده هستند.

شبیه‌سازی محیط‌های پیچیده با زنجیره تفکر بلند در Qwen-AgentWorld

پژوهشگران مجموعه‌ای از مدل‌های جهانی زبان به نام Qwen-AgentWorld را معرفی کردند که قادر به شبیه‌سازی محیط‌های عامل‌محور در هفت دامنه مختلف است. این مدل‌ها با پیش‌بینی دینامیک محیط…

۲ دقیقه خواندن۱
نمایش ساختار Sparse Attention در مدل MiniMax M3: کاهش پیچیدگی محاسباتی از O(n²) به O(n) با استفاده از انتخاب هوشمندانه توکن‌ه

«بهینه‌سازی استنتاج طولانی»؛ هدف اصلی در طراحی مدل وزن‌باز M3

مدل وزن‌باز M3 با پنجره متنی یک میلیون توکنی و قابلیت‌های چندوجهی معرفی شد. این مدل با استفاده از معماری توجه پراکنده (MSA)، هزینه محاسباتی استنتاج در متون طولانی را به‌شدت کاهش…

۴ دقیقه خواندن
کد عدد اشتباه را گرفت. من باید داستان اشتباه را می‌گرفتم.
آموزش کاربردی

پروتکل لایه‌بندی شواهد؛ راهکار جدید برای توقف توهمات روایتی در سیستم‌های

یک چارچوب ساختاری جدید برای سیستم‌های معاملاتی هوش مصنوعی، «اعداد بد» (خطاهای عددی) را از «روایت‌های بد» (ادعاهای بدون دلیل) تفکیک می‌کند. این پروتکل از ارتقای سطح ادعاها به…

۶ دقیقه خواندن۲
یادگیری تقویتی با پاداش‌های قابل تأیید: چرا هوش مصنوعی دارد خودش تکالیفش را تصحیح می‌کند
آموزش کاربردی

پژوهش RLVR: جایگزینی بازخوردهای انسانی با تست‌های واحد در کدنویسی

یادگیری تقویتی با پاداش‌های قابل‌تأیید (RLVR) جایگزین بازخوردهای گران‌قیمت انسانی شده و از تست‌های واحد و اثبات‌های ریاضی برای آموزش مدل‌ها استفاده می‌کند. این سازوکار اجازه…

۶ دقیقه خواندن
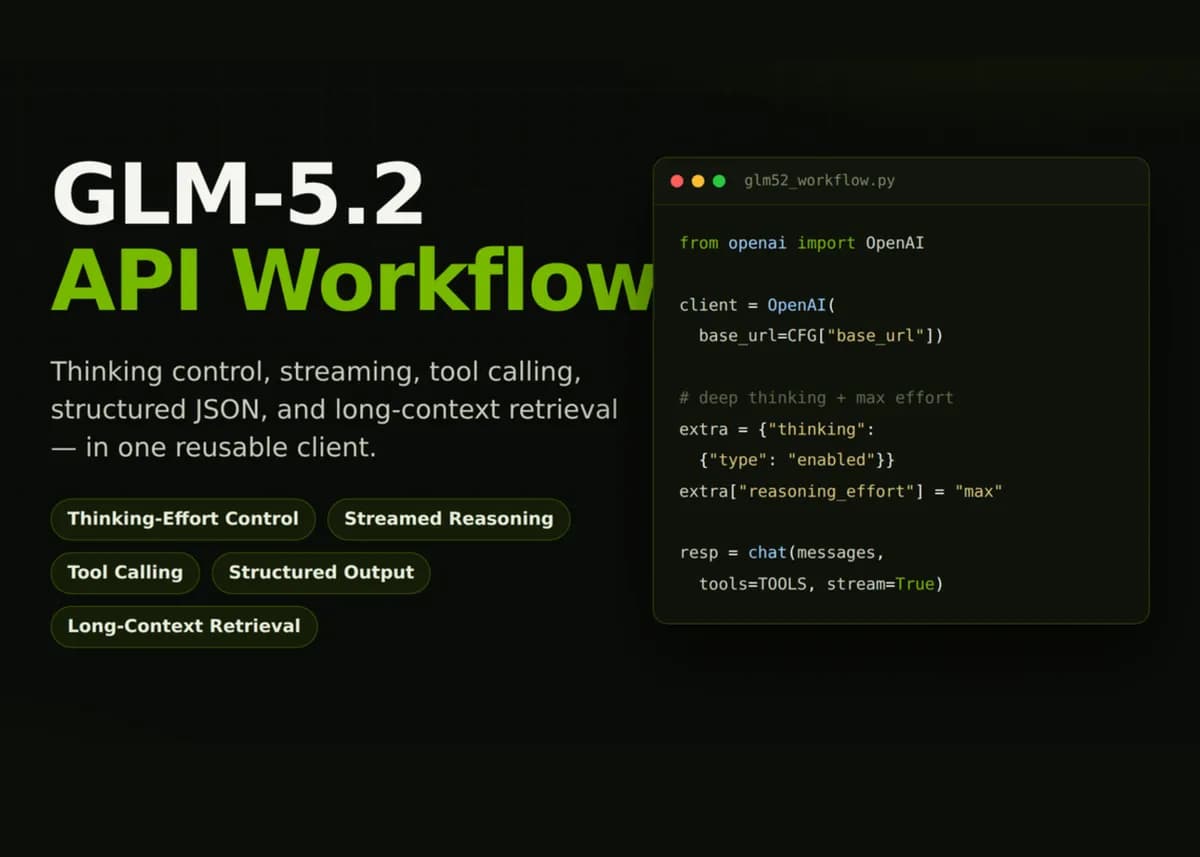
راهنمای عملی API سازگار با OpenAI در GLM-5.2: تلاش استدلالی، فراخوانی تابع و بازیابی متن طولانی
آموزش کاربردی

راهنمای عملی GLM-5.2: ادغام سه قابلیت کلیدی در جریان‌های کاری پایتون

راهنمای عملی جدیدی نحوه ادغام مدل GLM-5.2 در جریان‌های کاری پایتون را با استفاده از APIهای سازگار با OpenAI نشان می‌دهد. این پیاده‌سازی بر کنترل دقیق تلاش استدلالی، فراخوانی تابع…

۹ دقیقه خواندن