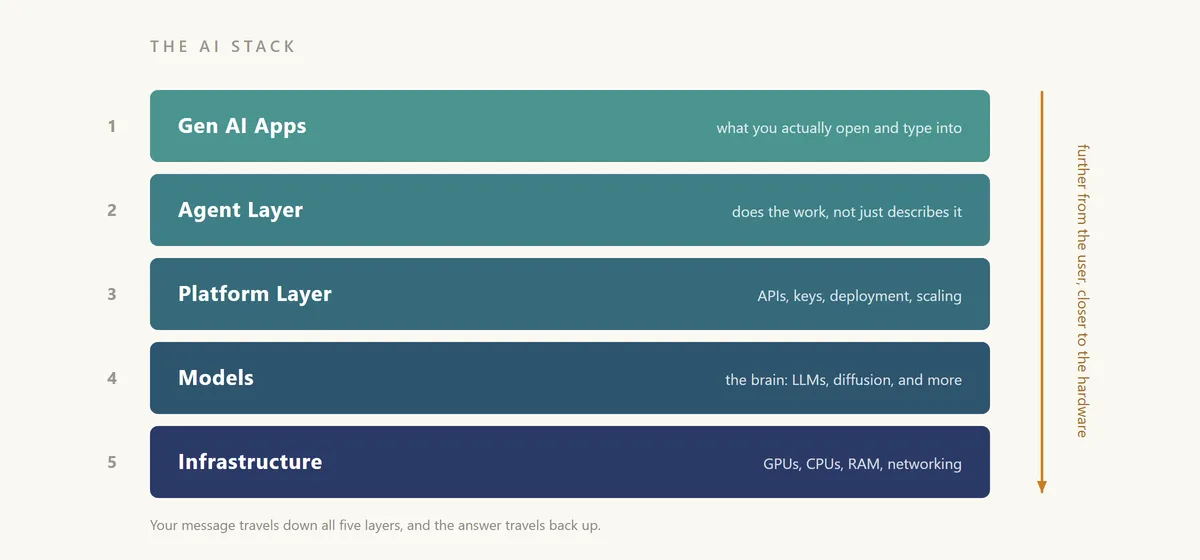
یک پرامپت ساده در ChatGPT پیش از آنکه پاسخ روی صفحه ظاهر شود، زنجیرهای از اتفاقات را در پنج لایهٔ معماری مختلف فعال میکند. اگر تصور میکنید تمام این جادو مدیون «مدل» است، باید بدانید که مدل تنها یکی از قطعات یک پشتهٔ تولیدی (Production Stack) بسیار پیچیدهتر است.
به نقل از راهنمای فنی منتشر شده در dev.to در ۳۰ سپتامبر ۲۰۲۶، شکاف میان یک شبکه عصبی (Neural Network) — که شبیه نقشهٔ مترویی است که سیگنالها را از ورودی به جواب میرساند — و یک محصول کاربردی، توسط لایههایی پر شده است که همه چیز، از حافظه گرفته تا مسیریابی GPUها را مدیریت میکنند. برای توسعهدهندگان، درک این ساختار تفاوت میان استفادهٔ ساده از یک API و ساخت یک محصول مقیاسپذیر است. هوش مصنوعی اکنون به بخشی ضروری از زندگی تبدیل شده و به توسعهدهندگان اجازه میدهد مانند یک «ارتش تکنفره» عمل کنند و کارهایی را انجام دهند که پیشتر نیازمند یک تیم کامل بود. این تحول در نقش توسعهدهندگان را میتوان در تغییر ماهیت مهندسی نرمافزار از مکانیک کدنویسی به ارکستراسیون مشاهده کرد که در آن تمرکز از سینتکس به مدیریت سیستمها منتقل شده است.
برای درک بهتر، پشتهٔ هوش مصنوعی را مثل یک رستوران تصور کنید. مدل همان سرآشپز است، اما شما هنوز به پیشخدمتی برای ثبت سفارش، مدیری برای رزرو میز و آشپخانهای با برق و گاز نیاز دارید تا غذا آماده شود. بدون این لایههای محیطی، سرآشپز فقط فردی ماهر است که هیچ راهی برای خدمترسانی به مشتری ندارد. برای بهرهبرداری کامل از این ابزارها، کاربران باید در مهندسی پرامپت (Prompt Engineering) مهارت یابند؛ یعنی ارائه پرامپتهای دقیق و آموزنده همراه با مثالها و استفاده از تکرار (Iteration) برای اصلاح و رسیدن به هدف نهایی.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، هر لایه از این پشته میتواند نقطهٔ ضعف یا قوت سیستم باشد.
لایههای اپلیکیشن و عامل
بالاترین لایه، اپلیکیشن هوش مصنوعی زاینده (Gen AI App) یا همان لایه اپلیکیشن است. این لایه، رابط کاربری کاربر-محور است؛ مانند وبسایتهای رسمی Claude، DeepSeek، Gemini یا ChatGPT. این لایه «فکر» نمیکند؛ بلکه وظیفه مدیریت تاریخچهٔ چت شما، رندر کردن متنها و مدیریت آپلود فایلها را بر عهده دارد. مدل بهطور ذاتی مفهومی از «گفتگو» ندارد؛ این اپلیکیشن است که با مدیریت وضعیت (State) تعامل، توهم یک گفتگو را ایجاد میکند.
در زیر لایهٔ اپلیکیشن، لایهٔ عامل (Agent Layer) قرار دارد. اینها کارگران دیجیتالی با مغز فعال هستند که قادر به اجرای اقدامات پیچیده و چندمرحلهای هستند. تفاوت آنها با هوش مصنوعی ساده در این است که بهجای توصیف نحوهٔ انجام کار، واقعاً آن را انجام میدهند. آنها اطلاعات را از کاربر جمعآوری کرده، با محیط تعامل میکنند، تصمیم میگیرند و بر اساس اطلاعات دریافتی، اقدامات را اجرا میکنند.
برای مثال، یک عامل رستوران فقط پیشنهاد نمیدهد که کجا غذا بخورید، بلکه میتواند:
- در اینترنت جستوجو کند تا بهترین رستوران را بیابد.
- تقویم شخصی شما را برای یافتن زمان خالی بررسی کند.
- میز را مستقیماً رزرو کند.
- برای طرف مقابل ایمیل یا پیام دعوت بفرستد.
لایه پلتفرم: پل نامرئی
لایه پلتفرم (Platform Layer) شاید حیاتیترین بخش برای محیطهای تولیدی باشد. یک مدل آموزشدیده در واقع فایلی عظیم از اعداد است که روی یک ماشین قرار دارد. این فایل هیچ راهی برای دسترسی ندارد، نمیداند کاربر کیست و نمیتواند هزاران درخواست همزمان را مدیریت کند. پلتفرم این فایل را به چیزی تبدیل میکند که یک اپلیکیشن بتواند واقعاً آن را فراخوانی کند.
این لایه وظایف نامرئی اما حیاتی متعددی را بر عهده دارد:
- APIها و احراز هویت: این لایه نقطه اتصال (Endpoint) را برای کدها فراهم میکند. از کلیدهای API برای تأیید هویت شما استفاده میکند، که از همین طریق ارائهدهنده میفهمد هزینه باید به کدام حساب شارژ شود.
- محدودیت نرخ و سهمیهها (Rate Limiting and Quotas): پلتفرم تصمیم میگیرد که شما اجازه دارید چقدر و با چه سرعتی از مدل استفاده کنید. این دقیقاً منشأ خطای رایج «429» است که توسعهدهندگان هنگام عبور از محدودیتها با آن مواجه میشوند.
- مسیریابی و مقیاسدهی: پلتفرم ماشینی با واحد پردازش گرافیکی (GPU) آزاد پیدا کرده و درخواست شما را به آنجا مسیریابی میکند و با افزایش ترافیک، ماشینهای بیشتری را فعال میکند.
- مانیتورینگ و لاگ: سوابقی از تعداد توکن (Token) مصرف شده، مدت زمان پاسخدهی به درخواست و دلایل شکست درخواستهای خاص را ثبت میکند.
- ابزارهای جانبی: پلتفرمها قطعات مکمل مانند پایگاهدادههای برداری (Vector Databases) برای ذخیره دادههای خصوصی، حفاظها (Guardrails) برای فیلتر کردن خروجیهای نامطلوب و ابزارهایی برای ارزیابی مدل یا Fine-tuning فراهم میکنند.
پلتفرمهایی مثل Amazon Bedrock، Google Vertex AI و Microsoft Foundry، در کنار APIهایی که توسط خودِ سازندگان مدلها اداره میشوند، نمونههای بارز این لایه هستند. برای کسانی که تجربه ساخت Backend دارند، این لایه آشناست زیرا با مسائل استانداردی مثل احراز هویت، مقیاسدهی و لاگگیری سروکار دارد، با این تفاوت که در انتهای مسیر بهجای یک پایگاهداده، یک مدل قرار دارد.
مدلها و زیرساخت
لایه چهارم شامل خودِ مدلها است؛ مغز عملیات که قدرت تولید هر چیزی از گفتگوهای ساده تا ویدیوها را فراهم میکند. این راهنما بین دو نوع اصلی تمایز قائل میشود:
۱. مدلهای زبانی بزرگ (LLM): بهینه شده برای کارهای متنی، ترجمه، نوشتن ایمیلها و گفتگوهای عمومی.
۲. مدلهای انتشار (Diffusion Models): طراحی شده برای تولید رسانه. این مدلها از نویزهای تصادفی شروع کرده و گامبهگام آن را پالایش میکنند تا یک تصویر یا ویدیوی منسجم پدیدار شود.
در نهایت، لایه زیرساخت (Infrastructure Layer) بنیاد فیزیکی است. این بخش، قسمت سختافزاری پشته است و شامل موارد زیر میشود:
- CPUها و GPUها
- حافظه RAM
- سختافزارهای شبکه
افزایش شدید تقاضا برای این لایه، محرک اصلی افزایش قیمت RAMهای ردهبالا و SSDها در بازار فعلی است.
جریان تولید
برای درک تعامل این لایهها، مسیر یک درخواست را از همان عامل رستوران دنبال کنید. وقتی عامل تصمیم میگیرد که نیاز به «فکر کردن» دارد، درخواستی به مدل میفرستد. این درخواست به یک API در لایه پلتفرم میرسد. پلتفرم کلید API را چک میکند، تأیید میکند که حساب کاربر اجازه استفاده از آن مدل خاص را دارد و بررسی میکند که محدودیت نرخ (Rate Limit) رد نشده باشد.
سپس پلتفرم ماشینی با GPU آزاد مییابد و درخواست را به آنجا میفرستد. مدل محاسبات ریاضی را انجام داده و پاسخ را برمیگرداند. در مسیر بازگشت، پلتفرم توکنهای مصرفی را میشمارد، در لاگ استفاده ثبت میکند و هزینه را از حساب کسر میکند. در نهایت، عامل پاسخ را دریافت کرده و به گام بعدی میرود. نه کاربر و نه عامل، هیچکدام مجبور نیستند به این فرآیندهای پسزمینه فکر کنند.
برای خواننده، این بدان معناست که «هوش مصنوعی» یک ابزار واحد نیست، بلکه یک سیستم هماهنگ است. اگر اپلیکیشن AI شما کند است، لزوماً مشکل از هوش مدل نیست؛ بلکه ممکن است یک مشکل مسیریابی در لایه پلتفرم یا یک محدودیت سختافزاری در لایه زیرساخت باشد.
این چرخش معماری، مزیت رقابتی را از «داشتن بهترین مدل» به «داشتن کارآمدترین پلتفرم و ارکستراسیون عاملها» منتقل میکند. برندگان در فضای هوش مصنوعی کسانی خواهند بود که کل این سفر پنجلایه را بهینه کنند، نه فقط مغز وسط آن را. در این مسیر، برای توسعهدهندگانی که نگران جایگاه خود هستند، استفاده از یک چارچوب سهلایه برای جلوگیری از تحلیل رفتن مهارتهای برنامهنویسی ضروری است تا ابزارهای AI را به جای جایگزین، به عنوان مکمل توانمندیهای خود به کار گیرند.
برای مشاهده این موضوع در عمل، سعی کنید گردشکار (Workflow) هوش مصنوعی خود را ممیزی کنید تا بفهمید کدام لایه بیشترین اصطکاک را در ابزارهای بهرهوری فعلی شما ایجاد میکند.
گام بعدی شما
- گردشکار ابزارهای AI خود را بررسی کنید تا بفهمید کجای مسیر (رابط کاربری، سرعت API یا مدل) بیشترین اصطکاک را ایجاد میکند.
- اگر توسعهدهنده هستید، بهجای تمرکز صرف روی پرامپت، روی لایه پلتفرم و مدیریت توکنها برای کاهش هزینه استنتاج تمرکز کنید.
- تفاوت عملکرد مدلهای مختلف را در پلتفرمهای ابری (مانند Vertex AI) تست کنید تا اثر لایه مسیریابی را ببینید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو