۱۷۸.۵ ثانیه اکنون به ۵۱.۱ ثانیه رسیده است. مؤسسه Ai2 با انتشار مدل AstaBrief 8B، سرعت تولید گزارشهای علمی باکیفیت را ۳.۵ برابر افزایش داد تا پرسشهای پژوهشی و گزیدههای متون علمی در یک مرحله به گزارشهای مستند تبدیل شوند.
پژوهشهای علمی به دقتی نیاز دارند که مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — اغلب در ارائه آن شکست میخورند. پژوهشگران صرفاً به دنبال پاسخ نیستند، بلکه شواهدی میخواهند که نتایج مطالعه را بیش از حد بزرگنمایی نکند. طبق گزارشهای فنی، ابزارهای فعلی یا در ارجاعات دچار توهم (Hallucination) — شبیه دوستی که خاطرهای را اشتباه تعریف میکند — میشوند یا یافتههای خاص را به ادعاهای کلی تبدیل میکنند که میتواند در مرحله سنتز دادهها گمراهکننده باشد.
تیم Ai2 با تکیه بر چارچوب ScholarQA، مدل AstaBrief را به عنوان «حالت سریع» در پلتفرم Asta توسعه داد. در حالی که «حالت تفکر» فعلی بر استدلالهای چندمرحلهای و گرانقیمت مدل Claude متکی است، AstaBrief یک جایگزین محلی و قابل دانلود برای مؤسساتی است که با دادههای حساس یا منتشرنشده سروکار دارند. همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، میزبانی شخصی برای دادههای محرمانه یک ضرورت است، نه یک انتخاب.
الزامات سنتز علمی
پژوهشهای علمی محدودیتهای خاصی را بر مدلهای زبانی تحمیل میکنند. دانشمندان برخلاف کاربران عادی، زمینههای گسترده و محدودیتهای متعددی را در پرسشهای خود میگنجانند. آنها ممکن است از مدل بخواهند رویکردهای مختلف را در حجم عظیمی از ادبیات پژوهشی، با در نظر گرفتن یک جمعیت، محیط یا روش خاص، مقایسه کند.
علاوه بر این، پژوهشگران به گزارشهای تولیدشده به عنوان ابزارهای کاری (Research Artifacts) نگاه میکنند، نه پاسخهای یکباره. این یعنی مدل باید دقیقاً همان چیزی را حفظ کند که شواهد پشتیبانی میکنند. یک شکست رایج در مدلهای فعلی، تمایل به تعمیم بیصدا نتایج است؛ مثلاً تبدیل یک نتیجه که در زمان گذشته گزارش شده به یک گزاره حال که جهانی به نظر میرسد، یا تبدیل یک یافته توصیفی به توصیهای برای پزشکان و سیاستگذاران.
این تعمیمها خطرناک هستند چون بدون ایجاد یک جمله صریحاً غلط، دامنه شواهد را گسترش میدهند. یک جمله ارجاعدادهشده ممکن است از نظر فنی به منبع مرتبط باشد، اما آنچه پژوهشگران واقعاً ثابت کردهاند را بیش از حد بزرگ جلوه دهد و گستره شواهد را به طور ظریفی تغییر دهد.
Ai2 این نیازها را در قالب ابتکار NSF OMAI بررسی میکند؛ یک طرح ملی در آمریکا برای ساخت زیرساختهای هوش مصنوعی کاملاً باز برای اکتشافات علمی که توسط Ai2 رهبری میشود. این ابتکار مستقیماً با جوامع علمی همکاری میکند تا نقاط ضعف مدلهای عمومی را شناسایی کند و بفهمد نیازها در حوزههای مختلف علمی و جریانهای کاری چگونه متفاوت است.
معماری سرعت
مدل AstaBrief بر پایه Qwen3-8B ساخته شده است. نوآوری اصلی نه در معماری پایه، بلکه در خط لوله تولید گزارش است. برخلاف مدلهای تجاری که گزارشها را بخشبهبخش مینویسند — فرآیندی که تأخیر (Latency) زیادی ایجاد میکند — AstaBrief آموزش دیده تا کل گزارش را در یک مرحله (Single Pass) تولید کند.
این رویکرد مراحل گرانقیمت خلاصهسازی قطعات متن و خوشهبندی (Clustering) را که در حالت تفکر Claude وجود داشت، حذف میکند. با حذف این مراحل، مدل عملکرد خود را حفظ کرده اما زمان تولید را در مقایسه با خط لولههای تجاری که در طول توسعه رصد شده بودند، تقریباً یک مرتبه بزرگی کاهش داده است. بر اساس مستندات، بیشتر آموزشها و ارزیابیهای این سیستم در سال ۲۰۲۵ تکمیل شده است.
استراتژی آموزش دادهمحور
تیم Ai2 برای دوری از یادگیری تقویتی (RL) گران و ناپایدار، فرمول سادهتری را انتخاب کرد: تنظیم نظارتشده (SFT) — مثل وقتی به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — و بهینهسازی مستقیم ترجیح (DPO). اگرچه کارهای قبلی مانند DR Tulu نشان دادند که RL میتواند تولید متون طولانی را بهبود بخشد، اما Ai2 برای ایجاد سیستمی که ارزانتر باشد، عیبیابی آن راحتتر باشد و از نظر عملیاتی قابل مدیریت باشد، SFT و DPO را برگزید.
جمعآوری دادههای SFT:
- پرسشهای منبع: تیم صدها هزار پرسش از Asta را تحلیل کرد. آنها دریافتند پژوهشگران خبره بهجای پرامپتهای کوتاه و کلیدواژهای، روابط پیچیده بین مفاهیم را ارسال میکنند.
- رفتار کاربر: تحلیلها نشان داد برخی پژوهشگران از مدلها برای ایدهپردازی استفاده میکنند، در حالی که برخی دیگر نقش محدودتری در سنتز، نظارت بر ادبیات پژوهشی یا یافتن الگوها برای مدل قائلاند. در تمام این گروهها، تقاضای ثابتی برای ردیابی شفافتر منابع و کنترل بیشتر بر زمینه (Context) مورد استفاده وجود دارد.
- فرآیند فیلتر کردن: برای تضمین کیفیت، ترافیک رباتها و دادههای تسترها حذف شد. آنها از یک مرحله فیلتر مبتنی بر LLM استفاده کردند تا پرسشهای غیرانگلیسی، درخواستهای غیرعلمی و پرامپتهای حاوی اطلاعات شخصی را حذف کنند.
- مجموعه داده: این کار منجر به ایجاد مجموعهای از ۹۰ هزار پرسش متمرکز بر پژوهش شد که از میان آنها، ۴۷ هزار نمونه آموزشی قابل استفاده استخراج گردید.
- خط لوله تولید: خروجیهای هدف با استفاده از خط لوله ScholarQA ایجاد شدند که متون را بازیابی و در بخشهای مختلف سازماندهی میکند. در این فرآیند از ترکیبی از مدلهای تجاری شامل Claude 3.5 Sonnet، Claude 3.7 Sonnet، o3، o4-mini و GPT-4.1 استفاده شد. این رویکرد در جهت تسهیل تحلیلهای پیچیده دادهای است، مشابه آنچه در قابلیتهای جدید ChatGPT برای تحلیل دادههای سازمانی مشاهده میکنیم.
ایجاد جفتهای DPO
برای اصلاح ترجیحات، ۶ هزار جفت گزارش از یک زیرمجموعه مجزا از پرسشها (که در SFT استفاده نشده بودند) ایجاد شد.
- جفتسازی: یک گزارش توسط خط لوله استاندارد ScholarQA (معمولاً Claude 3.5 یا 3.7 Sonnet) تولید شد. گزارش رقیب با دادن همان گزیدههای بازیابیشده به مدلهای o3، o4-mini، DeepSeek-V3 یا DeepSeek-R1 (بسته به هر نمونه) تولید گردید.
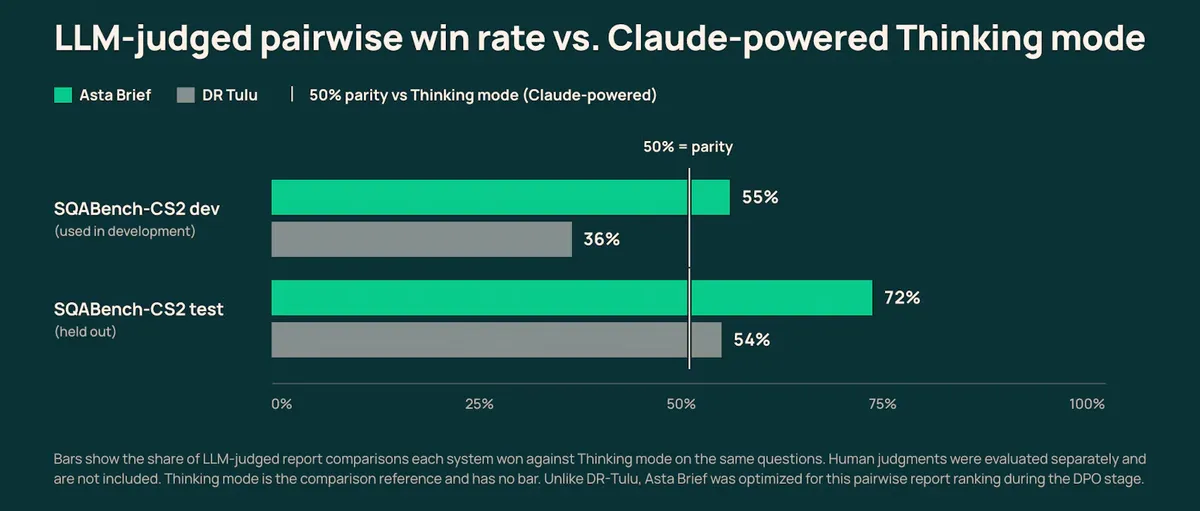
- سیستم داوری: دو مدل داور — GPT-4.1 و DeepSeek-R1 — هر جفت را مقایسه کردند. برای کاهش نویز، تیم تنها جفتهایی را نگه داشت که هر دو داور بر سر برنده توافق داشتند.
- همسویی انسانی: این رویکرد مبتنی بر داور، نرخ توافق ۹۵ درصدی با ترجیحات انسانی نشان داد و تضمین کرد که مجموعه ترجیحات پاک و قابل اعتماد است. این روش مانع از آن شد که خروجی یک مدل واحد به عنوان حقیقت مطلق در نظر گرفته شود.
حل مشکل ارجاعدهی
یکی از بزرگترین چالشها در هوش مصنوعی علمی، «مبنیسازی ارجاعات» (Citation Grounding) است. مدل ممکن است مقاله درستی را ذکر کند اما دامنه شواهد را تغییر دهد؛ مثلاً تبدیل یافتهای درباره یک نمونه کوچک به یک حقیقت جهانی. این یک شکل ظریف از بزرگنمایی است که در آن جمله از نظر فنی به منبع مرتبط است اما گستره ظاهری شواهد را گسترش میدهد.
برای مقابله با این موضوع، Ai2 چهار فیلتر آماری خاص را برای پاکسازی نمونههای آموزشی مصنوعی به کار گرفت:
- نسبت توکن خروجی به ورودی: حذف گزارشهایی که متن بیش از حد نسبت به شواهد تولید کرده بودند، زیرا این موضوع اغلب نشاندهنده نویز بود.
- ارتباط ارجاع: میانگین امتیازات ارتباط بازیابی مقالات ارجاعشده محاسبه شد؛ گزارشهایی که بیش از حد به شواهد با رتبه پایین متکی بودند، حذف شدند.
- تراکم ارجاع: اندازهگیری سهم جملاتی که حداقل یک ارجاع داشتند. گزارشهایی با بخشهای طولانی از متن بدون پشتیبانی، فیلتر شدند.
- تنوع ارجاع: اندازهگیری سهم مقالات ارجاعشده نسبت به کل مجموعه بازگردانده شده توسط خط لوله بازیابی، برای جلوگیری از اتکای بیش از حد به تعداد کمی از منابع.
فیلتر تراکم ارجاع بیشترین بهبود را ایجاد کرد. تیم دریافت که فیلترهای تهاجمیتر یا ترکیبات پیچیده فیلتر، بهبود معناداری ایجاد نمیکنند. این ثابت میکند که تخصص علمی کمتر به افزودن متن خام به پیشآموزش و بیشتر به کیفیت و رفتار دادههای پسآموزش بستگی دارد.
این یافته با تحقیقات کاربر همسو است که نشان میدهد دانشمندان سنتز موجز و ردیابی دقیق منابع را به خروجیهای طولانی ترجیح میدهند. پس از ایجاد یک چکپوینت SFT قوی، آموزش DPO عملکرد مدل را به سطحی رساند که با خط لوله مبتنی بر Claude و DR Tulu رقابتپذیر باشد.
محکها و کاربرد واقعی
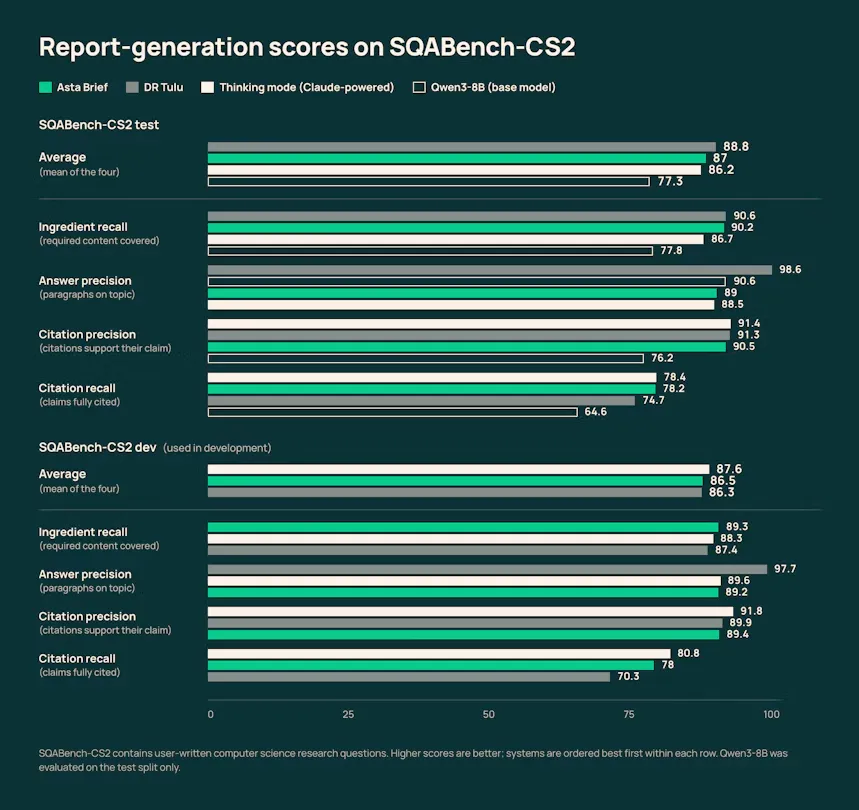
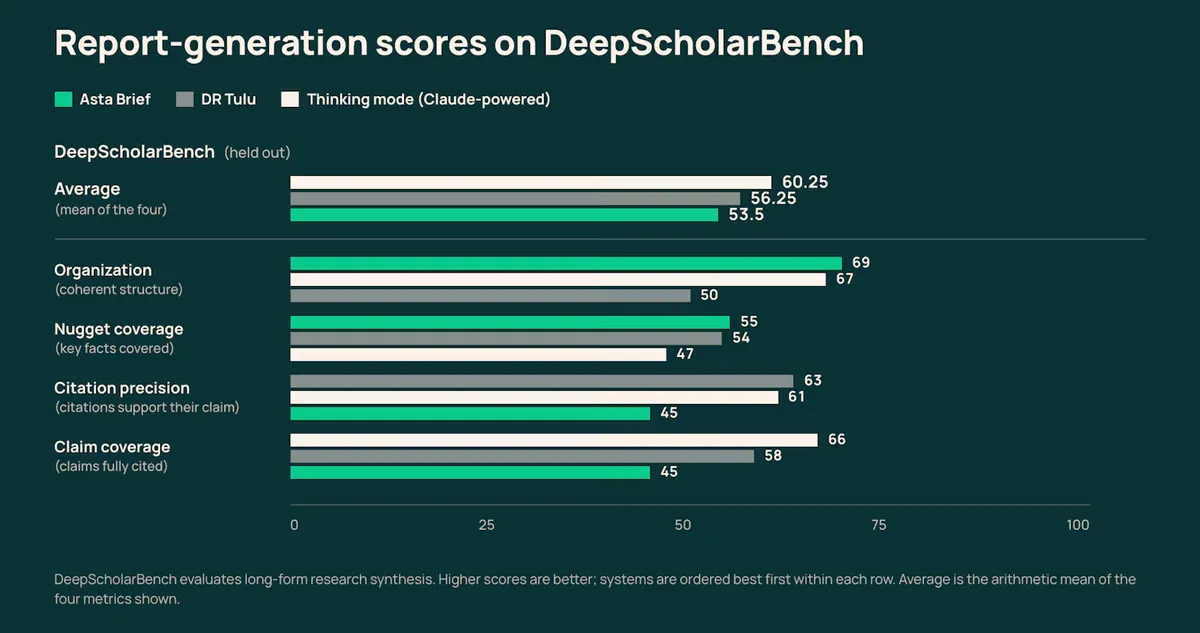
ارزیابیها با استفاده از SQABench-CS2 (مجموعهای از ۲۰۰ پرسش پژوهشی علوم کامپیوتر نوشته شده توسط کاربران) و DeepScholarBench (یک محک ۶۳ پرسشی برای سنتز طولانیمدت ساخته شده از مقالات اخیر ArXiv) انجام شد.
Ai2 چهار معیار اصلی را در طول توسعه رصد کرد:
۱. نمره دستورالعمل (Rubric score): میزان پوشش محتوای ضروری.
۲. دقت پاسخ: ارتباط هر پاراگراف با پرسش.
۳. دقت ارجاع: اینکه آیا ارجاع واقعاً از ادعای پیوست شده پشتیبانی میکند یا خیر.
۴. بازخوانی ارجاع (Citation recall): اینکه آیا ادعاها بهطور کامل توسط ارجاعات ارائه شده پشتیبانی میشوند.
AstaBrief در چندین معیار با خط لوله Claude و DR Tulu رقابت کرد. در یک مطالعه انسانی مجزا با ۱۴ پرسش، سه پژوهشگر علمی هر کدام ۴ تا ۵ پرسش ارائه کردند و گزارشها را بر اساس ترجیح، کامل بودن، ارتباط، سازماندهی و دقت ارجاع رتبهبندی کردند. در حالی که DR Tulu در ترجیح کلی برنده شد، دو پژوهشگر از سه نفر، AstaBrief را بهدلیل دقت بالاتر در ارجاعات ترجیح دادند.
در محیط عملیاتی، «حالت سریع» مورد استقبال قرار گرفته است. از میان ۳۷۴ کاربر، ۲۹.۱٪ آن را برای دو روز یا بیشتر استفاده کردند و کاربران بهطور متوسط ۳.۶۷ رشته گزارش تولید کردند. نکته قابل توجه این است که ۲۳٪ از کاربرانی که حالت سریع را امتحان کردند، بهطور انحصاری به آن کوچ کردند، در حالی که ۱۸٪ بسته به اهداف خود بین دو حالت جابجا میشوند (و برای حدود ۴۰٪ از رشتهها از حالت سریع استفاده میکنند). نرخ بازخورد مثبت حالت سریع ۸۴.۲٪ است که تقریباً با ۸۵.۲٪ حالت تفکر برابری میکند.
تحلیل: چرخش به سمت هوش مصنوعی علمی محلی
این انتشار نشاندهنده تغییری در نحوه استقرار هوش مصنوعی علمی است. Ai2 با فاصله گرفتن از مدل APIهای تجاری «هرچه بزرگتر بهتر»، ثابت کرد که یک مدل ۸ میلیاردی با تنظیم دقیق و فیلتر جراحیشده برای ارجاعات، میتواند سنتزهای پیچیده را مدیریت کند.
برای پژوهشگر، این به معنای پایان تضاد بین حریم خصوصی و قدرت است. مؤسسات اکنون میتوانند AstaBrief را روی زیرساختهای خود و پشت دیوارهای آتش (Firewalls) اجرا کنند؛ موضوعی حیاتی برای پژوهشهایی که پرسشهای آنها افشای کارهای حساس یا منتشرنشده است که نمیتوان آنها را به API شخص ثالث ارسال کرد. این چالشهای عملیاتی در پیادهسازی مدلهای تخصصی، یادآور درسهای سختی است که در ساخت عاملهای هوش مصنوعی برای تحلیل بازارهای پیچیده آموخته شده است.
گامهای بعدی
Ai2 اکنون در حال بررسی یادگیری ترجیحات دقیقتر، رویکردهای قویتر RAG-plus-RL و قابلیتهای چند-گامه (Multi-turn) و چند-ابزاری است. آنها همچنین در حال بررسی تجزیه پرسشها (Query Decomposition) و منابع دادههای علمی اضافی هستند.
ارزیابیهای آینده فراتر از بررسیهای ساده ارجاع خواهد رفت تا بپرسد آیا مدل «دامنه شواهدی» منابع خود را حفظ میکند یا خیر. این شامل تست برای ایجاز، سازماندهی و جلوگیری از تبدیل یافتههای خاص به تعمیمهای گسترده یا تبدیل نتایج توصیفی به توصیههای کاربردی است.
AstaBrief به عنوان یک پله به سوی نسخههای آینده Olmo و سایر مدلهایی است که بهطور خاص برای اکتشافات علمی طراحی شدهاند. پژوهشگران در حال حاضر میتوانند وزنهای AstaBrief و یک جریان کاری نمونه را از Hugging Face دانلود کنند تا گزارشهایی از PDFهای خود بسازند.
گام بعدی شما
- اگر پژوهشگر هستید، وزنهای مدل را از Hugging Face دانلود کرده و روی دادههای PDF خود آزمایش کنید.
- برای کاهش هزینه استنتاج در پروژههای علمی، جایگزینی مدلهای غولپیکر با مدلهای تخصصی ۸ میلیاردی را بررسی کنید.
- دقت ارجاعات خروجی مدلهای خود را با فیلتر «تراکم ارجاع» بسنجید تا از تعمیمهای نادرست جلوگیری کنید.
اما داستان سختافزاری اجرای این مدلهای محلی حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو