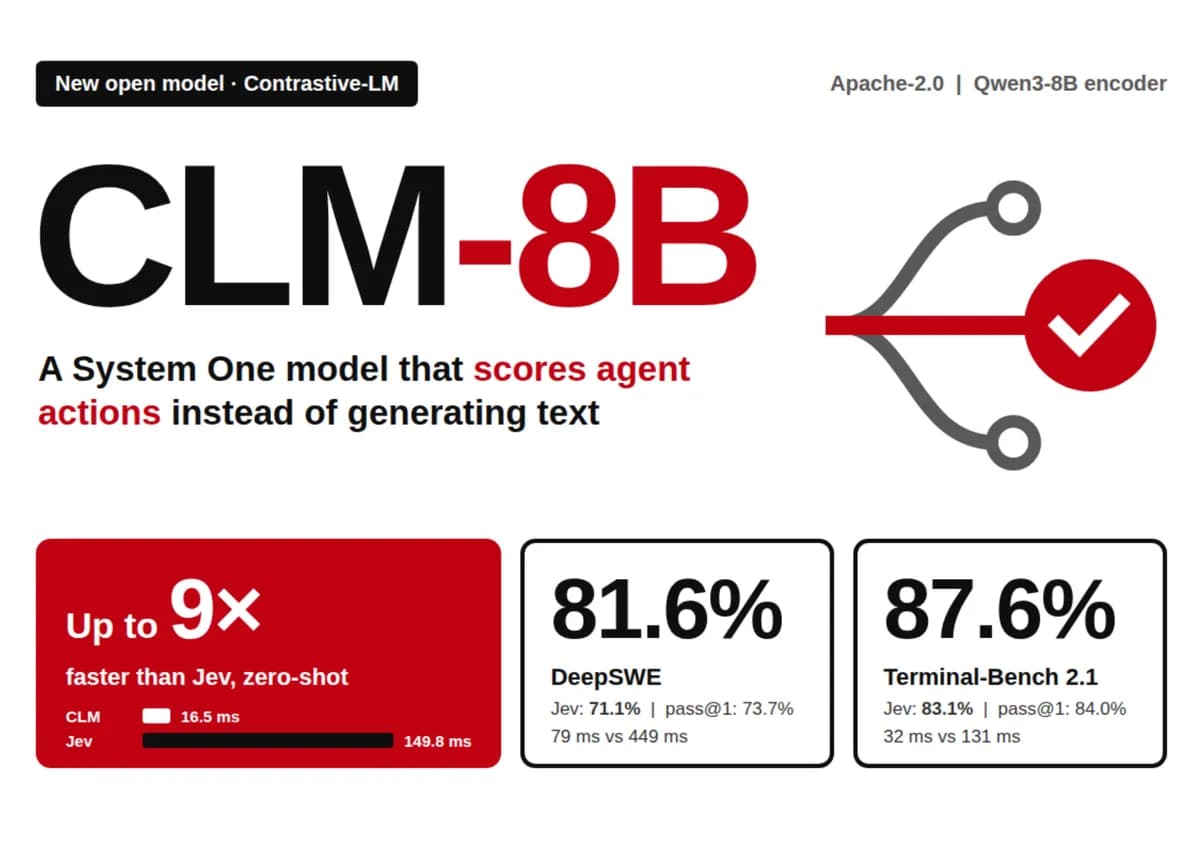
تصور کنید یک عامل هوش مصنوعی بهجای اینکه برای هر تصمیم ساده، یک پاراگراف دلیل بنویسد، در کسری از میلیثانیه بهترین گزینه را انتخاب کند. این جهش در سرعت، گلوگاه قدیمی تولید متن در حلقههای عاملمحور (Agentic Loops) را بهطور کامل از بین میبرد. در حالی که حلقههای سنتی معمولاً به دلیل تأخیر بالای تولید متن محدود میشوند، مدل CLM-8B محصول شرکت Contrastive-LM، با حذف کامل فرآیند سنتز متن و تمرکز بر امتیازدهی به اقدامات احتمالی، تا ۹ برابر سریعتر از رقبای اصلی خود عمل میکند. این مدل بهجای تولید کلمات، احتمال وقوع هر اقدام را محاسبه میکند و بدین ترتیب فرآیند تصمیمگیری را بهینه میسازد.
این تحول در حالی رخ میدهد که صنعت بهسمت مدلهای «سیستم یک» (System One) حرکت میکند؛ پردازشگرهای سریع و شهودی که تصمیمات روتین را بدون نیاز به استدلالهای زبانی پیچیده مدیریت میکنند. طبق گزارشهای منتشر شده، معیار اصلی این رویکرد مدل Jev از شرکت TypeSafe AI بود که در ۱۵ سپتامبر ۲۰۲۶ دسترسی محدود به آن آغاز شد. در حالی که Jev پیشگام خروجیهای غیرمتنی بود، CLM-8B اکنون یک جایگزین با وزنهای باز (Open Weights) تحت مجوز Apache-2.0 ارائه داده است. این رویکرد بهینهسازی مدلهای کوچک برای دستیابی به کارایی بالا، یادآور موفقیت مدل ZGCM-1 در برتری بر مدلهای بسیار بزرگتر است که نشان داد معماری هوشمندانه میتواند جایگزین حجم عظیم پارامترها شود.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی استنتاج در مدلهای کوچک اشاره کردیم، حذف لایههای غیرضروری تولید متن، کلید دستیابی به تأخیرهای زیر ۱۰ میلیثانیه است.
زمینه و یکپارچگی با API
به نقل از مستندات فنی این پروژه، CLM-8B دقیقاً همان رابط کاربری Jev را هدف قرار داده است و بهجای متن، مقادیر تایپشده همراه با احتمال (Probability) برمیگرداند. مخزن گیتهاب CLM، این مدل را پشت یک API سازگار با TypeSafe ارائه میدهد؛ این یعنی درخواستهایی که برای API شرکت TypeSafe نوشته شدهاند، میتوانند مستقیماً از طریق کلاینت پایتون CLM بازپخش و اجرا شوند.
این مدل سه نوع پرسش مشخص را پشتیبانی میکند:
- Noul: احتمال درست بودن یک گزاره را برمیگرداند.
- Choice: یک گزینه را از میان مجموعهای مشخص انتخاب کرده و احتمال هر یک را میسنجد.
- Score: بر اساس یک معیار رتبهبندی شده (Ordered Rubric)، سطح مورد انتظار را تعیین میکند.
از نظر معماری، CLM-8B از یک بدنه منجمد Qwen3-8B در کنار یک لایه تصویرساز (Projection Head) با ۲۰ میلیون پارامتر قابل آموزش استفاده میکند. این مدل برای آموزش رمزگذارهای حالت و اقدام، از تابع زیان bidirectional InfoNCE بهره میبرد که اجازه میدهد امتیازدهی از طریق یک ضرب داخلی ساده بین بردارهای معنایی (Embeddings) انجام شود. در نهایت، یک تابع softmax روی این امتیازها اعمال میشود تا توزیع نهایی پاسخها ایجاد گردد.
مشخصات فنی و عملکرد
جزئیات فنی و عملیاتی این مدل به شرح زیر است:
- معماری: رمزگذارهای حالت و اقدام بر پایه Qwen3-8B طراحی شدهاند. لایه Apache-2.0 (سر مدل) حجم ۷۵ مگابایت دارد.
- استقرار: مدل روی یک واحد پردازش گرافیکی (GPU) انویدیا در محیط لینوکس با استفاده از vLLM برای سرویسدهی به رمزگذار اجرا میشود. برای اجرای بهینه مدلهای باز در محیطهای مختلف، بهروزرسانیهای اخیر در نحوه اجرای مدلهای GGUF از طریق هستههای ggml مسیرهای جدیدی را برای استقرار سریعتر مدلها فراهم کرده است.
- کارایی: در کارت گرافیک RTX 4090 با ۳ اقدام تعریف شده، ابزار
clm-serveبخشی از حافظه GPU را رزرو میکند (مشابه KV cache در vLLM) تا از بردارهای ذخیرهشده مجدداً استفاده کند. این مکانیزم تأخیر برای حالتهای تکراری را از ۱.۷ میلیثانیه به ۰.۶ میلیثانیه کاهش داد. - توان عملیاتی: طبق کارت مدل (Model Card)، در زمان مدیریت حدود ۱۰۰۰ کاندیدا، CLM حدود ۱۳ برابر سریعتر از Jev عمل میکند.
دستورالعمل آموزشی سه مرحلهای
دستیابی به این عملکرد حاصل یک فرآیند آموزشی سختگیرانه در سه مرحله است:
۱. پیشآموزش (Pre-training): در این مرحله از حدود ۶۰ میلیون جفت پرسش و پاسخ Nemotron DQA استفاده شد که منجر به دستیابی به دقت ۵۲.۱٪ در Top-1 روی ۱۰۰ هزار پرسش آزمایشی (Held-out) گردید.
۲. میانآموزش (Mid-training): در این گام، حدود ۳۰ میلیون نمونه منفی سخت (Hard Negatives) که توسط Gemini 2.5 Flash-Lite تولید شده بودند، به مدل تزریق شدند و دقت را به ۶۹.۲٪ ارتقا دادند.
۳. پسآموزش (Post-training): در مرحله نهایی، از حدود یک میلیون مسیر حرکت عامل (Agent Trajectories) استخراج شده از Agent Data Protocol, Endless-Terminals و LiteCoder-Terminal-SFT استفاده شد.
تحقیقات نشان داد که اگر آموزش روی نمونههای منفی سخت از همان ابتدا آغاز شود، دقت در عدد ۶۲.۴٪ به اوج میرسد و سپس دچار بیشبرازش (Overfitting) میشود؛ همین موضوع توجیهکننده رویکرد مرحلهبندی شده بود.
به گزارش وبسایت marktechpost.com، مدل CLM-8B در وظایفی مانند بازی T-Rex و Super Mario با نرخ موفقیت Jev برابری میکند اما تأخیر بسیار کمتری دارد. در بازی T-Rex، تأخیر CLM-8B تنها ۱۶.۵ میلیثانیه بود، در حالی که Jev به ۱۴۹.۸ میلیثانیه زمان نیاز داشت. اگرچه این مدل در فراخوانی ابزارها (۹۵.۲٪ در مقابل ۹۹.۲٪ در BFCL v4) و در بنچمارک WikiRacing (۲۶ از ۳۰ در مقابل ۳۰ از ۳۰) کمی عقبتر از Jev است، اما در تمامی وظایف تست شده، سرعت بیشتری دارد.
بنچمارکهای تأییدکننده کدنویسی
زمانی که CLM-8B به عنوان یک تأییدکننده (Verifier) برای عاملهای کدنویسی استفاده میشود، یک مدل مولد (مانند Opus 5 برای DeepSWE یا Fable 5 برای Terminal-Bench 2.1) چندین کاندیدا را نمونهبرداری میکند و تأییدکننده بهترین آنها را انتخاب میکند. با استفاده از سرهای سبکوزن تنظیمشده روی H100، مدل CLM-8B نتایج پیشرو (SOTA) را در زیرمجموعههای آزمایشی ثبت کرد:
- DeepSWE (بهترین از ۴ مورد): به صحت ۸۱.۶٪ در Pass@1 رسید (در مقابل ۷۱.۱٪ برای Jev) و ۵.۷ برابر سریعتر عمل کرد (۷۹ میلیثانیه در مقابل ۴۴۹ میلیثانیه).
- Terminal-Bench 2.1 (بهترین از ۵ مورد): به صحت ۸۷.۶٪ در Pass@1 دست یافت (در مقابل ۸۳.۱٪ برای Jev) و ۴.۱ برابر سریعتر بود (۳۲ میلیثانیه در مقابل ۱۳۱ میلیثانیه).
نکته قابل توجه این است که Jev در هر دو بنچمارک، امتیازی پایینتر از Pass@1 کسب کرد؛ به این معنا که انتخاب بهترین گزینه با Jev، حتی از انتخاب یک نمونه تصادفی ساده نیز بدتر بود.
این معماری فرض قدیمی را که عاملها برای تصمیمگیری باید «بلند فکر کنند» (تولید متن استدلالی) تغییر میدهد. با جداسازی حالتها و اقدامات، CLM-8B اجازه میدهد بردارها برای مجموعههای ثابت بازاستفاده شوند و هزینه محاسباتی هر گام بهشدت کاهش یابد.
برای توسعهدهندگان، این به معنای امکان میزبانی یک تأییدکننده با کارایی بالا روی یک GPU واحد، بدون وابستگی به APIهای تجاری است. این روند نشان میدهد مدلهای زبانی بزرگ (LLM) در آینده لایه استدلال «کند» و مدلهای تضادی (CLM) لایه اجرای «سریع» را بر عهده خواهند داشت.
گام بعدی شما
- مخزن گیتهاب CLM را برای استقرار مدل پشت یک API سازگار با TypeSafe بررسی کنید.
- اگر از عاملهای کدنویسی استفاده میکنید، CLM-8B را بهعنوان لایه Verifier جایگزین مدلهای مولد کنید تا سرعت چرخه بازخورد افزایش یابد.
- معماری Contrastive Scoring را برای کاهش هزینههای استنتاج در پروژههای عاملمحور خود مطالعه کنید.
اما تأثیر این مدل بر کاهش مصرف انرژی در مراکز داده حتی چشمگیرتر است — به تحلیل ما درباره بهینهسازیهای سختافزاری vLLM مراجعه کنید.



گفتگو