امتیاز اطمینان تنها یک ادعاست، اما فهرستی از جایگزینهای ردشده یک سند است. Causely با پیادهسازی «توضیحات متضاد» برای تحلیل ریشهٔ خطا، استاندارد صنعتیِ اعتماد به «اطمینان» هوش مصنوعی را به چالش کشیده است تا مطمئن شود عاملها نهتنها راهکار میدهند، بلکه ثابت میکنند چرا احتمالات دیگر غلط بودهاند.
بسیاری از تیمهای پلتفرم هنگام استقرار عاملها در جریانهای کاری On-call با دوراهی «اقدام یا توصیه» (Act vs. Advise) دستوپنجه نرم میکنند. ریسک اینجاست که یک عامل ممکن است با اطمینان ۹۹٪ تشخیص غلطی بدهد و اقدامی برای رفع مشکل انجام دهد که در نهایت منجر به بدتر شدن قطعی سیستم (Production Outage) شود. این تنش در بحثهای اخیر جامعهٔ r/kubernetes به نقطه جوش رسید؛ جایی که مهندسان استدلال میکردند حق وتوی ایمنی باید بر اساس استدلال و منطق عامل باشد، نه بر اساس میزان اطمینانی که عامل بهطور خودکار گزارش میکند.
دوراهی اقدام یا توصیه
در رشتهبحثهای r/kubernetes، یک معماری پیشنهادی ارائه شد که در آن یک عامل رفع خطا به دو بخش مجزا تقسیم میشد. در مرحله اول، یک مدل زبانی بزرگ (LLM) اقداماتی نظیر مقیاسدهی (Scaling)، بازگشت به نسخه قبلی (Rollback)، ایزولهسازی گره (Cordoning) یا تخلیه منابع (Draining) را پیشنهاد میدهد. در مرحله دوم، یک لایه قطعی (Deterministic) و مجزا، هر اقدامی را که با توجه به وضعیت زندهٔ خوشه (Cluster State) ناایمن باشد، پیش از اجرا وتو میکند. این طراحی بر این فرض استوار است که «پیشنهاد یک اقدام» و «تصمیم برای اجرای آن»، دو تابع کاملاً متفاوت هستند.
با این حال، جامعهٔ مهندسان به یک شکاف بحرانی اشاره کردند: اطمینان از علت ریشهای و ایمنیِ اقدام برای رفع آن، اغلب با هم خلط میشوند. وتویی که صرفاً به گزارش خودِ عامل اعتماد کند، در واقع فقط یک «نظر دوم» است و یک بررسی (Check) واقعی محسوب نمیشود. برای حل این مشکل، مهندسان پیشنهاد کردند که عامل مجبور شود پیش از تحویل اقدام پیشنهادی، توضیح دهد که چرا یک تشخیص خاص را انتخاب کرده است. این رویکرد به انسان یا موتور سیاستگذاری (Policy Engine) چیزی ملموس برای بازبینی میدهد، بهجای اینکه صرفاً یک توصیه دوگانه برای پذیرش یا رد دریافت کنند.
نیاز به حافظه و وضعیت (State)
مشارکتهای بیشتر در این بحث تأکید داشت که یک لایه وتوی قدرتمند به حافظه نیاز دارد. این حافظه باید شامل پیادهسازی بودجههای محدودهٔ اثر (Blast-radius budgets) برای هر Namespace و تعریف دورههای استراحت (Cooldown periods) باشد. نکته حیاتی این است که سیستم باید قانونی داشته باشد که اگر اثر مورد انتظار از یک اقدام ظاهر نشد، عملیات را متوقف کرده و یک انسان را فراخوان (Page) کند. لایه وتو باید وضعیت واقعی خوشه را بهطور مستقل بررسی کند، نه اینکه به گزارش عامل از آن وضعیت اعتماد نماید.
Causely برای پر کردن این شکاف و ایجاد هوش مصنوعی قابل تأیید، مجموعهای از ابزارهای پروتکل زمینهٔ مدل (MCP) را منتشر کرد. این ابزارها از پرسش سادهٔ «چرا این اتفاق افتاد؟» فراتر رفته و به پرسش سختگیرانهتر «چرا این اتفاق افتاد و نه آن اتفاق؟» پاسخ میدهند.
سازوکار استدلال متضاد
توضیحات متضاد (Contrastive Explanation) بر اساس پژوهشهای هوش مصنوعی تفسیرپذیر (Explainable AI) است. این پژوهشها نشان میدهند که انسانها تنها زمانی یک توضیح را قانعکننده مییابند که آن توضیح با یک جایگزین که رخ نداده است مقایسه شود، حتی اگر آن جایگزین هرگز بهطور صریح بیان نشود. در یک فرمولبندی رسمی در سال ۲۰۲۵، این مسئله مستقیماً به عنوان یک وظیفه «چرا P و نه Q» تعریف شده است؛ به این معنا که محاسبهٔ تفاوت بین این دو حالت، خودِ وظیفهٔ اصلی توضیح دادن است، نه اینکه توضیح را به عنوان یک فکر جانبی در انتهای فرآیند اضافه کنند.
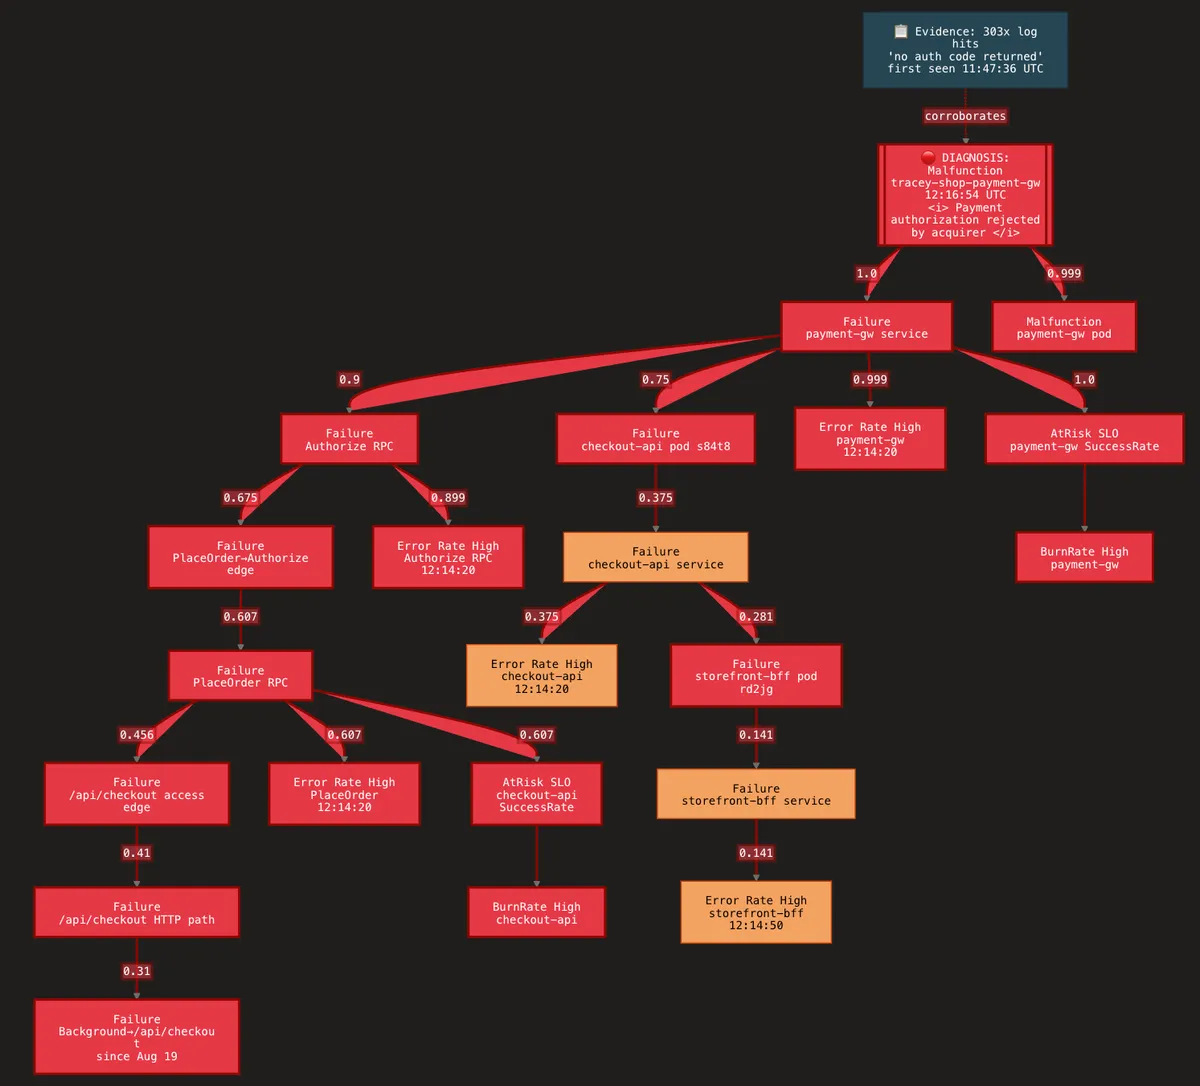
Causely این رویکرد را با نمایش مستقیم استدلال مدل علی (Causal Model) به عاملها عملی میکند. این قابلیت به بازبین اجازه میدهد ببیند کدام تشخیصهای جایگزین برای یک علامت بررسی شدهاند، چه شواهدی آنها را رد کرده است و اگر خطا برطرف نمیشد، شکست تا کجا گسترش مییافت.
برای اجرای این سازوکار، پلتفرم دو ابزار اصلی ارائه میدهد:
- get_potential_diagnoses: این ابزار تمام توضیحات ممکن برای یک علامت را فاش میکند (نه فقط گزینه برتر انتخاب شده توسط مدل علی) و زنجیره علی هر کدام را ترسیم میکند.
- get_signal_potential_diagnoses: این ابزار بهصورت معکوس عمل میکند؛ با داشتن یک سیگنال مشاهدهشده، تمام علتهای احتمالی و زنجیرههای علی که هر کاندید را به آن سیگنال متصل میکند، شناسایی میکند.
اجتناب از حلقه «اصلاحات کاذب»
یک حادثه رایج را در نظر بگیرید: یک سرویس پرداخت (Checkout) با تأخیر بالا و Time-out مواجه میشود. این سرویس چندین لایه پاییندستتر از یک استخر اتصالات پایگاهداده (Database Connection Pool) مشترک قرار دارد. یک عامل معمولی که فقط بر پایه LLM است، این مسیر را تنها از روی علامت دنبال میکند. عامل تلهمتری را بررسی کرده، از سرویس پرداخت به عقب بازمیگردد و در مسیر خود، یک جهش CPU (CPU Spike) را در یک سرویس مجاور پیدا میکند.
عامل، این جهش CPU را به عنوان علت تشخیص داده و آن سرویس را ریاستارت میکند. چون ریاستارت موقتاً جهش CPU را از بین میبرد، داشبورد بهبود مییابد و عامل حادثه را «حل شده» تلقی میکند. اما علت واقعی — یعنی اتمام ظرفیت اتصالات در استخر اتصالات پایگاهداده در لایههای بالاتر — هیچ سیگنال مستقیمی در لایه فعلی عامل ایجاد نمیکند و بنابراین هرگز دیده نمیشود.
این ریاستارت فقط زمان خرید، اما مشکل زیربنایی را حل نکرد. حادثه بهناچار زمانی که محدودیت اتصالات دوباره پر شود، بازمیگردد و عامل دوباره همین حلقه از اصلاحات سطحی را تکرار میکند.
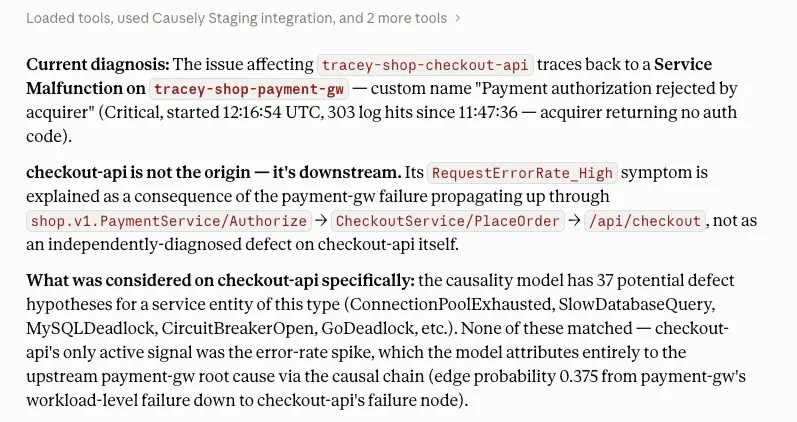
با استفاده از ابزارهای متضاد Causely، بازبین داستان متفاوتی را میبیند. فراخوانی get_signal_potential_diagnoses روی علامت اولیه، تشخیص «اتمام ظرفیت اتصالات» را در کنار جایگزین «جهش CPU» نمایش میدهد. هر کدام با یک زنجیره علی ارائه میشوند که نشان میدهد چه چیزی را توضیح میدهند و چه چیزی را نادیده میگیرند. در این مورد، جهش CPU الگوی Time-out در پاییندست را توضیح نمیدهد، اما اتمام ظرفیت اتصالات این کار را میکند. این مقایسه باعث میشود تشخیص پیش از آنکه عامل اقدام به رفع خطا کند، قابل بازبینی باشد.
مدیریت محدوده اثر (Blast Radius)
تأیید فقط دربارهٔ «چرا» نیست، بلکه دربارهٔ «تا کجا» است. تشخیصی با محدوده اثر کوچک و شناختهشده با تشخیصی با محدوده اثر بزرگ و نامعلوم، دو تصمیم ریسک متفاوت هستند، حتی اگر مدل برای هر دو یک میزان اطمینان یکسان داشته باشد.
Causely این موضوع را با دو ابزار تکمیلی حل میکند:
- rank_entities: این ابزار موجودات سیستم را بر اساس میزان مواجهه با وابستگیها رتبهبندی میکند تا مشخص شود شکست چه بخشهایی را تحت تأثیر قرار میدهد.
- get_diagnosis_observable_signals: این ابزار پیشبینی میکند که اگر تشخیص درست باشد، چه سیگنالهایی باید در پاییندست انتظار داشت، پیش از آنکه هر اقدامی صورت گیرد.
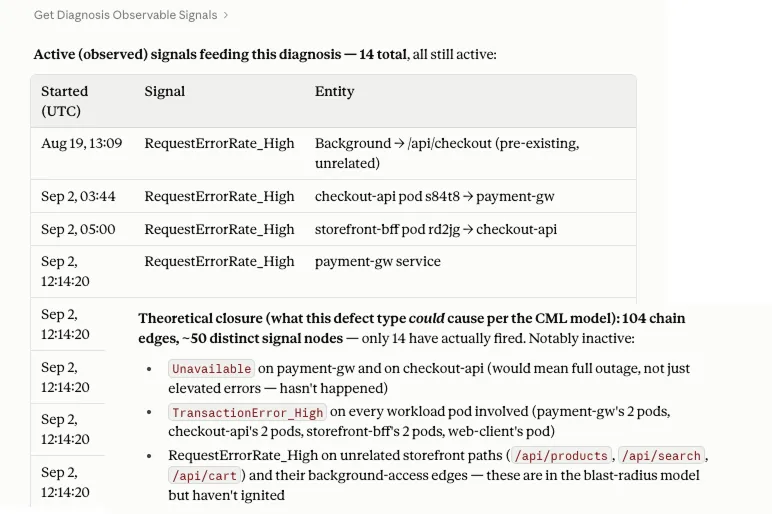
این ابزارها دادههای عینی لازم برای آن وتوی ایمنی قطعی را فراهم میکنند که در بحث کوبرنتیز مطرح شد. بودجهٔ محدوده اثر تنها زمانی مفید است که سیستم بتواند ابتدا آن محدوده را محاسبه کند. با رتبهبندی موجودات بر اساس مواجهه با وابستگیها، یک موتور سیاستگذاری یا مهندس On-call بهجای حدس زدن، یک عدد واقعی برای تعیین بودجه در اختیار دارد.
تغییر در مشاهدهپذیری هوش مصنوعی
این رویکرد فرض بنیادی عاملهای هوش مصنوعی در محیط عملیاتی را تغییر میدهد. عامل از یک «جعبه سیاه» که درخواست اعتماد میکند، به یک «سامانه شفاف» تبدیل میشود که کارهایش را برای بازبینی میفرستد. مدلی که فقط جواب برتر را گزارش میکند، در واقع میخواهد به او اعتماد کنید؛ اما مدلی که نشان میدهد چه چیزهای دیگری را بررسی کرده و چرا هر کدام رد شدهاند، اجازه بازبینی میدهد. ادعای دوم بسیار قویتر است.
برای مهندس On-call، هوش مصنوعی دیگر جایگزین قضاوت نیست، بلکه یک پژوهشگر با سرعت بالا است که فهرستی سازمانیافته از شواهد و شواهد متضاد را ارائه میدهد. انسان همچنان تصمیمگیرنده نهایی است، اما حالا بهجای یک توصیه تکجملهای، یک نقشه علی را بازبینی میکند.
مسیرهای آینده: شبیهسازی پیشرو
ابزارهای امروز به پرسشهای «چرا این و نه آن» و «تا کجا گسترش مییابد» بر اساس وضعیت فعلی مدل علی پاسخ میدهند. تکامل بعدی، حرکت از تحلیل واکنشی به تحلیل پیشدستانه از طریق «شبیهسازی پیشرو» (Forward Simulation) است.
این قابلیت به تیمها اجازه میدهد بپرسند «اگر این جزء تضعیف شود، چه چیزی میشکند؟» پیش از آنکه هر علامتی در واقعیت ظاهر شود. این امر مستلزم تغییر در مدلسازی است: حالتهای شکست (Failure Modes) باید به عنوان موجوداتی درجهیک با پیشنیازها و محدوده اثر مخصوص به خود مدل شوند، نه اینکه فقط از روی ناهنجاریهای مشاهدهشده به عقب استدلال شود. این یک گسترش طبیعی از همان مدل علی است — یعنی پرسیدن همان سؤالات در مراحل زودتر از چرخه حیات سیستم برای حذف احتمالی حوادث پیش از آنکه هشدار (Alert) فعال کنند.
برای شروع پیادهسازی این رویکرد، تیمها میتوانند سرور MCP شرکت Causely را به لایههای ارکستراسیون LLM خود متصل کنند تا ممیزی استدلال عاملها را بهصورت زنده آغاز نمایند.
گام بعدی شما
- اگر از عاملهای هوش مصنوعی برای مدیریت زیرساخت استفاده میکنید، خروجیهای آنها را از حالت «تأیید/رد» به حالت «توضیح متضاد» تغییر دهید.
- سرور MCP شرکت Causely را به لایههای ارکستراسیون LLM خود متصل کنید تا استدلال عاملها را بهصورت زنده ممیزی کنید.
- برای هر اقدام حساس، یک «بودجه محدوده اثر» تعریف کنید و آن را با دادههای واقعی وابستگیها بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو