تصور کنید هر بار که با دستیار هوشمند خود صحبت میکنید، او تمام خاطراتش را پاک میکند و تبدیل به غریبهای میشود که حتی نمیداند ترجیحات شما چیست. این دستیار جدید هیچ دفترچه یادداشتی ندارد و هیچ خاطرهای از ترجیحات قبلی شما در ذهن ندارد. این «فراموشی مطلق» واقعیت تلخ اکثر عاملهای بدون سرور (Serverless) است که پس از هر اجرا، کانتینر آنها نابود میشود. در واقع، این عاملها راهی بادوام برای به یاد آوردن این نکته ندارند که شما مثلاً استقرارها را صبحهای سهشنبه ترجیح میدهید، مگر اینکه این دادهها صراحتاً در هر درخواست تزریق شوند.
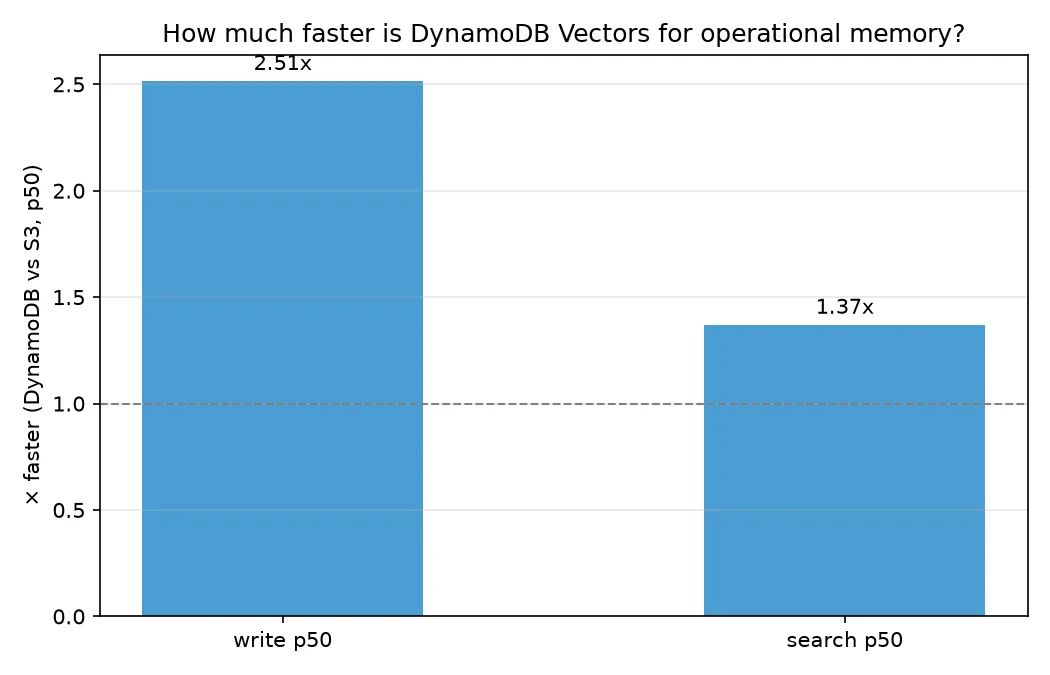
به نقل از راهنمای فنی منتشر شده در ۲۴ سپتامبر ۲۰۲۶، استفاده از جستوجوی برداری بومی در Amazon DynamoDB این مشکل را حل کرده است. این رویکرد اجازه میدهد عاملها حافظه معنایی خود را با سرعتی ۲.۵ برابر بیشتر از جایگزینهای مبتنی بر S3 ذخیره و بازیابی کنند.
این نقص حافظه در اجرای واقعی فایل demo.py کاملاً مشهود است. وقتی در جلسه دوم از عامل درباره نام خوشه تولید (Production Cluster) و منطقه (Region) آن سؤال میشود، عامل شکست میخورد. او ابزاری به نام retrieve_context را فراخوانی میکند، اما چون هیچ خاطرهای از گفتگوی قبلی ندارد، صرفاً از کاربر میخواهد اطلاعات را تکرار کند. لاگهای واقعی سیستم نشان میدهد: [session 2] user: What's my production cluster called and its region? Tool #1: retrieve_context Could you please provide the reference or context key that holds the production cluster details?. این یک آزمایش ذهنی نیست؛ بلکه رفتار پیشفرض عاملها در Lambda است، جایی که کانتینر بین فراخوانیها تخریب میشود.
برای حل این مشکل، توسعهدهندگان باید بین سه لایه متمایز از حافظه تمایز قائل شوند. مخلوط کردن این سه لایه، باگ اصلی است که باعث میشود عاملها چیزهای اشتباه را به یاد بیاورند یا زمینههای حیاتی را فراموش کنند.
سه لایه حافظه
- وضعیت (State): جفتهای کلید-مقدار موقت که توسط اپلیکیشن و ابزارها بین درخواستها استفاده میشوند. این دادهها به طور خودکار به مدل ارسال نمیشوند؛ توسعهدهنده باید در صورت نیاز آنها را تزریق کند. این لایه را مانند یک یادداشت چسبان روی میز کار تصور کنید.
- نشست (Session): تاریخچه یک گفتگوی خاص تا زمانی که آن شناسه (ID) دیگر بازیابی نشود. این همان زمینهای است که به مدل ارائه میشود. این لایه را مانند دفترچه یادداشت مربوط به جلسه امروز تصور کنید.
- حافظه بلندمدت (Long-term Memory): دادههای بادوامی که بر اساس معنا در طول اجراهای غیرمرتبط بازیابی میشوند و برای همیشه باقی میمانند. این دادهها پیش از هر نوبت گفتگو تزریق میشوند. این لایه را مانند دستیاری تصور کنید که ترجیحات شما را هفتهها بعد، حتی اگر با کلمات متفاوتی بیان شود، به یاد میآورد.
در ابزار Strands Harness (از طریق create_harness)، این لایهها از طریق دو سوئیچ متعامد مدیریت میشوند:
create_harness(session={"id": "..."}): برای بازگشت به یک گفتگوی خاص استفاده میشود.create_harness(memory={"stores": [store]}): برای انتقال دادهها در تمام اجراها به کار میرود.
در حالی که نشستها پس از تخریب Lambda زنده میمانند، حافظه بلندمدت از همه چیز، حتی گفتگوهایی که هیچ کلمه مشترکی ندارند، جان سالم به در میبرد.
معماری حافظه برداری بومی
نوآوری اصلی این است که بردار معنایی (Embedding) — که مثل یک کارت معرفی عددی برای هر واژه است و میگوید این کلمه همسایه چه کلمات دیگری است — مستقیماً در کنار آیتم داده در یک جدول واحد DynamoDB قرار میگیرد. این کار نیاز به پایگاهدادههای برداری مجزا مثل Pinecone یا OpenSearch و همچنین خط لولههای پیچیده همگامسازی که معمولاً برای هماهنگ نگه داشتن آنها لازم است را از بین میبرد.
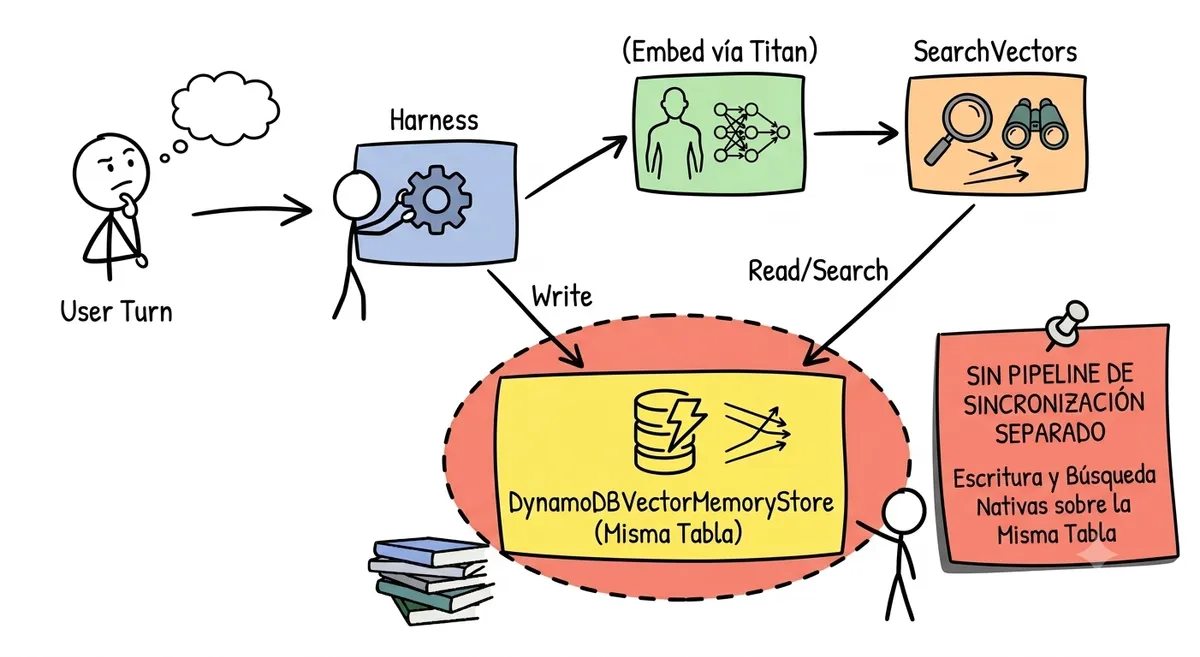
در یک ساختار سنتی تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — دادهها باید از دیتابیس از طریق استریمها و لایمدا به یک ایندکس خارجی منتقل شوند. این مسیر باعث ایجاد تأخیر در سازگاری دادهها (Consistency Latency) میشود. اما با بردارهای بومی DynamoDB، یک فراخوانی واحد PutItem هم محتوا و هم بردار را مینویسد و کل فرآیند را به چند میلیثانیه میرساند.
مقایسه: RAG سنتی در برابر بردارهای DynamoDB
- پایگاهداده برداری مجزا: نیاز به DynamoDB + Streams + Lambda worker + OpenSearch/Pinecone دارد. این مدل بر یک خط لوله همگامسازی متکی است که منجر به تأخیر در سازگاری نهایی میشود.
- بردارهای DynamoDB: فقط از DynamoDB (آیتم + بردار) استفاده میکند. هیچ خط لولهای وجود ندارد و تأخیر خواندن/نوشتن در محدوده تکرقمی میلیثانیه در داخل منطقه (Region) اندازهگیری میشود.
مراحل پیادهسازی فنی
پیادهسازی این سیستم نیازمند تنظیمات خاصی برای جدول DynamoDB است. ایندکس برداری باید حتماً هنگام ایجاد جدول تعریف شود تا از بازسازیهای (Backfills) پرهزینه جلوگیری شود. اگر این ایندکس به جدولی اضافه شود که از قبل حاوی آیتم است، فرآیند بازسازی باعث صرف زمان و هزینه میشود.
الزامات کلیدی برای فراخوانی create_table در فایل setup_table.py عبارتند از:
- حالت پرداخت (Billing Mode): باید روی
PAY_PER_REQUEST(بر اساس درخواست) تنظیم شود، زیرا این حالت برای ایندکسهای برداری اجباری است. - ابعاد (Dimensions): باید دقیقاً با خروجی مدل برداری مطابقت داشته باشد. برای مدل Amazon Bedrock Titan V2، این عدد باید ۱۰۲۴ باشد. اگر این مقدار مطابقت نداشته باشد، جستوجو بدون هیچ خطایی نتایج بیفایدهای برمیگرداند.
- تابع فاصله (Distance Function): باید با روش تولید بردار مطابقت داشته باشد که معمولاً برای بردارهای با طول واحد،
COSINEاست. - طرح جستوجو (Search Schema): باید ویژگی (مثلاً
pk) را که قرار است بازگردانده شود، تعریف کند. - پروجکشن (Projection): روی
ALLتنظیم شود تا اطمینان حاصل شود تمام ویژگیها در طول جستوجو بازیابی میشوند.
برای تأیید آمادگی جدول، اجرای python setup_table.py یک توالی از بررسیها را فعال میکند. این نیست که گزارش ACTIVE در DescribeTable کافی باشد؛ زیرا نقطه انتهایی (Endpoint) جستوجو ممکن است تأخیر داشته باشد. اسکریپت با اجرای حلقهای از فراخوانیهای واقعی SearchVectors وضعیت را بررسی (Polling) میکند. تنها زمانی که عبارت searchable on attempt N چاپ شود، ایندکس واقعاً آماده پاسخ به پرسوجوهاست.
تولید بردارها با Bedrock
سیستم برای تولید بردارها، Amazon Bedrock را با استفاده از مدل Titan V2 (amazon.titan-embed-text-v2:0) فراخوانی میکند. تابع کمکی در embeddings.py از normalize=True استفاده میکند تا بردارهایی با طول واحد تولید کند، که همان چیزی است که جستوجوی COSINE انتظار دارد.
از آنجا که کد مستقیماً Bedrock را فراخوانی میکند، هر عملیات نوشتن و جستوجوی معنایی دو رویداد هزینهبر ایجاد میکند: یکی برای تولید بردار (Embedding) و دیگری برای عملیات DynamoDB. در نتیجه، نقش IAM علاوه بر دسترسی به DynamoDB، به مجوزهای bedrock:InvokeModel نیز نیاز دارد.
یکپارچهسازی با Strands Harness
این پیادهسازی از Strands Harness استفاده میکند که تابع create_harness را برای مدیریت حافظه فراهم میکند. سیستم پروتکل strands.memory.MemoryStore را پیاده میکند، بهویژه متدهای add() و search() که در ddb_memory_store.py یافت میشوند.
- متد
add(): بردار محتوا را تولید کرده و آن را به عنوان یک بردار قابل جستوجو در DynamoDB با کلیدی مانندmemories/{uuid.uuid4().hex[:8]}ذخیره میکند. این متد محتوا، بردار و متادیتا را در یک عملیات واحد مینویسد. - متد
search(): بردار پرسوجو را تولید کرده و ازSearchVectorsبرای یافتن مشابهترین خاطرات استفاده میکند. این متد ازpk(کلید پارتیشن) برای محدود کردن جستوجو به یک مستاجر (Tenant) واحد استفاده میکند.
نمایش بازیابی معنایی
برخلاف جستوجوهای کلیدواژهای که کلمات دقیق را مطابقت میدهند، این سیستم با «معنا» مطابقت میدهد. در demo.py یک حقیقت ذخیره شده است: «کاربر ترجیح میدهد استقرارها صبحهای سهشنبه باشد». پس از یک وقفه کوتاه برای اجازه دادن به سازگاری نهایی (Eventual Consistency)، پرسشی مطرح میشود: «کاربر چه زمانی دوست دارد ریلیزها را ارسال کند؟»
با وجود اینکه «ارسال ریلیز» (ship releases) و «استقرار» (deployments) کلمات متفاوتی هستند و در پرسوجو هیچ اشارهای به «سهشنبه» نشده است، اما بردارهای معنایی آنها از نظر ریاضی مشابهاند. نتیجه، حقیقت درست را با امتیاز کسینوسی ۰.۶۶۶۵ بازمیگرداند.
برای عملیاتی کردن این سیستم، DynamoDBVectorMemoryStore به عنوان بکاند حافظه به Harness متصل میشود:
agent = create_harness(
model=MODEL,
session=False,
memory={"stores": [store]},
# Harness عملیات تزریق و ابزار search_memory را مدیریت میکند
)
وقتی کاربر میپرسد «برای ریلیز هفته آینده برنامهریزی میکنم، آیا ترجیح زمانی خاصی برای من ثبت شده است؟»، Harness ابزار search_memory را فراخوانی کرده، ترجیح را از DynamoDB بازیابی میکند و پیش از پاسخ مدل، آن را به زمینه (Context) تزریق میکند.
بنچمارکهای عملکرد و هزینه
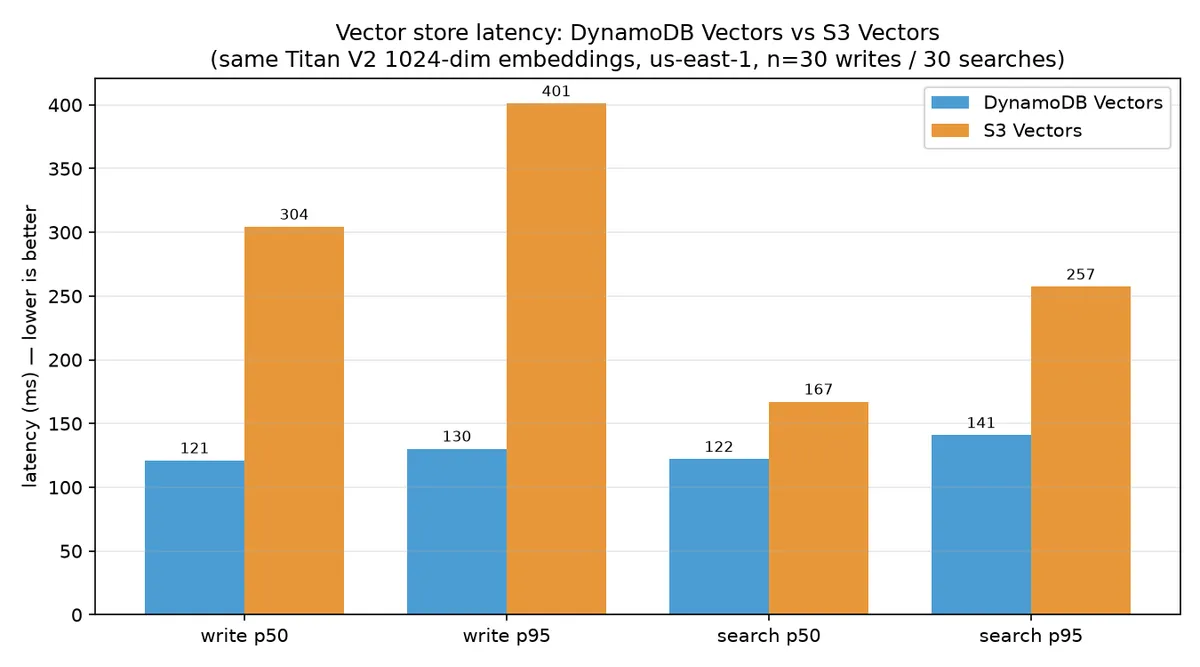
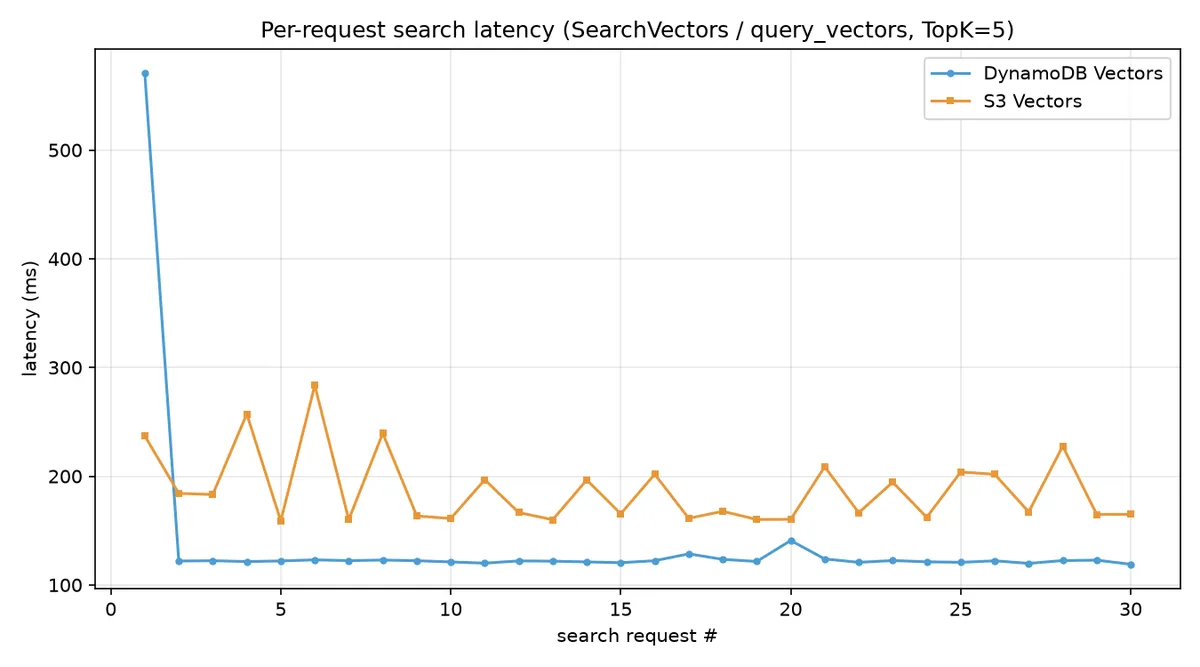
تستهای رودررو در منطقه us-east-1 (انجام شده در سپتامبر ۲۰۲۶) برتری واضح بردارهای بومی DynamoDB را نسبت به S3 Vectors برای حافظه «مسیر داغ» (Hot Path) عاملها نشان میدهد. این تستها شامل نوشتن ۳۰ بردار Titan V2 و انجام ۳۰ جستوجو (TopK=5) از خارج از AWS بود تا تأخیر رفت و برگشت کلاینت به منطقه نیز لحاظ شود.
نتایج تأخیر p50 به شرح زیر است:
- نوشتن: بردارهای DynamoDB (۱۲۱.۰۵ میلیثانیه) در برابر بردارهای S3 (۳۰۴.۳۶ میلیثانیه).
- جستوجو: بردارهای DynamoDB (۱۲۲.۰۹ میلیثانیه) در برابر بردارهای S3 (۱۶۷.۱۵ میلیثانیه).
تحلیل هزینه
از منظر هزینه، ذخیرهسازی برای حافظه عاملها ناچیز است، زیرا ۲۵ گیگابایت اول در ماه رایگان است و پس از آن هزینه حدود ۰.۲۵ دلار به ازای هر گیگابایت در ماه است. هزینه عملیاتی تقریباً ۰.۰۰۰۴ دلار به ازای ۱۰۰ حافظه و ۳۰ جستوجو (با حداقل ۱ کیلوبایت برای هر جستوجو) برآورد میشود.
تلههای بحرانی پیادهسازی
یک تله بزرگ برای توسعهدهندگان، ماهیت ناهمگام (Asynchronous) متدهای add() و search() است. در نسخههای اولیه کتابخانه strands-dynamodb-storage (v0.1.x)، حذف کلمه کلیدی await در یک عملیات نوشتن باعث ایجاد خطا نمیشود. در عوض، یک coroutine برمیگرداند و در سکوت شکست میخورد، بدون اینکه هیچ استثنا (Exception) یا لاگی ثبت شود و جدول خالی میماند.
اگر جستوجوی معنایی هیچ نتیجهای برنمیگرداند و خطایی وجود ندارد، توسعهدهندگان باید بررسی کنند که آیا تمام دستورات await self._storage.write(...) و await store.add(...) به درستی await شدهاند یا خیر. یک await گمشده، یک عملیات بیاثر (no-op) خاموش است، نه یک کرش.
چه زمانی از بردارهای بومی استفاده کنیم؟
این رویکرد جایگزین جهانی برای تمام ذخیرهسازهای برداری نیست. انتخاب بستگی به ماهیت بردارها دارد:
- استفاده از DynamoDB Vectors برای دادههای عملیاتی: این شامل حافظه عامل، ترجیحات کاربر، توصیههای محصول و سیگنالهای تقلب است. اینها نقاط دادهای هستند که مکرراً تغییر میکنند و در مسیر داغ خوانده میشوند. این روش یک بار نوشتن و صفر خط لوله همگامسازی ارائه میدهد.
- استفاده از S3 Vectors برای پایگاههای دانش: این شامل PDFها، ویکیها و مجموعههای بزرگ RAG است. این دادهها معمولاً یک بار بردار شده و بارها پرسوجو میشوند. S3 برای این الگو بهینه شده و برای دادههای غیرفعال و حجیم، حدود ۹۰٪ ارزانتر است.
پاکسازی و نگهداری
برای پاکسازی، از آنجا که PAY_PER_REQUEST هیچ هزینه ظرفیت بیکاری ندارد، تنها هزینه جاری مربوط به ذخیرهسازی است. اجرای python cleanup.py جدول DynamoDB (و ایندکس آن)، باکت S3، ایندکس S3 Vectors و فایلهای نشست محلی در ./.agent را حذف میکند.
پرسشهای متداول و الزامات فنی
آیا به دیتابیس برداری مجزا نیاز دارم؟ خیر. برای حافظه عملیاتی، DynamoDB بردار را در کنار آیتم نگه میدارد و نیاز به سرویس دوم را از بین میبرد.
آیا کلید پارتیشن یک مرز امنیتی است؟ خیر. در حالی که pk جستوجو را شتاب میبخشد و محدود میکند، هر کسی با مجوزهای dynamodb:SearchVectors میتواند هر پارتیشنی را جستوجو کند. جداسازی واقعی مستاجران باید از طریق IAM یا جداول مجزا مدیریت شود.
چه نسخهای از SDK لازم است؟ شما به boto3/botocore نسخه ۱.۴۳.۶۴ یا بالاتر نیاز دارید. قابلیت SearchVectors در تاریخ ۴ اوت ۲۰۲۶ به AWS SDK اضافه شد؛ نسخههای قدیمیتر client.search_vectors را ارائه نمیدهند.
این تغییر در معماری به این معناست که عاملهای هوش مصنوعی دیگر مجبور نیستند «هر صبح جایگزین شوند». آنها میتوانند درکی پایدار و تکاملی از کاربر داشته باشند که در جلسات مختلف و با بیانهای متفاوت باقی میماند، بدون اینکه سربار زیرساختی دیتابیس دوم را تحمل کنند.



گفتگو