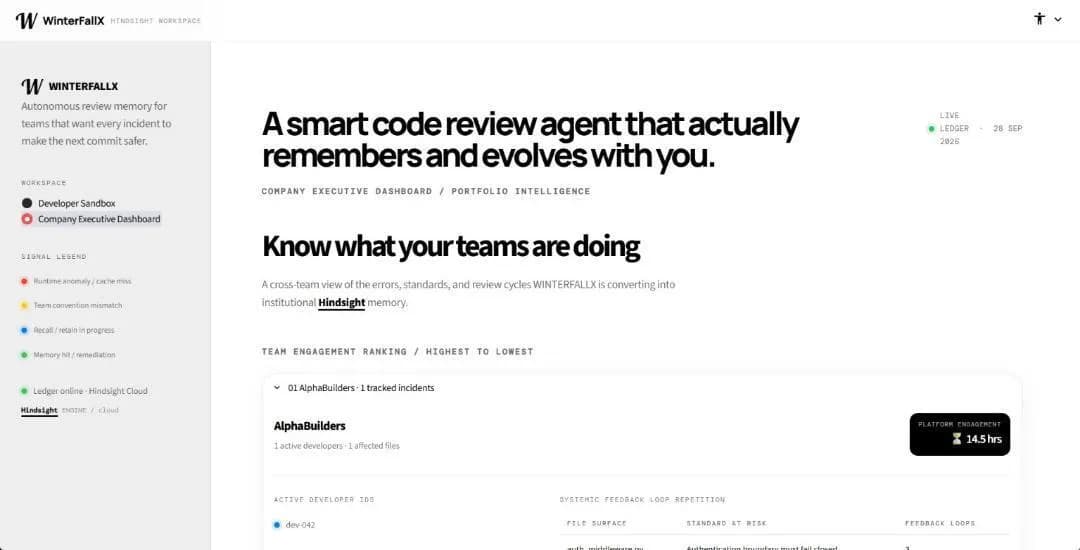
تصور کنید یک توسعهدهنده یک درخواست تغییر کد (Pull Request) را باز میکند، اما تنها برای این است که همان هشدار Timeout را دریافت کند که ماه گذشته اصلاح کرده بود. این چرخهٔ خستهکننده از بازخوردهای تکراری به این دلیل رخ میدهد که اکثر بازبینهای هوش مصنوعی «بدون وضعیت» (Stateless) هستند؛ به این معنا که به محض پایان هر جلسه، تمام درسهای آموختهشده را فراموش میکنند. این چالش در واقع پاسخی به بحرانی است که در آن تولید سریعتر کد توسط عاملهای هوش مصنوعی، گلوگاههای بازبینی را عمیقتر کرده بود. طبق یک راهنمای فنی که در ۲۸ سپتامبر ۲۰۲۶ منتشر شد، موتور حافظهای به نام Hindsight طراحی شده تا به عاملها (Agents) — شبیه دستیاران هوشمندی که میتوانند بهطور مستقل ابزارها را مدیریت کنند — تداوم و حافظه بلندمدت ببخشد.
یک توسعهدهنده تازهکار را تصور کنید که مدام یک قرارداد خاص تیمی (Team Convention) را فراموش میکند. در حالت عادی، یک مهندس ارشد باید ساعتها وقت صرف تکرار همان اصلاحیه کند. اما با پیادهسازی یک عامل آگاه به حافظه، آن اصلاحیه یک بار ذخیره شده و بهطور خودکار روی تمام درخواستهای PR آینده در سراسر کل تیم اعمال میگردد.
معماری سیستم
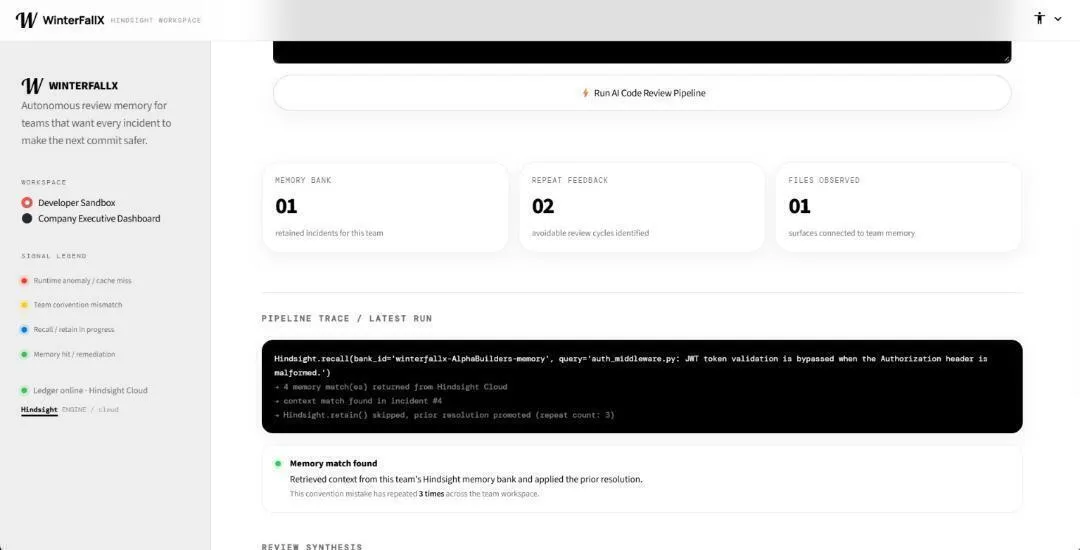
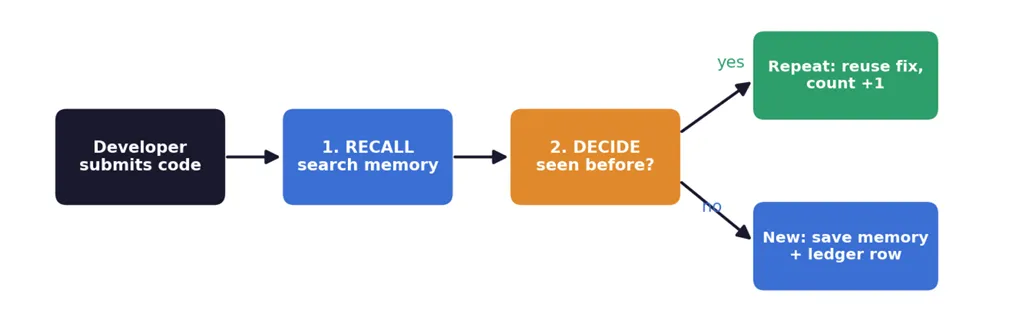
این سیستم بر اساس یک خط لوله سه مرحلهای شامل «بازیابی» (Recall)، «تصمیمگیری» (Decide) و «ذخیره» (Save) عمل میکند. سیستم ابتدا مسائل شناختهشده مربوط به یک فایل خاص را جستوجو میکند، سپس تصمیم میگیرد که آیا خطای فعلی یک مورد تکراری است یا خیر، و در نهایت یا از یک راهکار قبلی استفاده میکند یا یک مورد جدید را ذخیره مینماید.
برای اجرای این فرآیند، معماری سیستم بهجای یک پایگاهداده واحد، از دو لایه ذخیرهسازی مجزا استفاده میکند. استفاده از یک جدول ساده بیش از حد سختگیرانه است زیرا تنها تطبیقهای دقیق (Exact Match) را شناسایی میکند؛ در حالی که ممکن است دو توسعهدهنده یک باگ مشابه را با کلمات متفاوتی توصیف کنند و یک جدول استاندارد آنها را به عنوان دو مورد بیربط در نظر بگیرد.
مکانیزم ذخیرهسازی دوگانه
بر اساس مستندات این سیستم، مدیریت حافظه به دو بخش تقسیم شده است:
- حافظه معنایی (Semantic Memory): عامل با استفاده از Hindsight، جستوجوهای منعطف و مبتنی بر معنا (Fuzzy Lookups) را از طریق فراخوانیهای
retainوrecallانجام میدهد. این لایه — مثل یک مترجم که مفهوم حرف شما را میفهمد حتی اگر کلمات را اشتباه بگویید — تضمین میکند که معنای خطا حتی در صورت تفاوت در عبارتبندی شناسایی شود. این رویکرد مشابه پیادهسازی لایه حافظه Funes است که هزینه انتقال عاملهای کدنویس را بهشدت کاهش داد. - دفتر کل دقیق (Exact Ledger): یک پایگاهداده محلی SQLite اعداد و ارقام سخت را مدیریت میکند. این بخش از یک اثر انگشت SHA-256 — که ترکیبی از تیم، فایل، کد و رشتههای خطا است — استفاده میکند تا دقیقاً ردیابی کند که یک حادثه خاص چند بار رخ داده است.
محدودیتهای طراحی برای قابلیت اطمینان
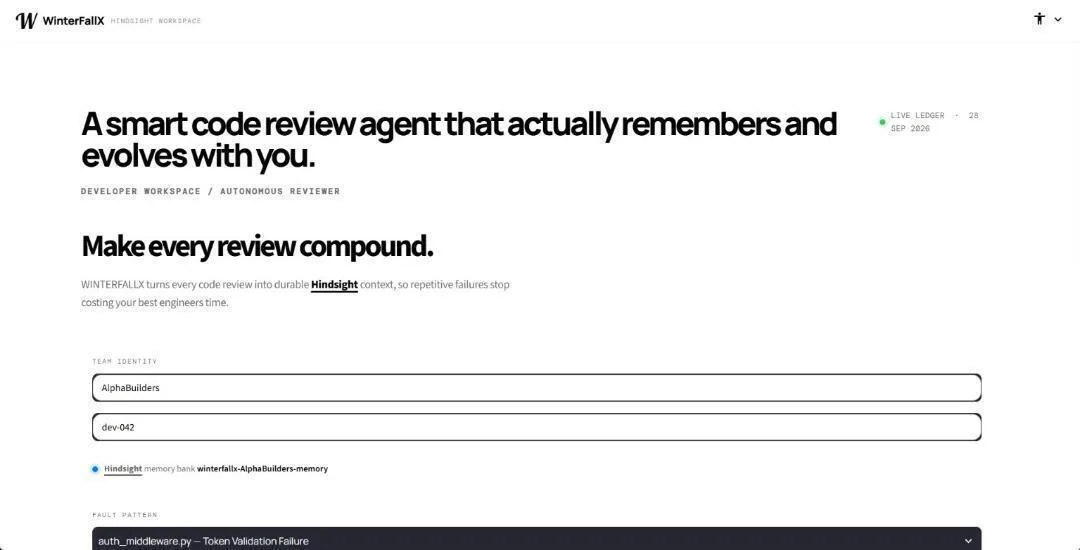
برای جلوگیری از ایجاد قوانین متضاد، سیستم برای هر تیم یک بانک حافظه اختصاصی تعیین میکند. اگر یک بانک حافظه جهانی وجود داشت، قوانین تیمهای مختلف که ممکن است با هم در تضاد باشند با هم ترکیب میشدند؛ از سوی دیگر، اگر حافظه برای هر توسعهدهنده بهصورت شخصی بود، دانش ارزشمند از افرادی که به آن نیاز دارند پنهان میماند.
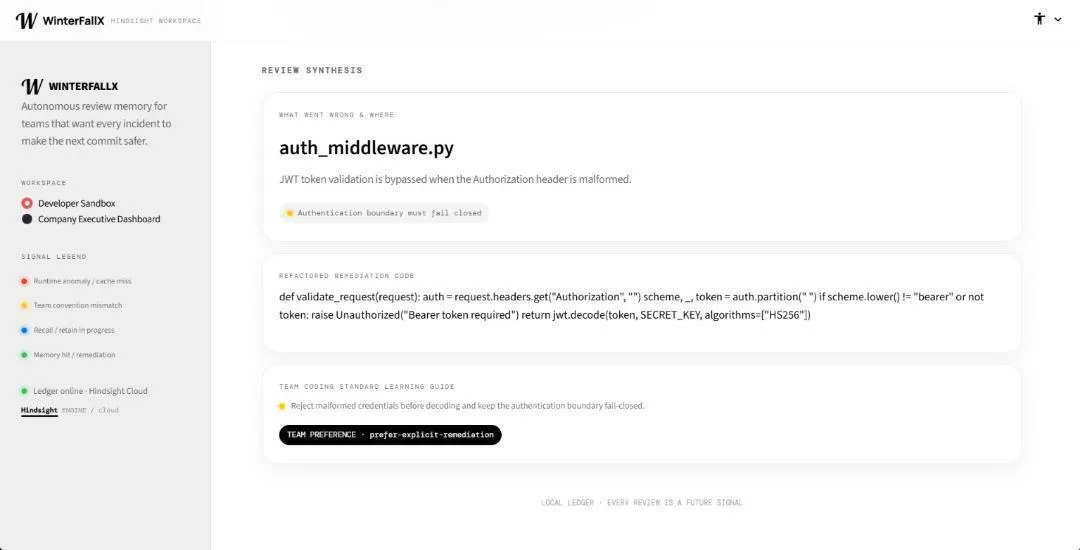
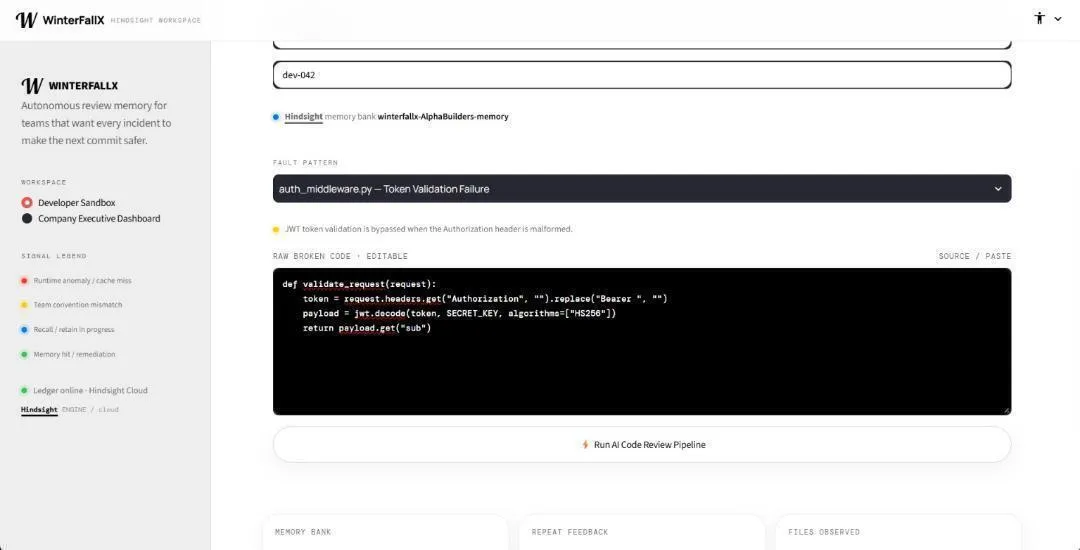
برای مثال، یک یادداشت برای تیم «آلفا» در مورد فایل http_client.py ممکن است ثبت کند که یک درخواست HTTP فاقد Timeout بوده و باعث متوقف شدن Worker شده است. در این حالت، قانون ذخیره شده این خواهد بود که «تمام فراخوانیهای خروجی باید Timeout داشته باشند» و راهکار اصلاحی آن «ارسال timeout=5 و مدیریت خطای Timeout» خواهد بود.
سیگنال در برابر نویز در بازیابی
در فرآیند بازیابی، سیستم بهطور خاص نام فایل و توصیف خطا را کوئری میکند و از کدهای خام چشمپوشی میکند. این یک انتخاب آگاهانه برای اجتناب از «نویز» است. نام متغیرها و فاصلههای خالی (Whitespace) اغلب نتایج را به سمت کدهایی میبرند که صرفاً ظاهر مشابهی دارند، در حالی که نام فایل و توصیف شکست، مشکل واقعی را توصیف میکنند.
مدیریت خطا و امنیت
پایداری سیستم از طریق استراتژی «شکست زودهنگام» (Fail-early) مدیریت میشود. از آنجا که بازیابی حافظه نیازمند یک فراخوانی شبکه است، سیستم فرآیند ذخیرهسازی را در بلوکهای try/except قرار داده است. اگر سرویس حافظه با خطا مواجه شود، بازبینی همچنان با استفاده از دفتر کل محلی تکمیل میشود تا عامل هرگز باعث کرش کردن کل خط لوله نشود. بازبینی که اعتراف کند حافظهاش در دسترس نیست، بسیار بهتر از بازبینی است که کل سیستم را متوقف کند.
علاوه بر این، سیستم امنیت را با نگه داشتن اعتبارنامهها (Credentials) در متغیرهای محیطی (Environment Variables) بهجای قرار دادن آنها در کد حفظ میکند و در صورت نبود هر یک از آنها، با یک پیام واضح بهصورت زودهنگام متوقف میشود.
دیدگاه مدیریتی
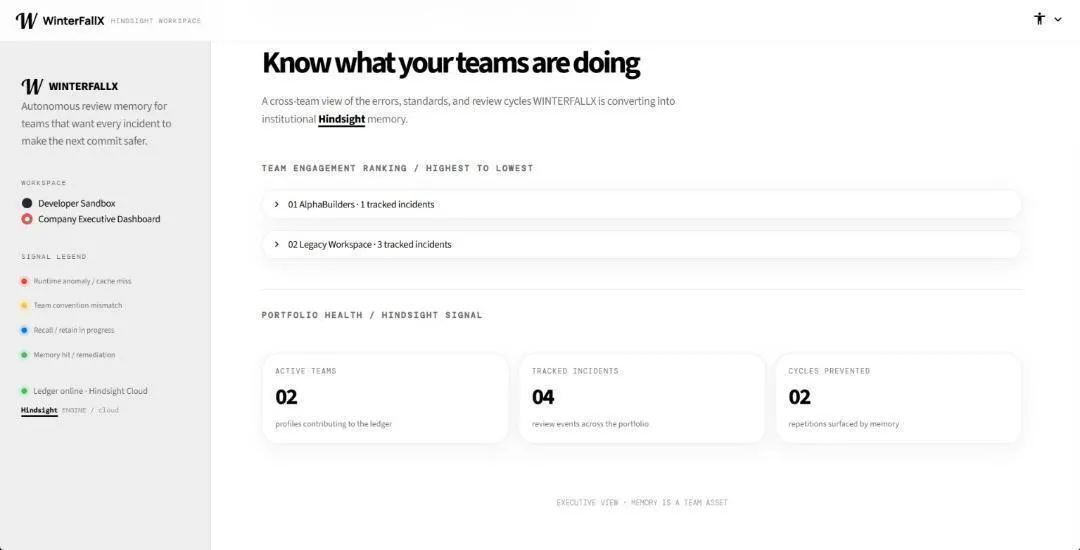
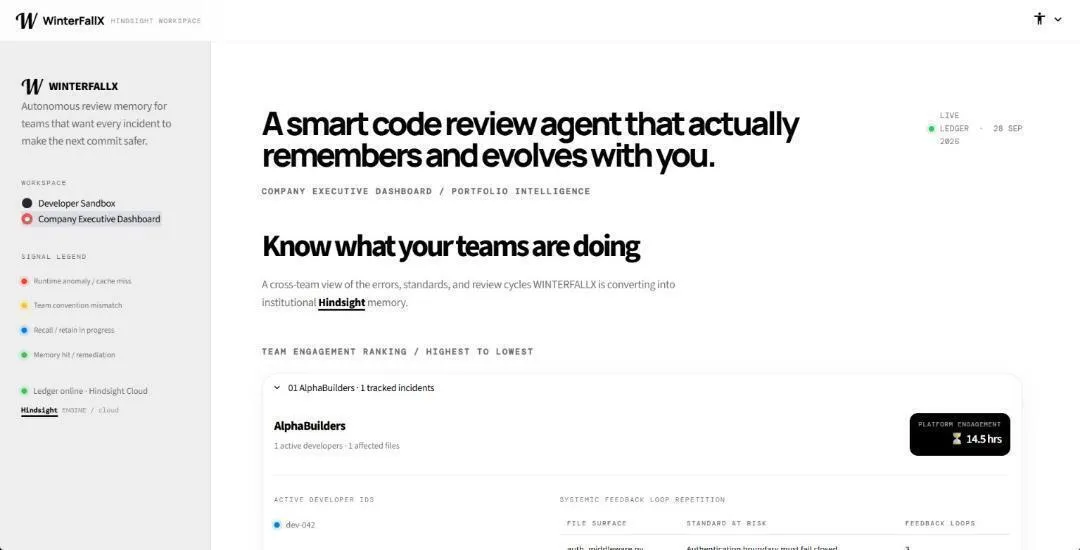
برای مدیریت، سیستم داشبوردی را ارائه میدهد که توسط یک کوئری SQL تغذیه میشود تا مجموع تکرارها را به تفکیک هر فایل محاسبه کند: SELECT file_name, SUM(repeats) AS total FROM incidents WHERE team = ? GROUP BY file_name ORDER BY total DESC. این ابزار به مدیران فنی اجازه میدهد شناسایی کنند کدام فایلها مشکلسازترین هستند و آیا تیم واقعاً از بازخوردهای هوش مصنوعی درس میگیرد یا خیر.
برای تشویق به پذیرش سیستم، حافظه بهصورت قابل مشاهده درآمده است. با نمایش اینکه چه جستوجویی اجرا شده و چند مورد حافظه بازگشته است، فرآیند از «اعتماد به عامل» به «راستیآزمایی عامل» تغییر میکند.
این تغییر، نقش هوش مصنوعی را از یک ابزار سادهی بررسی قواعد (Linter) به یک ابزار مدیریت دانش تبدیل میکند. ارزش واقعی در عملِ به یاد آوردن نیست، بلکه در تصمیمگیری درباره این است که چه چیزی ارزش به یاد سپردن دارد و چگونه این حافظه برای بازبین انسانی قابل مشاهده باشد.
برای مهندسانی که در حال ساخت عاملهای مشابه هستند، مخزن Hindsight ابزارهای بنیادی برای پیادهسازی این منطق retain-and-recall را فراهم میکند.
گام بعدی شما
- اگر از عاملهای بازبینی کد استفاده میکنید، بررسی کنید که آیا امکان پیادهسازی یک لایه ذخیرهسازی محلی برای خطاهای تکراری را دارید یا خیر.
- مخزن Hindsight را برای پیادهسازی منطق retain-and-recall در ابزارهای داخلی خود بررسی کنید.
- داشبورد تحلیل تکرار خطاها را برای شناسایی نقاط ضعف فنی در کدهای تیم خود طراحی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو