آیا هوش مصنوعی میتواند برای حل مسائلی که متن بهتنهایی از پس آنها برنمیآید، «به تصویر فکر کند»؟ ReImaGin، چارچوب جدیدی برای مدلهای بینایی-زبانی (Vision Language Model - VLM) که حاصل همکاری پژوهشگران آلمانی است، ثابت میکند که این توانایی دیگر منحصر به شناخت انسانی نیست و مدلها میتوانند برای استدلالهای پیچیده، تصاویر داخلی تولید کنند.
زمینه: تفکر بصری در انسان
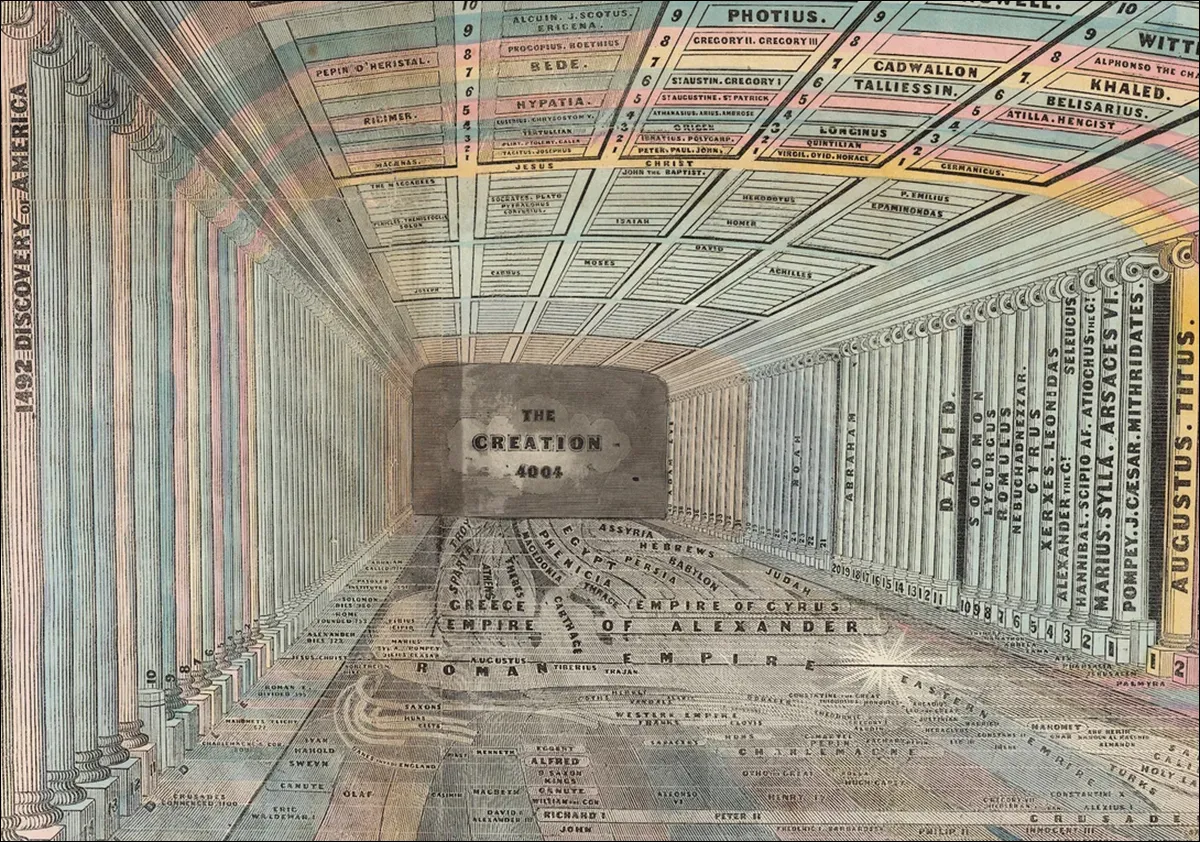
بشر قرنهاست که از یادآورهای بصری برای سازماندهی دادهها استفاده میکند. یک نمونه بارز، «معبد زمان» اثر اما ویلارد در سال ۱۸۴۶ است؛ یک بصریسازی آموزشی که ترتیب زمانی را به فضای فیزیکی تبدیل کرد. ویلارد با چیدمان دورههای تاریخی و شخصیتهای برجسته در یک چشمانداز معماری با عمق receding، به دانشجویان کمک کرد تا تصویری ذهنی و منسجم از تاریخ بسازند. او عمیقاً معتقد بود که این بازنماییهای گرافیکی برای اینکه دانشجویان بتوانند جریان زمان را بهدرستی درک کنند، ضروری هستند.
پژوهشها نشان میدهد کاهش ظرفیت تخیل بصری در انسان با افت عملکرد تحصیلی مرتبط است. این موضوع قدرت معنایی تصاویر زنده را بهعنوان ابزاری برای یادگیری برجسته میکند. در حالی که تکنیکهای یادآوری (Mnemonics) بر جذب دادهها تمرکز دارند، انسانها در «سبکهای» تفکر داخلی خود متفاوت هستند.
برخی افراد با اشکال فکر میکنند و از هندسه نسبی و بلوکهای حجمی پویا برای نمایش ایدهها، افراد، سالها و دههها استفاده میکنند. برخی دیگر عمدتاً با اعداد، بوها یا طعمها فکر میکنند. این نوع سینستزی (Synesthesia) داخلی به انسانها اجازه میدهد تا مدتها پیش از کسب مهارتهای زبانی، اطلاعات را از طریق مودالیتههای غیرمتنی پردازش کنند.
شکاف هوش مصنوعی در استدلال فضایی
مدلهای زبانی بزرگ (LLM) استاندارد، متن و اعداد را بهعنوان مفاهیم پردازش میکنند. اگرچه آنها میتوانند «با اعداد فکر کنند» — یعنی اعداد را بهجای مقادیر متغیر خالص، بهعنوان مفاهیم کدگذاری کنند — اما اغلب در حوزههای فضایی سطح بالا که فراتر از زبان است، شکست میخورند.
شواهدی از این محدودیت زمانی دیده میشود که یک مدل به یک سؤال واحد که در دو زبان مختلف ارائه شده، پاسخهای متفاوتی میدهد. این امر نشان میدهد که روابط در مدلها اغلب شکننده هستند و بهجای پرداختن به یک دامنه سطح بالا که شامل زبان است، به دامنههای زبانی خاص (مانند اسپانیایی) سختکد (Hard-coded) شدهاند.
مدلهای VLM فعلی معمولاً با تصاویر بهعنوان ورودیهای ایستا برخورد میکنند. اما ReImaGin تولید تصویر را به یک مکانیسم استدلالی انعطافپذیر تبدیل میکند و در واقع یک «تختهسیاه بصری» برای فرآیندهای زنجیره تفکر (Chain-of-Thought) داخلی مدل فراهم میکند. این قابلیت به مدل اجازه میدهد تا بهمعنای واقعی کلمه، زاویه دیدی جایگزین داشته باشد.
جزئیات: مکانیسم استدلال بصری
طبق مستندات این پژوهش، ReImaGin در یک حلقه تکرارشونده عمل میکند. در هر مرحله، مدل VLM پرسوجو، تصاویر اصلی و هرگونه محتوای تولیدشده قبلی را تحلیل میکند تا اقدام بعدی خود را تعیین کند. این اقدام میتواند یک گام استدلالی، یک عملیات تصویری متداول (مانند برش یا لایهگذاری) یا فراخوانی ابزار خاص generate_image باشد.
برخلاف سیستمهای پیشین که بخش بینایی را بهعنوان افزونههایی غیرضروری به مدل میچسباندند، ReImaGin از این تصاویر تولیدشده بهعنوان ورودیهای میانی برای گامهای استدلالی بعدی استفاده میکند. نکته کلیدی این است که هوش مصنوعی این تصاویر را برای کاربر تولید نمیکند؛ این تصاویر صرفاً برای پردازش داخلی خود مدل هستند.
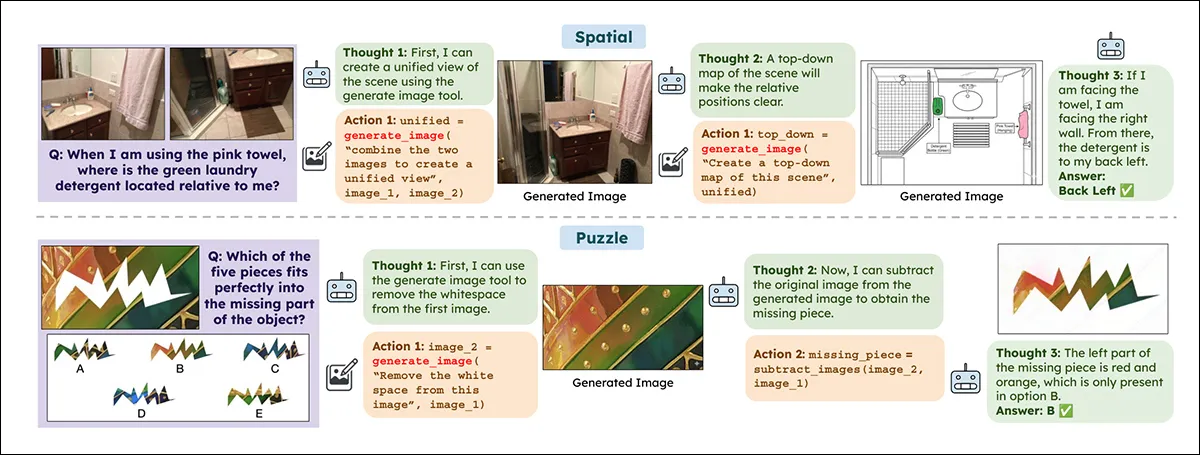
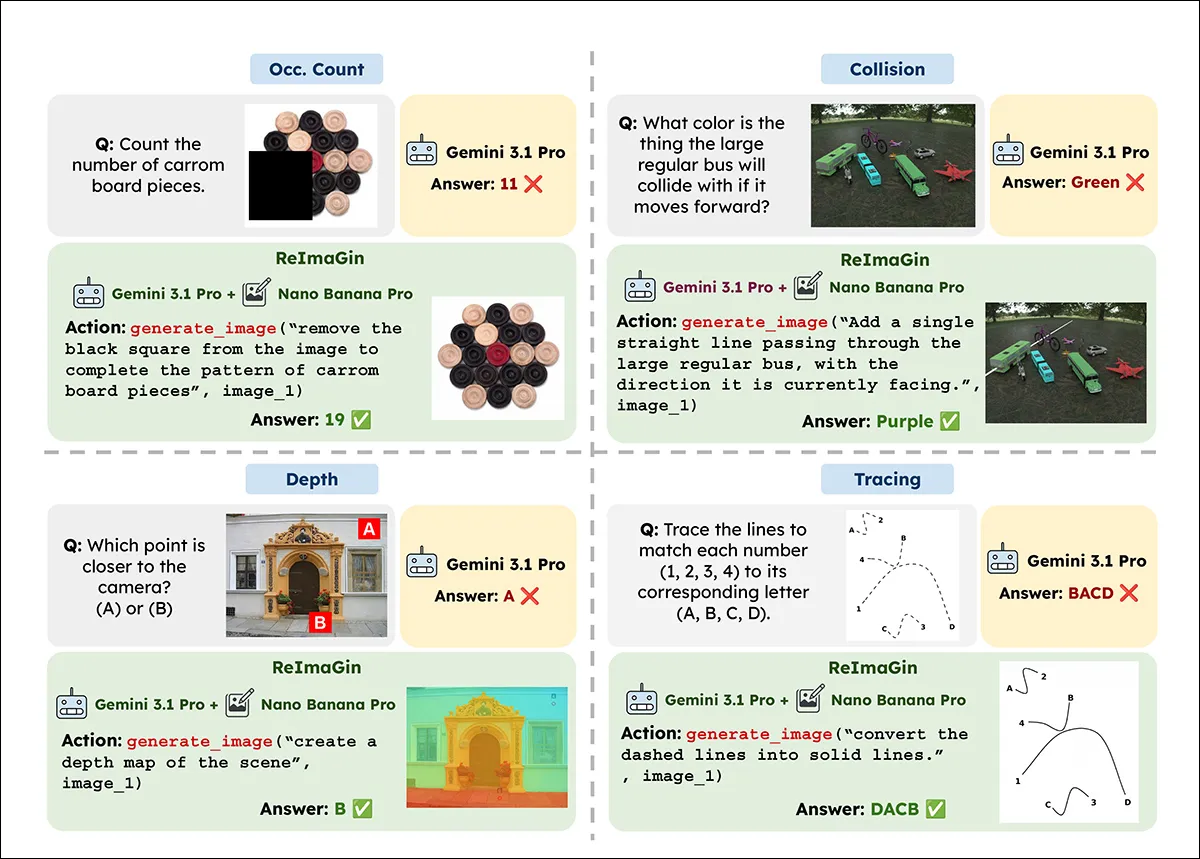
برای مثال، در یک مسئله فضایی، مدل ممکن است ابتدا دو عکس را در یک نمای واحد ترکیب کند، سپس آن نتیجه را به یک نقشه از بالا (Top-down map) تبدیل کند و در نهایت به سؤال پاسخ دهد. در یک مسئله پازل، مدل نسخهای تغییریافته از پازل را تولید میکند که ناحیه گمشده را ایزوله میکند و سپس از تفریق تصویری متداول برای شناسایی پاسخ استفاده میکند.
قابلیتهای تبدیل بصری
تواناییهای تبدیل بصری در این سیستم محدود به یک نوع نیست. مدل میتواند از ابزار generate_image برای موارد زیر استفاده کند:
- سنتز نماها: ترکیب چندین نمای ناقص در یک نقشه فضایی واحد یا یک بازنمایی بصری یکپارچه برای تفسیر تصویر گستردهتری از یک صحنه.
- حل پازلها: تکمیل نواحی گمشده پازل یا جداسازی مناطق خالی برای شناسایی پاسخها از طریق تفریق تصویری.
- تحلیل عمق: تولید نقشههای عمق (Depth maps) برای استدلالهای مربوط به فاصله، که نیاز به ابزارهای تخصصی درک عمق را از بین میبرد.
- پیشبینی حرکت: رسم مسیرهای حرکت (Trajectories) برای پیشبینی نقاط برخورد.
- شمارش اشیا: حذف موانع و انسدادها (Occlusions) برای شمارش اشیایی که پنهان شدهاند.
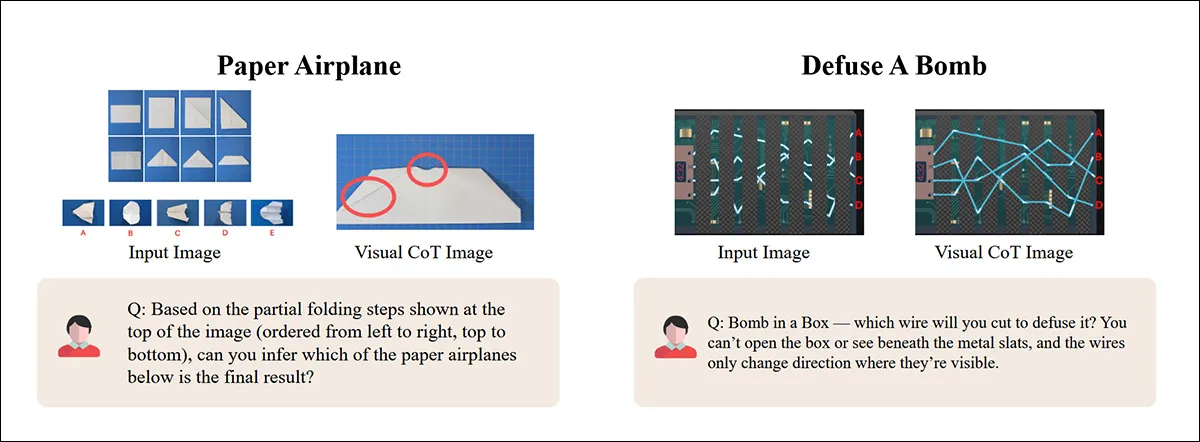
- ردیابی مسیر: تبدیل مسیرهای خطچین به خطوط ممتد برای ردیابی آسانتر.
به عنوان مثال، وقتی مدل با دو نمای ناقص از یک صحنه مواجه میشود، میتواند یک نقشه یکپارچه از بالا تولید کند تا اطلاعات را سنتز کند. این کار به مدل اجازه میدهد از یک بازنمایی بصری واحد استدلال کند، در حالی که هیچکدام از تصاویر اصلی بهتنهایی چنین اطلاعاتی را ارائه نمیدادند.
کشف خودکار استراتژی
یکی از بزرگترین چالشهای فنی، تشخیص این است که «کدام» تصویر واقعاً به حل یک مسئله خاص کمک میکند. از آنجا که ابزار generate_image دستورات متنی آزاد را میپذیرد، عامل (Agent) میتواند طیف وسیعی از تبدیلها را انجام دهد.
رویکرد استاندارد معمولاً نیازمند مثالهای دستی در متن (In-context examples) است تا یک استراتژی (مثلاً «یک نقشه عمق تولید کن») را نشان دهد، که این امر تعمیمپذیری را محدود کرده و نیازمند تلاش دستی برای هر وظیفه است. بهجای آن، ReImaGin از یک حلقه کشف خودکار برای بهینهسازی پرامپتها استفاده میکند:
- پیشنهاد: یک مدل پیشنهادی، پرامپتهای کاندید را برای تولیدکننده تصویر میسازد.
- ارزیابی: این پرامپتها روی یک مجموعه توسعه کوچک با پاسخهای مشخص آزمایش میشوند.
- اصلاح: سیستم بر اساس موفقیتها و شکستهای مشاهدهشده، پرامپتها را بازبینی و اصلاح میکند.
این فرآیند باعث میشود دستورالعملهای حاکم بر استفاده از ابزارها بدون نیاز به آموزش مجدد مدل VLM یا تولیدکننده تصویر، بهینه شوند. پژوهشگران این فرآیند را «کشف خودکار» استراتژیهای استدلال بصری مینامند، زیرا مدل یاد میگیرد چگونه بدون مثالهای دستنویس انسانی، از ابزارهایش استفاده کند.
بنچمارکها و عملکرد
بر اساس گزارش منتشرشده در ۲۸ سپتامبر ۲۰۲۶، این پژوهش ReImaGin را در شش محک (Benchmark) متمایز ارزیابی کرد:
- استدلال عمق (Blink): شناسایی اینکه کدام یک از دو نقطه به دوربین نزدیکتر است.
- تکمیل پازل (Mira): انتخاب قطعه صحیح برای یک ناحیه گمشده در تصویر.
- شمارش انسداد (CAPTURe): شمارش اشیا، از جمله آنهایی که پنهان شدهاند.
- پیشبینی برخورد (Spatial457): پیشبینی اینکه یک هدف متحرک به کدام شیء برخورد خواهد کرد.
- استدلال فضایی (MMSI): تعیین روابط بین اشیا در نماهای مختلف.
- ردیابی مسیر: یک بنچمارک جدید که مدلها را ملزم میکند خطوط خطچینی را که اعداد را به حروف متصل میکند، دنبال کنند.
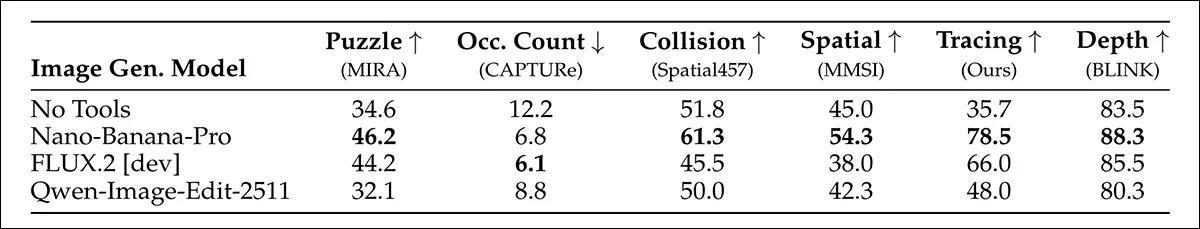
تیم پژوهشی این چارچوب را با مدلهای Gemini-3.1-Pro، GPT-5 و مدل با وزنهای باز (Open Weights) Qwen-3.5-27B آزمایش کردند. تولید تصاویر عمدتاً توسط Nano-Banana-Pro انجام شد، هرچند FLUX.2 [dev] و Qwen-Image-Edit-2511 نیز مورد تست قرار گرفتند. مدل Gemini-3.1-Pro بهعنوان انتخابگر برای مقیاسبندی زمان تست (Test-time scaling) تولید تصویر عمل کرد.
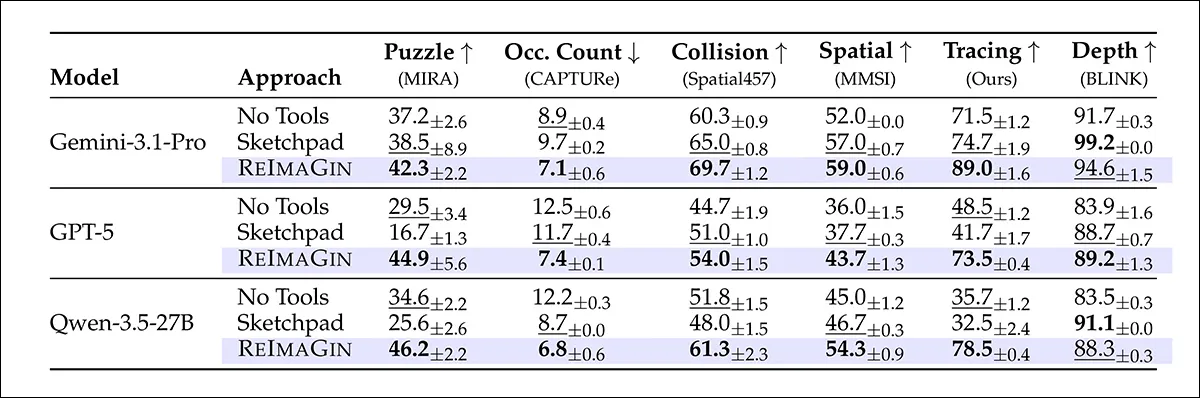
نتایج نشان داد که ReImaGin بهطور گسترده از مدلهای VLM معمولی (که با عنوان 'No Tools' ذکر شدهاند) و خطاساس Visual Sketchpad پیشی گرفته است. در حالی که Visual Sketchpad مجموعهای ثابت از ابزارهای تخصصی را ارائه میداد، فاقد قابلیت تولید تصویر باز و منعطف بود. در مسئله فضایی MMSI، هر دو خطاساس برای عدالت در قدرت محاسباتی، ۲۰ پاسخ تولید کردند و رایجترین نتیجه را برگزیدند، اما باز هم نتایج ضعیفتر بود.
عملکرد بر اساس دقت چندگزینهای اندازهگیری شد، بهجز در شمارش انسداد که از خطای درصد مطلق میانگین متقارن (sMAPE) برای مقایسه تعداد پیشبینیشده و واقعی اشیا استفاده شد. نتایج میانگین سه اجرا با گزارش خطای استاندارد بود. بیشترین پیشرفت در تکمیل پازل و شمارش اشیا دیده شد؛ برای مثال با استفاده از GPT-5، صحت پاسخها در پازل از ۲۹.۵٪ (بدون ابزار) و ۱۶.۷٪ (Visual Sketchpad) به ۴۴.۹٪ با ReImaGin رسید. این جهش در توانایی حل مسائل پیچیده، در کنار گزارشهای اخیر MIT مبنی بر توانایی مدلها در حل تکالیف لیسانس، نشاندهنده تحولی سریع در استدلالهای سطح بالای هوش مصنوعی است.
قابلیت اطمینان و تحلیل خطا
با این حال، سیستم بینقص نیست. پژوهشگران تستهای کیفی و یک بازرسی دستی روی ۱۲۰ تصویر تولیدشده انجام دادند. آنها دریافتند که ۷۵٪ از تصاویر، تبدیل درخواستی را بهدرستی انجام دادهاند.
شکستها به دو شکل اصلی رخ داد: یا تولیدکننده تصویر یک تبدیل نادرست ایجاد کرد (مانند یک نقشه کف که اشیا در جای اشتباه بودند)، یا مدل VLM تصویری را که در واقع درست بود، اشتباه خواند.
تأثیر این خطاها بر دقت نهایی بسیار شدید بود: وقتی تصویر تولیدشده دقیق بود، پاسخ نهایی در ۸۷٪ موارد صحیح بود. اما زمانی که تصویر نادرست بود، نرخ موفقیت به ۴۳٪ سقوط کرد. این موضوع یادآور این نکته است که تصاویر تولیدشده توسط هوش مصنوعی اغلب حدسهای آماری هستند و لزوماً بر پایه درک عمیق از واقعیتهای بصری نیستند.
تغییر پارادایم در VLM
این رویکرد نشان میدهد که تولید تصویر میتواند بهعنوان یک مکانیسم «تخیل بصری» عمومی عمل کند. ReImaGin با کاهش نیاز به ابزارهای تخصصی و وابسته به وظیفه برای هر تبدیل جدید، به سمت شکلی عاملمحور (Agentic) از هوش مصنوعی چندوجهی حرکت میکند.
نویسندگان نتیجه میگیرند که اثربخشی این رویکرد نه تنها به مدلها، بلکه به استراتژی استدلالی مورد استفاده برای تصمیمگیری درباره «چه چیزی باید بصریسازی شود» بستگی دارد. این واقعیت که مدلها میتوانند این استراتژیها را بدون مثالهای دستنویس انسانی کشف کنند، نشان میدهد که آنها میتوانند از درک خود از تبدیلهای بصری بهره ببرند.
از دیدگاه فنی، این موضوع معیار ارزیابی VLMها را از توصیف ساده تصویر-به-متن به دستکاری فعال بصری برای حل مسئله تغییر میدهد. این امر این فرض را به چالش میکشد که مدلهای تنظیمشده (Fine-tuned) اختصاصی — جایی که یک مدل کامل به یک وظیفه واحد اختصاص مییابد — تنها راه دستیابی به دقت بالا هستند. با این حال، در دنیایی که مدلها به سرعت در حال جایگزینی مهارتهای تحلیلی هستند، حفظ تفکر انتقادی تنها سد دفاعی انسان در برابر وابستگی مطلق به این سیستمهاست.
با این حال، اتکا به دقت تولیدکننده تصویر همچنان یک گلوگاه است. اگر تصویر «تخیلی» نقص داشته باشد، کل زنجیره استدلال فرو میپاشد. این موضوع وابستگی حیاتی به کیفیت تولیدی مدل زیربنایی را برجسته میکند. تولیدکنندههای وزنباز مانند FLUX.2 [dev] و Qwen-Image-Edit-2511 در کارهای ساده Inpainting مشابه بودند اما در وظایف دشوارتر مانند ردیابی مسیر و تخمین عمق، ثبات کمتری داشتند. نتایج مشابهی هنگام استفاده از Qwen-3.5-27B بهعنوان VLM مشاهده شد، جایی که Nano-Banana-Pro در پنج مورد از شش وظیفه بهترین نتیجه را به دست آورد.
باید دید آیا این رویکرد ابزار داخلی، جایگزین کتابخانههای سنتی بینایی ماشین مانند اکوسیستم Segment میشود یا خیر، زیرا VLMها در حال تکامل برای مدیریت خودمختار وظایف فضایی تخصصی هستند. هنوز مشخص نیست که آیا VLMها میتوانند برتری خود را نسبت به تنظیم دقیق محلی (Local fine-tuning)، جایی که مدلها به یک وظیفه واحد اختصاص مییابند، حفظ کنند یا خیر.
گام بعدی شما
- اگر توسعهدهنده VLM هستید، بررسی کنید که آیا مدل شما میتواند برای مسائل فضایی، پیشنویسهای تصویری داخلی بسازد یا صرفاً به توصیفات متنی متکی است.
- ابزارهای تولید تصویر با قابلیت ویرایش دقیق (مانند Qwen-Image-Edit) را برای پیادهسازی زنجیرههای استدلال بصری آزمایش کنید.
- دنبال کنید که آیا این رویکرد جایگزین کتابخانههای سنتی بینایی ماشین مانند Segment میشود یا خیر.
اما تأثیر این تخیل بصری بر مدلهای کوچکتر و استقرار آنها در لبه (Edge) حتی جذابتر است — به تحلیل ما درباره مدلهای SLM مراجعه کنید.



گفتگو