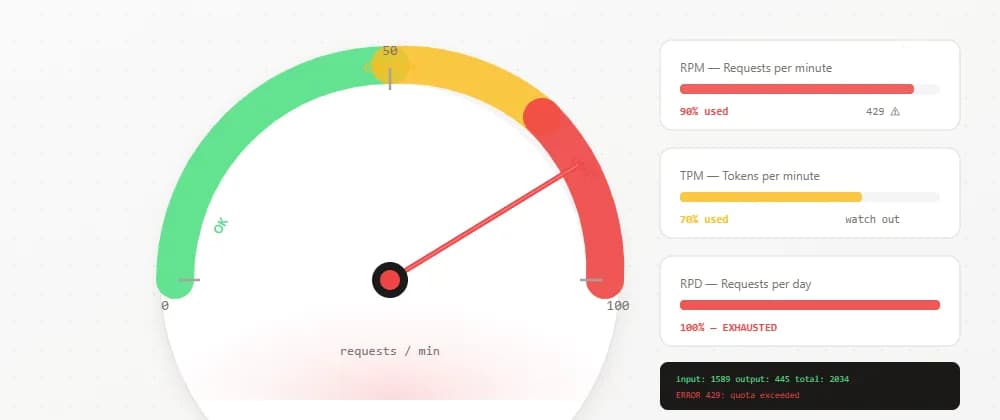
اگر امروز از لایه رایگان Gemini API برای ساخت اپلیکیشن خود استفاده میکنید، احتمالاً با خطای ناگهانی ۴۲۹ مواجه شدهاید و نمیدانید چرا سهمیه شما بهسرعت تمام شده است. در حالی که توسعهدهندگان اغلب انتظار دارند هنگام مقیاسبندی یکپارچگی Gemini API با یک صورتحساب غافلگیرکننده روبرو شوند، شکست واقعی معمولاً بسیار ناگهانیتر است: خطای 429 Too Many Requests. این اتفاق یک نقص فنی نیست، بلکه نتیجهی یک «نشت توکن» در معماری حافظه برنامه شماست.
به نقل از شام پراکاش (Sham Prakash)، مهندس بکاند، در ۲۹ سپتامبر ۲۰۲۶ فاش شد که محدودیتهای لایه رایگان بسیار سریعتر از حد انتظار به پایان میرسند. دلیل این امر، انباشت خاموش توکنها در حافظه گفتگو است. در تجربه او، اپلیکیشن بهسادگی از ارائه پاسخها باز میماند و خطا برمیگرداند، زیرا سهمیه (Quota) بدون اینکه توسعهدهنده متوجه شود، تمام شده است. برخی توسعهدهندگان برای مقابله با این وضعیت به روشهای غیرمتعارف روی آوردهاند، مشابه آنچه در مورد دور زدن تله سهمیه گوگل توسط Antigravity Autopilot مشاهده شد.
مدیریت این محدودیتها حیاتی است چون در لایه رایگان، گوگل بهجای صدور صورتحساب، بهسادگی دسترسی اپلیکیشن را قطع میکند. این رویکرد بخشی از یک روند گستردهتر در گوگل برای اصلاح اکوسیستم هوش مصنوعی است؛ مشابه اتفاقی که در مورد تبدیل «Gems» سفارشی به «Skills» برای سادهسازی قابلیتهای کاربر رخ داد. برای یک توسعهدهنده، برخورد با سقف نرخ درخواست (Rate Limit) صرفاً یک نقص فنی نیست، بلکه سیگنالی است که نشان میدهد معماری حافظه اپلیکیشن ناکارآمد است. مصرف توکن یک مفهوم انتزاعی نیست، بلکه یک شمارنده واقعی است که با هر فراخوانی API بالا میرود.
سه ستون محدودیتهای نرخ درخواست
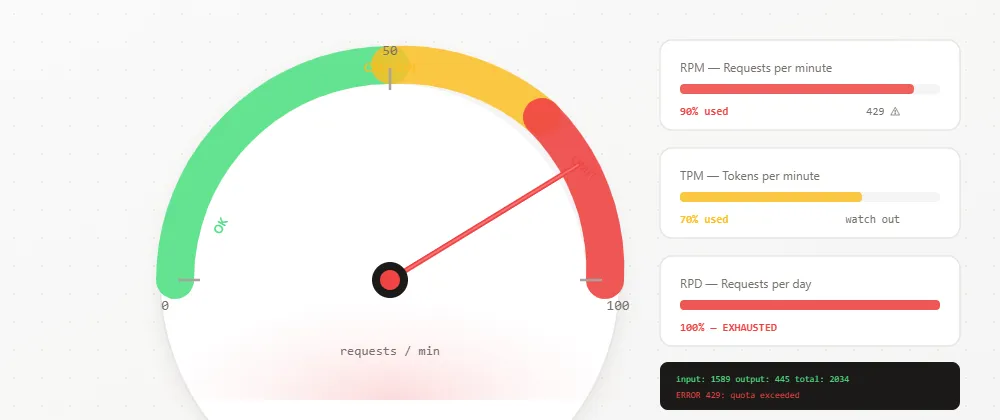
طبق مستندات گوگل ایآی استودیو (Google AI Studio)، سه محدودیت مجزا بر API اعمال میشود. اگر هر یک از این موارد رد شود، API خطای ۴۲۹ را برمیگرداند و برنامه تا زمان بازنشانی پنجره زمانی متوقف میشود:
- RPM (درخواست در دقیقه): تعداد کل فراخوانیهای API که میتوانید در یک پنجره ۶۰ ثانیهای انجام دهید.
- TPM (توکن در دقیقه): مجموع توکنهای ورودی و خروجی که میتوانید در هر دقیقه ارسال و دریافت کنید.
- RPD (درخواست در روز): تعداد کل فراخوانیهای API مجاز در یک بازه ۲۴ ساعته.
از آنجایی که این محدودیتها با بهروزرسانیهای گوگل در لایه رایگان تغییر میکنند، به توسعهدهندگان توصیه میشود محدودیتهای فعلی مدل خاص خود را در صفحه محدودیتهای نرخ Gemini API در AI Studio بررسی کنند.
چرا توکنها بهسرعت ناپدید میشوند؟
بسیاری از برنامهنویسان هزینه توکنها را دستکم میگیرند چون هر پیام را یک واحد میبینند. اما در واقعیت، سه عامل پنهان باعث میشود مصرف به شدت افزایش یابد و شما خیلی زود به «دیوار» محدودیتها برخورد کنید:
۱. انباشت تاریخچه: وقتی از حافظه گفتگو استفاده میکنید، هر پیام جدید، تمام تاریخچه قبلی را هم با خود میفرستد. در ساختاری که اسپرینگ ایآی (Spring AI) ۲۰ پیام آخر را شامل شود، فراخوانی بیستم هزینه ۱ پیام را ندارد، بلکه هزینه تا ۲۰ پیام را دارد. برای مثال، یک گفتگوی ۱۰ مرحلهای (رفت و برگشتی) هزینهای تصاعدی دارد: فراخوانی اول هزینه ۱ پیام، فراخوانی دوم هزینه ۳ پیام (۱+۲)، فراخوانی سوم هزینه ۶ پیام (۱+۲+۳) و در نهایت در فراخوانی دهم، شما هزینه ۵۵ پیام را میپردازید.
۲. سربار پرامپت سیستمی: هر درخواست شامل پرامپت سیستمی (System Prompt) است. اگر پرامپت سیستمی شما ۲۰۰ کلمه باشد، این یعنی تقریباً ۲۷۰ توکن به صورت خاموش به هر تک فراخوانی API اضافه میشود.
۳. پُرگویی مدل: پاسخهای مدل نیز از بودجه TPM شما کم میکنند. یک پاسخ طولانی و مفصل هزینه بیشتری نسبت به یک پاسخ کوتاه دارد و مدل بهصورت پیشفرض تا هر کجا که بخواهد پرگویی میکند.
پیادهسازی شفافیت در Spring Boot
برای پایان دادن به حدس و گمان، توسعهدهندگان در Spring AI باید بهجای متد .content() از .chatResponse() استفاده کنند. این کار اجازه میدهد اپلیکیشن به شیء متادیتای Usage دسترسی پیدا کند.
با تغییر متد چت به chatResponse()، میتوانید معیارهای دقیق هر فراخوانی را لاگ بگیرید:
@PostMapping("/chat-ai")
public String chat(@RequestBody Map<String, String> request) {
    ChatResponse response = chatClient.prompt()
        .user(request.get("message"))
        .advisors(a -> a.param("chat_memory_conversation_id", request.get("conversationId")))
        .call()
        .chatResponse();

    Usage usage = response.getMetadata().getUsage();
    log.info("Tokens — input: {}, output: {}, total: {}",
        usage.getPromptTokens(), usage.getGenerationTokens(), usage.getTotalTokens());

    return response.getResult().getOutput().getText();
}
این شفافیت، واقعیت پنجره زمینه (Context Window) را آشکار میکند. لاگها نشان خواهند داد که تعداد توکنهای ورودی با هر پیام رشد میکند (مثلاً از ۸۴۷ به ۱۲۰۳ و سپس به ۱۵۸۹ توکن)، که ثابت میکند تاریخچه چگونه انباشته میشود.
ردیابی مجموع نشستها
پراکاش پیشنهاد میکند برای ردیابی مجموع توکنهای هر نشست از یک ConcurrentHashMap استفاده کنید. این کار انباشت را قابل مشاهده کرده و معیاری برای اقدام فراهم میکند:
private final Map<String, Integer> sessionTokens = new ConcurrentHashMap<>();

// Inside the chat method:
Usage usage = response.getMetadata().getUsage();
int callTokens = usage.getTotalTokens();
int runningTotal = sessionTokens.merge(conversationId, callTokens, Integer::sum);
log.info("conversationId: {} | this call: {} tokens | session total: {} tokens",
    conversationId, callTokens, runningTotal);
استراتژیهای کاهش توکن
کاهش نرخ مصرف نیازمند ترکیبی از مهندسی پرامپت (Prompt Engineering) و مدیریت حافظه است:
- پرامپتهای سیستمی مینیمال: هر کلمه اضافی در هر فراخوانی هزینه دارد. هر چیزی که «نقش حیاتی» ندارد را حذف کنید. برای مثال، جایگزین کردن یک پرامپت پرگویی («شما یک دستیار هوش مصنوعی مفید و مهربان هستید... همیشه لحنی مثبت و مشوق داشته باشید») با یک پرامپت موجز («شما یک دستیار مفید هستید. موجز و کاربردی باشید»)، بخش قابل توجهی از توکنها را در هر فراخوانی ذخیره میکند.
- کوچک کردن پنجره حافظه: در حالی که
maxMessages(20)پیشفرض خوبی است، کاهش آن بهmaxMessages(10)در محیط توسعه از تورم زمینه جلوگیری میکند. پیامهای قدیمی در یک گفتگوی طولانی بهندرت بر پاسخ فعلی تأثیر میگذارند. - اجبار به ایجاز: از طریق پرامپت سیستمی به مدل بگویید موجز باشد: «موجز باش — در ۲ تا ۳ جمله پاسخ بده مگر اینکه کاربر جزئیات بیشتری بخواهد». این کار مستقیماً تعداد توکنهای خروجی را کاهش میدهد.
- بازنشانی نشستها: در طول توسعه، برای هر مورد تست یک نشست جدید شروع کنید. یک نشست تازه دارای تاریخچه صفر است، به این معنی که هر فراخوانی فقط هزینه پرامپت سیستمی و یک پیام را دارد، نه تاریخچه انباشته شده از ۲۰ تبادل.
معماریهای پیشرفته حافظه
همانطور که اپلیکیشنها از نمونههای اولیه ساده فراتر میروند، رویکرد «پنجره لغزان» (نگهداری N پیام آخر) ناکافی میشود زیرا مدل زمینه ابتدایی را فراموش میکند. اگر کاربر در پیام اول نام خود را گفته باشد و گفتگو اکنون به پیام ۲۵ رسیده باشد، مدل آن را فراموش کرده است. پراکاش سه جایگزین حرفهای را شرح میدهد:
- خلاصهسازی (Summarization): وقتی تاریخچه به یک حد نصاب رسید (مثلاً ۱۵ پیام)، از مدل خواسته میشود پیامهای قدیمیتر (مثلاً ۱۰ مورد اول) را در یک پاراگراف فشرده ۴ تا ۵ جملهای خلاصه کند. این کار میتواند ۲۰۰۰ توکن تاریخچه خام را به ۱۵۰ توکن خلاصه تبدیل کند. این همان الگویی است که در Claude Code استفاده شده است. هزینه این کار، یک فراخوانی API اضافی برای انجام خلاصهسازی است.
- حافظه مبتنی بر RAG: بهجای ارسال پیامهای اخیر، هر پیام به عنوان یک Embedding در یک پایگاهداده برداری (Vector Database) ذخیره میشود. سیستم بهدنبال مرتبطترین پیامهای گذشته میگردد — نه لزوماً جدیدترینها — و این اجازه میدهد گفتگویی از هفته گذشته اگر به پرامپت فعلی مرتبط باشد، بازیابی شود.
- استخراج ساختاریافته (Structured Extraction): سیستم حقایق خاص را در یک ذخیره داده استخراج میکند (مثلاً
{"user_name": "Sham", "project": "Spring Boot AI chat app"}). مدل این ذخیره حقایق را به همراه پیامهای اخیر دریافت میکند که برای اپلیکیشنهای طولانیمدت بسیار بهینهتر است و روشی است که ویژگی حافظه ChatGPT از آن استفاده میکند.
این تغییر در مدیریت حافظه، این فرض بنیادی را که «زمینه بیشتر همیشه برابر با عملکرد بهتر است» تغییر میدهد. در محیط عملیاتی (Production)، هدف حافظه حداکثری نیست، بلکه بهینهترین ارتباط (Relevance) به ازای هر توکن است.
چه زمانی ارتقا دهیم؟
لایه رایگان برای یادگیری و ساخت دموها کافی است، اما زمانی با دیوار ۴۲۹ برخورد خواهید کرد که تستهای سنگین با نشستهای کوتاه زیاد انجام دهید، گفتگوها طولانی شوند یا چندین نفر بهطور همزمان از اپلیکیشن استفاده کنند.
هنگام ارتقا به لایه پولی، محدودیتهای نرخ بهطور قابل توجهی افزایش مییابد و صورتحساب به مدل «به ازای هر میلیون توکن» تغییر میکند. در آن نقطه، زیرساخت لاگگیری که در اینجا ساخته شد برای مدیریت هزینهها ضروری میشود. عدم توجه به این جزئیات میتواند منجر به بحرانهای مالی شود، همانطور که اوبر بودجه سالانه هوش مصنوعی خود را در چهار ماه تمام کرد. عادتهای کلیدی ثابت میمانند: هر فراخوانی را لاگ کنید، رشد توکنهای ورودی را زیر نظر بگیرید، پرامپتهای سیستمی را مینیمال نگه دارید و در طول تست از نشستهای تازه استفاده کنید.
در مرحله بعد، تمرکز بر نوشتن پرامپتهای سیستمی است که نه تنها آنچه مدل میگوید، بلکه نحوه تفکر مدل درباره مسئله را شکل میدهند. برای جلوگیری از هزینههای پیشبینی نشده، پیادهسازی بودجهبندی در سطح اجرا راهکاری کلیدی برای کنترل مصرف در مقیاس بزرگ است.
گام بعدی شما
- متد
.chatResponse()را در کد خود جایگزین کنید تا مصرف واقعی توکنها را ببینید. - پرامپتهای سیستمی خود را بازبینی کرده و کلمات غیرضروری را حذف کنید.
- برای گفتگوهای طولانی، استراتژی خلاصهسازی (Summarization) را پیادهسازی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو