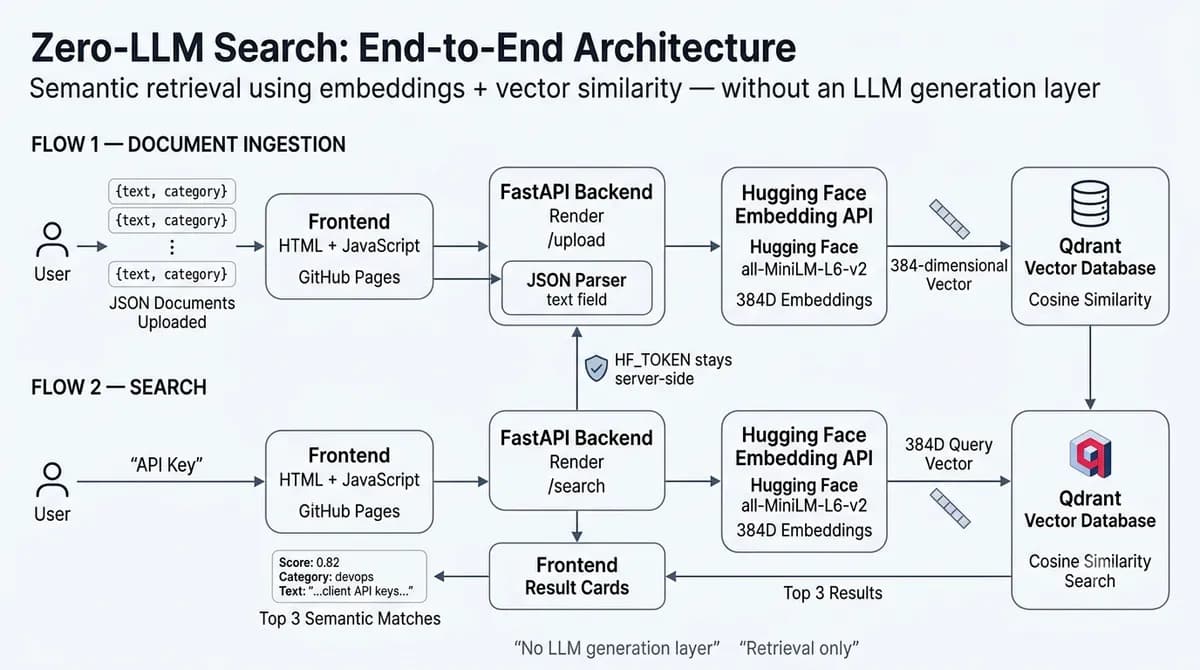
اگر امروز برای هر درخواست جستوجوی هوشمند در اپلیکیشن خود هزینه API میپردازید، باید بدانید که میتوان یک موتور جستوجوی معنایی در سطح صنعتی (Production-grade) را با هزینه ماهانه صفر دلار پیاده کرد. این کار با حذف کامل مدلهای زبانی زاینده (Generative LLMs) از چرخه بازیابی امکانپذیر است. با ترکیب یک معماری Jamstack مجزا و استفاده از Embeddingهای سرورلس، توسعهدهندگان میتوانند پرسوجوهای حساس به متن (Context-aware) را در زمانهای تکرقمی میلیثانیه اجرا کنند، بدون اینکه بودجه خود را صرف صورتحسابهای غیرقابلپیشبینی توکنها کنند.
این تغییر رویکرد در حالی رخ میدهد که «خستگی از هوش مصنوعی زاینده» در حال تسخیر صنعت است. این نقطه عطف زمانی اتفاق میافتد که نگرش کلی نسبت به هوش مصنوعی زاینده به دلیل مسائل مربوط به قابلیت اطمینان و هزینهها تغییر میکند. طبق مطالعات اکوسیستم جهانی که در گزارشی به تاریخ ۲۳ سپتامبر ۲۰۲۶ در وبسایت dev.to منتشر شد، بیش از ۸۰٪ توسعهدهندگان نرمافزار از وابستگی به دستیارهای هوش مصنوعی عمومی رنج میبرند که منجر به کاهش شدید اعتماد در مورد دقت این ابزارها شده است. نیاز مداوم به اعتبارسنجی خروجیها، اعتماد به دقت مدلهای زاینده را تخریب کرده است. این وضعیت بازتابدهنده نگرانیهایی است که در پوششهای قبلی ما دربارهی جیمز میکنز (James Mickens) دیدیم؛ او استدلال میکرد که «ناخوانایی زبانی» باعث میشود نظارت بر زبان مدلهای زبانی بزرگ اساساً نامطمئن و غیرمنطقی باشد.
تغییر استراتژیک در سازمانها
برای بسیاری از سازمانها، هزینه و غیرقابلپیشبینی بودن مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — به یک نقطه ضعف و بدهی تبدیل شده است. به گزارش برخی منابع، شرکت Amazon تیمهای مهندسی خود را ترغیب کرده تا ۸۰٪ از رابطهای هوش مصنوعی شخص ثالث را از طریق مقررات داخلی کنار بگذارند. این رویکرد بهینهسازی در مدیریت ابزارهای هوش مصنوعی، مشابه استراتژیهایی است که فروشندگان آمازون برای مدیریت مقیاسپذیر محصولات خود به کار میگیرند تا بهرهوری را بدون افزایش هزینههای عملیاتی بالا ببرند. این روند با «اصل پارتو» (یا قانون ۸۰/۲۰) در طراحی محصول همسو است: دادههای Pendo نشان میدهد ۸۰٪ قابلیتهای یک محصول متوسط بر پایه ناوبری ساده و جستوجوی دادههاست؛ کارهایی که اصلاً نیازی به یک مدل زاینده ندارند.
در حال حاضر، اصطلاح «جستوجوی هوش مصنوعی» بهاشتباه برای توصیف مدلهای زایندهای به کار میرود که اگرچه مؤثر هستند اما کند بوده و برای پردازش پرسشهای ساده، منابع زیادی مصرف میکنند. با جداسازی مکانیزم جستوجو از لایه تولید متن (Generative Layer)، توسعهدهندگان میتوانند از شر صورتحسابهای «بهازای هر توکن» API خلاص شوند که اغلب بودجه پروژهها را میبلعد.
مکانیزم فنی
برخلاف جستوجوی کلیدواژهای که فقط بر توالی دقیق کاراکترها تکیه دارد، جستوجوی معنایی (Semantic Search) جملات را به صورت بردارهای عددی نمایش میدهد. در یک سیستم کلیدواژهای، اگر کاربر عبارت «چگونه از مسیرها محافظت کنم» (how to protect routes) را جستوجو کند، مقالهای با عنوان «پیکربندی میانافزار احراز هویت امن JWT» (Configuring secure JWT authentication middleware) را پیدا نمیکند، زیرا کاراکترها با هم مطابقت ندارند.
جستوجوی معنایی این مشکل را با قرار دادن کلمات در یک فضای هندسی حل میکند. چون کلمات «محافظت» (protect) و «امن» (secure) در هندسه بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که میگوید این کلمه همسایهی چه کلمات دیگری است — در یک فضای مشترک قرار دارند، سیستم بدون پیچیدگیهای اضافی و به صورت شهودی، پاسخ درست را پیدا میکند.
برای دور زدن محدودیتهای حافظه در سرورهای رایگان (Free-tier)، که اغلب دسترسی به مدلهای سنگین یادگیری ماشین را ممنوع میکنند، معماری پیشنهادی بار پردازشی را به یک خط لوله سرورلس منتقل میکند:
- بردارها (Embeddings): از طریق Hugging Face Inference API تولید میشوند و بردارهای متراکمی با ۳۸۴ بُعد ایجاد میکنند.
- بکاند: یک اسکریپت FastAPI که یک نمونه پایگاهداده Qdrant را در حافظه (In-memory) مدیریت میکند.
- فرانتاند: رابط HTML5/CSS3 تمیز که روی GitHub Pages میزبانی میشود.
- زیرساخت: موتور پایتون روی Render اجرا میشود و از یک تنظیمات سرورلس برای صفر نگه داشتن هزینهها استفاده میکند.
جزئیات پیادهسازی
در بخش پیادهسازی، بکاند از QdrantClient با تنظیمات :memory: استفاده میکند تا تطبیق سریع نزدیکی (Proximity Matching) از طریق شباهت کسینوسی (Cosine Distance) انجام شود. سیستم یک مجموعه (Collection) به نام "enterprise_docs" میسازد و دو مسیر (Route) اصلی را پیاده میکند:
- /upload: برای وارد کردن انبوه اسناد (Bulk Ingestion). این مسیر دادههای JSON را میخواند، متن را استخراج کرده و متادیتای مربوطه شامل دستهبندیها (که به طور پیشفرض روی "general" است) را تولید میکند. همچنین شناسههای تولید شده را از عدد ۱ تا تعداد اسناد اختصاص میدهد.
- /search: برای تطبیق نزدیکی برداری. این مسیر اجازه میدهد نتایج بر اساس دستهبندی با استفاده از
models.FieldConditionفیلتر شوند تا نتایج محدودتر شده و در نهایت تنها ۳ مورد اول از مرتبطترین نقاط برگردانده شوند.
برای حفظ سبک بودن سیستم و اشغال کمترین فضای حافظه، کل پشته تنها به چند وابستگی ضروری نیاز دارد: fastapi ،uvicorn ،python-multipart ،qdrant-client و requests. این موضوع اجازه میدهد تا کل سیستم در محدودیتهای سختگیرانه حافظه ابرهای رایگان اجرا شود.
تست ماتریس برداری
برای تست قابلیت گروهبندی برداری، میتوان از یک مجموعه داده ساختاریافته (knowledge_base.json) استفاده کرد. این کار به توسعهدهندگان اجازه میدهد تایید کنند که سیستم به جای کلیدواژهها، بستر و مفهوم (Context) را میفهمد:
- گروه امنیت: رشتههای متنی مربوط به «میانافزار احراز هویت JWT» و «جریانهای کد مجوز OAuth2 با PKCE» در یک گروه قرار میگیرند.
- گروه DevOps: ورودیهایی مانند «ذخیره کلیدهای API کلاینت در بکاند کشینگ Redis با TTL پنج دقیقهای برای کاهش فشار روی پایگاهداده».
- گروه تست: «پیکربندی خط لولههای خودکار CI/CD در GitHub Actions برای تحریک تستهای واحد با فریمورک Jest».
یک نکته حیاتی در مورد زیرساخت وجود دارد: چون موتور روی سرویسهای رایگان ابرهای عمومی اجرا میشود، ارائهدهنده ابر کانتینر وب را پس از یک دوره مشخص از بیکاری به حالت خواب (Sleep mode) میبرد. این یعنی اولین درخواست پس از یک وقفه طولانی، ممکن است ۳۰ تا ۶۰ ثانیه زمان ببرد تا سرور بیدار شود (Cold Start).
عملکرد و دقت
نتایج این معماری در مقایسه با هوش مصنوعی زاینده تکاندهنده است. تطبیق برداری از طریق ضرب داخلی کسینوسی در RAM کمتر از ۱۰ میلیثانیه زمان میبرد، در حالی که مدلهای زاینده معمولاً ۲ تا ۵ ثانیه برای تولید یک پاسخ نیاز دارند.
مهمتر از آن، این سیستم توهم (Hallucination) — یعنی زمانی که مدل با اطمینان چیزی را میگوید که اصلاً وجود ندارد — را کاملاً حذف میکند. چون سیستم به جای پیشبینی توکن بعدی، دقیقاً رشتههای متنی ساخته شده توسط توسعهدهنده را بازیابی میکند، خروجی ۱۰۰٪ مستند و بر اساس پایگاه دانش ارائه شده است. برای مثال، پرسشی مانند «چگونه پیکربندیهای مسیریابی خود را محافظت کنم؟» دقیقاً مستندات مربوط به JWT و OAuth2 را برمیگرداند، بدون اینکه جزئیاتی را از خودش اختراع کند.
این رویکرد این فرض بنیادی را میشکند که «جستوجوی هوشمند» لزوماً باید به معنای «هوش مصنوعی زاینده» باشد. ثابت شد که برای اکثریت قریب به اتفاق کارهای بازیابی (Retrieval)، یک خط لوله برداری جداشده، سریعتر، ارزانتر و قابلاعتمادتر از یک مدل زبانی بزرگ است.
توسعهدهندگان اکنون میتوانند بدون نیاز به خوشههای GPU یا اشتراکهای گرانقیمت API، جستوجوی با کارایی بالا پیاده کنند. تمرکز از مهندسی پرامپت (Prompt Engineering) — هنر سؤال درست پرسیدن برای گرفتن بهترین جواب — به ایندکسگذاری بهینه بردارها تغییر میکند.
گام بعدی شما
- کد منبع را در مخزن Zero-LLM-search در گیتهاب بررسی کنید تا ساختار FastAPI و Qdrant را ببینید.
- دمو زنده را تست کنید تا سرعت بازیابی زیر میلیثانیه را تجربه کنید.
- اسناد فعلی خود را به فرمت JSON تبدیل کنید تا امکان تست بردارها فراهم شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو