تصور کنید ابزاری میسازید که در ۹۰٪ مواقع درست عمل میکند، اما وقتی دقیقاً همان درخواست را برای بار دوم میفرستید، با پاسخی متفاوت و غلط مواجه میشوید. این ناپایداری در عاملهای هوش مصنوعی (AI Agents) — سیستمهایی که مثل یک دستیار اجرایی، میتوانند برای رسیدن به هدف، ابزارهای مختلف را به ترتیب صدا بزنند — بزرگترین مانع برای استقرار آنها در محیطهای عملیاتی است.
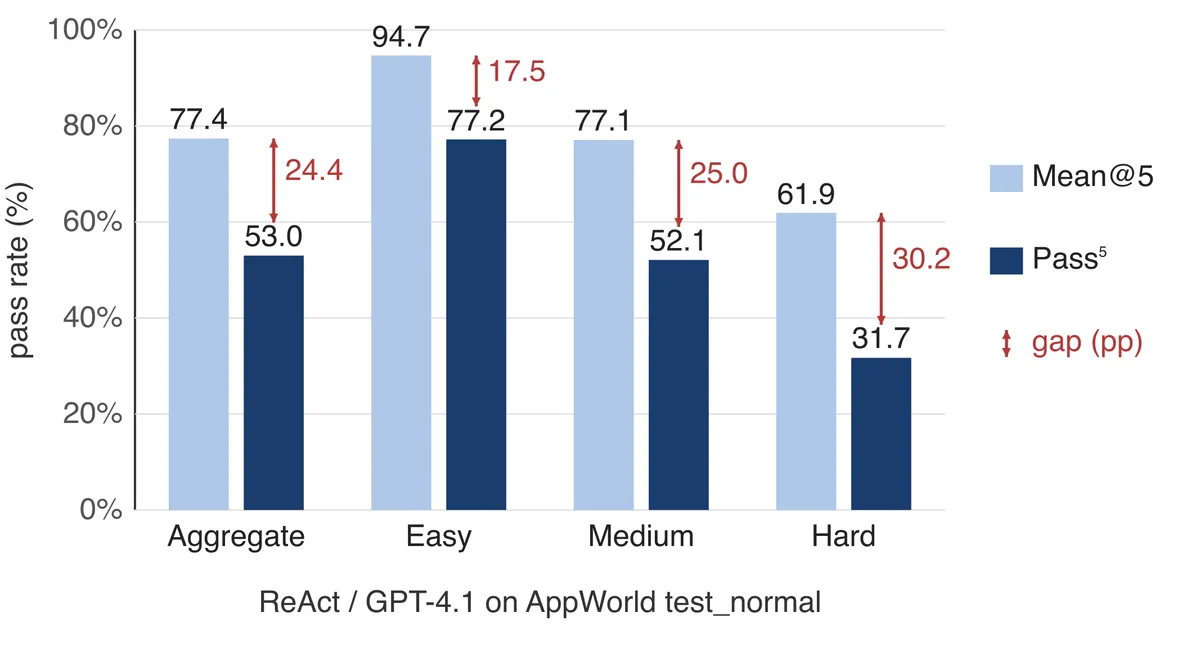
به نقل از گزارش Hugging Face، یک عامل مبتنی بر GPT-4.1 ممکن است در ۷۷.۴٪ از وظایف موفق شود، اما تنها در ۵۳٪ از همان موارد، نتایج را بهطور تکرارپذیر بازتولید کند. این شکاف ۲۴.۴ درصدی نشاندهنده یک نقص جدی در قابلیتسنجی است که بنچمارکهای استاندارد معمولاً آن را پنهان میکنند. در محیطهای عملیاتی، این یک مشکل جدی در زمینه قابلیتاعتماد است. گردش کاری که یک بار موفق میشود، ممکن است در بار دوم که کاربر همان درخواست را ارسال میکند، شکست بخورد. برای کارهای حیاتی — مانند تطبیق یک تراکنش مالی یا بررسی یک قرارداد برای یافتن یک تعهد خاص — این تغییرپذیری میتواند یک مانع غیرقابل عبور باشد. این دقیقاً تفاوت بین ابزاری است که در تمرینات موفق است و ابزاری که در یک دموی زنده شکست میخورد.
در ۱۵ سپتامبر ۲۰۲۶، Hugging Face سیستمی را برای تشخیص و رفع این ناپایداری معرفی کرد. همانطور که در تحلیلهای پیشین ما دربارهی امنیت و پایداری مدلهای زبانی اشاره کردیم، مشکل اصلی نبودِ توانایی نیست، بلکه وجود توزیعهای احتمالی «تخت» است؛ وضعیتی که مدل بین دو اقدام مختلف تقریباً برابر است و مردد میماند. در این حالت، کوچکترین تغییرات در محاسبات اعشاری واحد پردازش گرافیکی (GPU)، نحوه دستهبندی درخواستها (Batching) یا سایر اثرات سمت پلتفرم، میتواند نتیجه را حتی در دمای صفر تغییر دهد. این حساسیتها بهویژه در محیطهای ابری مشهود است، جایی که برخی باورهای غلط دربارهی نقاط اتصال رایگان مدلها میتواند درک توسعهدهندگان از پایداری خروجی را تحت تأثیر قرار دهد.
درک معیارهای سنجش
بسیاری از توسعهدهندگان از Mean@k (میانگین نرخ موفقیت در چندین اجرا) استفاده میکنند. اغلب مقدار k برابر با ۳ یا حتی ۱ است. این همان عددی است که در تمام جدولهای ردهبندی (Leaderboards) دیده میشود و وقتی میشنویم مدلی «۷۷٪ دقیق» است، منظور همین عدد است. اما Hugging Face استدلال میکند که کاربران واقعی به Pass^k اهمیت میدهند: یعنی کسری از وظایف که در آنها، عامل در «تمام» تلاشها موفق شده است. این رویکرد تأکید میکند که چرا استفاده از محکهای داخلی و سفارشیسازی شده برای جایگزینی لیدربوردهای عمومی ضروری است تا نقاط ضعف واقعی مدل در محیط عملیاتی آشکار شود.
تفاوت این معیارها حیاتی است:
- Mean@k: پاسخ میدهد «این عامل بهطور متوسط چقدر خوب است؟»
- Pass^k: پاسخ میدهد «اگر دقیقاً همین سؤال را دوباره بپرسم، باز هم جواب درست میگیرد؟»
- Pass@k: دیدگاهی خوشبینانه دارد و میپرسد «آیا حداقل یکی از k تلاش موفق بود؟» این معیار زمانی مفید است که شما بتوانید پاسخ را تأیید کرده و دوباره تلاش کنید، اما دقیقاً نقطه مقابل آن چیزی است که برای قابلیتاعتماد (Reliability) نیاز داریم.
از نظر ریاضی، Pass^k همواره کوچکتر یا مساوی Mean@k و آن هم کوچکتر یا مساوی Pass@k است. «شکاف سازگاری» به عنوان تفاضل Mean@k و Pass^k تعریف میشود. برای یک عامل ریاکت (ReAct) — سیستمی که مثل یک انسان ابتدا فکر میکند و سپس عمل میکند — که توسط GPT-4.1 پشتیبانی میشود، مقدار Mean@5 برابر ۷۷.۴٪ است، اما Pass^5 تنها ۵۳.۰٪ است. یعنی تقریباً یکچهارم بنچمارک شامل وظایفی است که عامل گاهی میتواند حل کند و گاهی نمیتواند، در حالی که هیچ چیزی در خودِ وظیفه بین اجراها تغییر نکرده است.
چرا عاملها «تغییر مسیر» میدهند؟
هر بار که یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — تصمیم میگیرد کدام API را فراخوانی کند، چه آرومانی را ارسال کند یا اینکه آیا باید دوباره تلاش کند، این تصمیم از یک توزیع احتمالی روی توکنها (Tokens) — تکههای کوچکی از متن شبیه برشهای کیک — حاصل میشود. شکل این توزیع، میزان تابآوری را تعیین میکند:
- توزیعهای تیز: اکثر احتمال روی یک توکن متمرکز است. اینها در برابر نویز مقاوم هستند و در هر اجرا همان انتخاب را تولید میکنند.
- توزیعهای تخت: احتمال بین چندین توکن که تقریباً برابر هستند پخش شده است. در اینجا برنده شبیه به پرتاب سکه است.
از آنجا که یک مسیر اجرایی (Trajectory) از زنجیرهای از دهها تصمیم تشکیل شده، احتمال کوچکِ تغییر در هر گام، بهصورت ترکیبی منجر به احتمال بزرگی میشود که یک اجرا متفاوت از اجرای قبلی پیش برود. این موضوع توضیح میدهد که چرا مشکل حتی با تنظیمات رمزگشایی (Decoding) نیز باقی میماند. رمزگشایی حریصانه (Greedy decoding) و بذرهای ثابت (Fixed seeds) تعیین میکنند که یک توزیع چگونه به یک توکن تبدیل شود، اما خودِ توزیع را تغییر نمیدهند. در نقاط انتهایی میزبانی شده (Hosted endpoints)، احتمالات بهطور جزئی تغییر میکنند، به این معنی که یک پرامپت یکسان در دمای 0.0 میتواند یک تساوی نزدیک را از یک روز به روز دیگر متفاوت حل کند.
سازوکار تحلیلگر سازگاری (Consistency Analyzer)
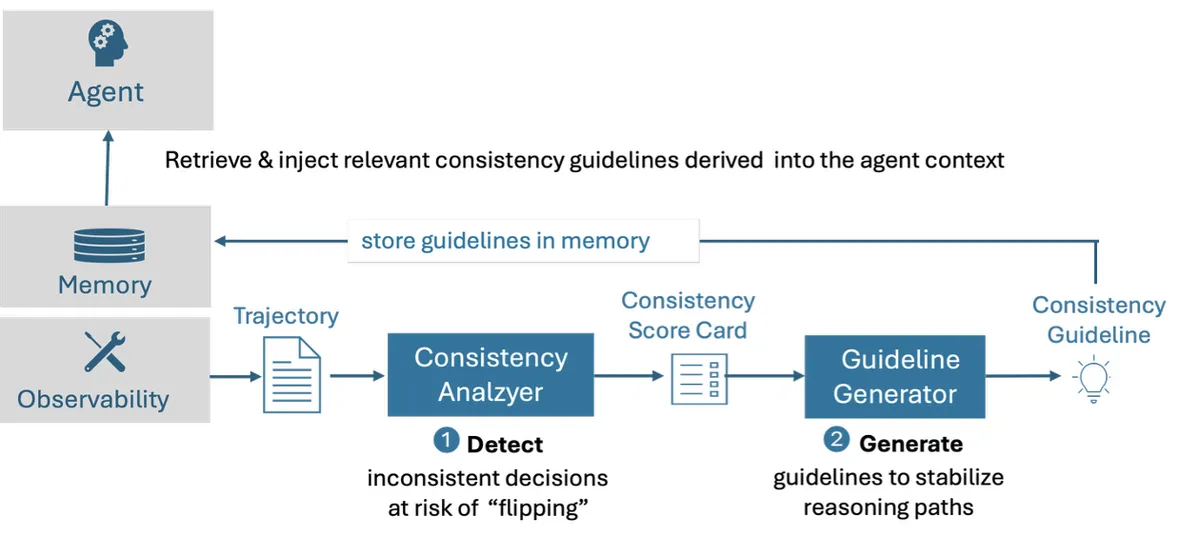
برای حل این مشکل، تیمی از محققان ابزار Consistency Analyzer را ساختند. این ابزار یک ابزار تشخیصی است که دقیقاً شناسایی میکند عامل در کجا احتمال دارد تصمیم خود را «تغییر» دهد. این ابزار برخلاف ارزیابیهای سنتی، نیازی به دادههای مرجع (Ground Truth) یا اجرای کامل و پایانبهپایان (End-to-end) دوبارهی وظیفه ندارد. این رویکرد دقیقاً برای مقابله با مشکلاتی است که در آن لاگهای توهمی در ارزیابی عملکرد AI جایگزین رسیدهای واقعی شده و تصویری نادرست از موفقیت مدل ارائه میدهند.
در عوض، تحلیلگر از یک خط لوله دو مرحلهای استفاده میکند که به سیستم ALTK-Evolve متصل میشود:
۱. تشخیص (Detection):
- فرآیند: تحلیلگر یک مسیر ثبتشده را میگیرد و هر گام تصمیمگیری را از طریق نمونهبرداری کنترلشده بازپخش میکند.
- سازوکار: ابزار برای هر گام تصمیمگیری بهصورت آفلاین، یک فراخوانی اضافی از مدل انجام میدهد. این ابزار k تکمیل (بهطور پیشفرض k=5) را در مقابل زمینهی (Context) از پیش ثبتشده درخواست میکند.
- کارایی: این سیستم هیچ فراخوانی جدیدی از ابزارها، تعامل جدیدی با محیط یا اجرای مجدد پایانبهپایان انجام نمیدهد.
- خروجی: این فرآیند یک امتیاز سازگاری برای هر گام تصمیمگیری ایجاد میکند که در یک کارت امتیاز (Scorecard) نوشته میشود تا تصمیماتی که در معرض خطر تغییر مسیر هستند، دقیقاً شناسایی شوند.
- ماهیت: این تشخیص کاملاً جعبهسیاه (Black-box) است و به هیچکدام از لوجیتها (Logits)، ساختارهای داخلی مدل یا ابزارهای اندازهگیری فراتر از ردپای (Trace) موجود نیاز ندارد.
۲. تولید (Generation):
- فرآیند: هر گام ناپایدار شناسایی شده، به یک کاندیدای «دستورالعمل سازگاری» در قالب استاندارد ALTK-Evolve تبدیل میشود.
- یکپارچهسازی: این دستورالعملها بهطور خودکار تقطیر شده و در زمان استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند — از طریق خط لوله ذخیرهسازی و بازیابی موجود به مدل تزریق میشوند.
بهعنوان مثال، در وظیفهی AppWorld با عنوان «طبق یادداشت SimpleNote من، چند فعالیت در لیست کارهایم انجام شده است؟»، تحلیلگر ممکن است این دستورالعملها را تولید کند:
- دستورالعمل ۱: «هنگام شمارش نشانگرهای سبک چکباکس در محتوای یادداشت، بهجای شمارش سادهی زیررشتهها، از تطبیق Regex متصل به خط استفاده کن؛ زیرا عناوین یادداشتها اغلب نماد نشانگر را در یک خط راهنما تکرار میکنند.»
- دستورالعمل ۲: «همیشه نتایج جستوجو برای پرسوجوهای یادداشت را با بررسی وجود تطبیقهای متعدد و تأیید یادداشت صحیح قبل از ادامه، بازبینی کن.»
اینها اطلاعات جزئی و خاص هر وظیفه نیستند. باگهای شمارش رشتهها و نتایج جستوجوی تأیید نشده، نقاط تصمیمگیری هستند که با عدم قطعیت بالا در بسیاری از وظایف ظاهر میشوند. تحلیلگر، ناپایداری را هدف قرار میدهد، نه شکست را؛ یعنی گامهایی را میگیرد که عامل این بار درست انجام داده اما دفعه بعد بهراحتی میتواند اشتباه کند.
تحلیل عددی بهبود قابلیتسنجی
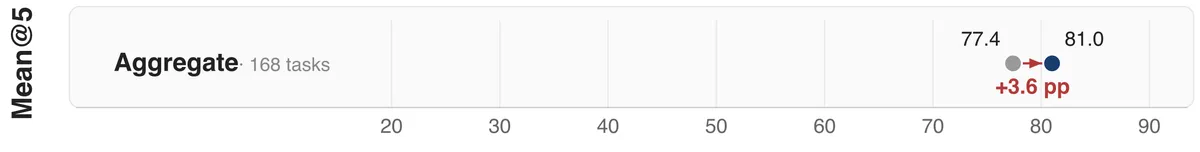
آزمایش روی مجموعه داده test_normal در AppWorld (شامل ۱۶۸ وظیفه) با یک عامل ReAct روی GPT-4.1 نشان داد که این دستورالعملها بهطور قابلتوجهی عملکرد را پایدار میکنند. نرخ کلی Pass^5 از ۵۳.۰٪ به ۶۹.۰٪ افزایش یافت، در حالی که Mean@5 از ۷۷.۴٪ به ۸۱.۰٪ رسید.
این تغییر باعث شد شکاف سازگاری از ۲۴.۴ درصد به ۱۲.۰ درصد کاهش یابد. تقریباً یکسوم از وظایفی که قبلاً ناسازگار بودند، به وظایفی تبدیل شدند که عامل در هر بار اجرا آنها را با موفقیت میگذراند. نکته کلیدی این است که این بهبود بدون قربانی کردن دقت میانگین رخ داد و این شرط سختگیرانه را برآورده کرد که سیستم نباید صرفاً ناپایداری را از یک وظیفه به وظیفه دیگر منتقل کند.
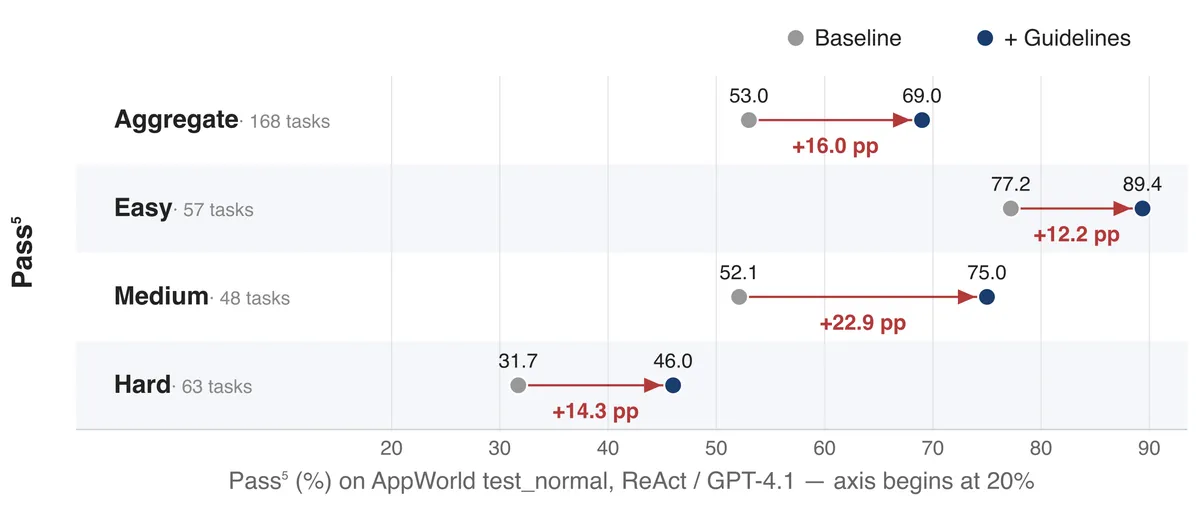
بیشترین دستاوردها در وظایف دشوارتر دیده شد، جایی که شکاف سازگاری اغلب به ۳۰ نقطه میرسد:
- وظایف سطح متوسط: نرخ Pass^5 به میزان ۲۲.۹ درصد (۴۴٪ افزایش نسبی) رشد کرد.
- وظایف سطح سخت: نرخ Pass^5 به میزان ۱۴.۳ درصد (۴۵٪ افزایش نسبی) رشد کرد.
- وظایف سطح آسان: نرخ Pass^5 به میزان ۱۲.۲ درصد افزایش یافت.
این نتایج نشان میدهد که هرچه زنجیره استدلال پیچیدهتر باشد، عامل بیشتر از تثبیت نقاط تصمیمگیری بهره میبرد. دقت میانگین در تمام سطوح دشواری ثابت ماند یا بهبود یافت.
تعمیمپذیری در مدلهای مختلف
ثابت شد که این دستورالعملها بهجای اینکه صرفاً وصلههای حفظشده باشند، قابل بازاستفاده هستند. وقتی این دستورالعملها روی یک وظیفه متفاوت اما مرتبط در همان سناریوی AppWorld اعمال شدند، باز هم نرخ Pass^5 را ۱۳.۰ درصد افزایش دادند (که تنها ۳ نقطه کمتر از عدد مربوط به همان وظیفه بود).
این اثر در یک مدل ضعیفتر مانند gpt-oss-120b حتی مشهودتر بود. در آن مورد:
- Pass^5 در همان وظیفه: از ۱۰.۱٪ به ۱۶.۱٪ رسید (۶.۰+ درصد).
- Pass^5 در وظایف مشابه: ۸.۷+ درصد افزایش یافت.
از آنجا که بهبود در وظایف مشابه بیشتر از بهبود در همان وظیفه بود، این موضوع نشان میدهد که دستورالعملها الگوهای شکست واقعاً قابل تعمیم را ثبت کردهاند، نه اینکه جزئیات یک مسیر خاص را حفظ کنند.
تغییر پارادایم بنچمارکهای عاملمحور
این پژوهش اتکای صنعت به «دقت میانگین» را به چالش میکشد. یک مدل قویتر ممکن است امتیاز Mean@k را بالا ببرد، اما لزوماً شکاف سازگاری را کاهش نمیدهد. توانایی (Capability) و سازگاری (Consistency) دو محور عمود بر هم هستند؛ یک عامل میتواند بسیار توانمند باشد اما کاملاً غیرقابلاعتماد باشد.
برای کسانی که عاملها را به محیط تولید میرسانند، توصیهها روشن است:
- گزارش Pass^k در کنار Mean@k: میانگینها نمیتوانند تفاوت بین یک عامل قابلاعتماد و یک عامل خوششانس را تشخیص دهند. حتی k=3 هم میتواند شکافها را آشکار کند.
- انتظار شکاف بیشتر در وظایف سخت: دشوارترین سطح جایی است که یک عدد میانگین بهتنهایی بیشترین گمراهی را ایجاد میکند.
- پرهیز از واکنش «مدل بزرگتر»: مدل قویتر Mean@k را بالا میبرد، اما لزوماً شکاف سازگاری را پر نمیکند.
- بهرهگیری از تشخیص جعبهسیاه: چون تحلیلگر نیازی به ارزیاب، داده مرجع یا بازپخش زنده ندارد، روی ترافیک واقعی تولید (Production) که در آن بازپخشهای پایانبهپایان اغلب غیرممکن است، قابل استفاده است.
توسعهدهندگان با استفاده از یک فراخوانی اضافی LLM برای هر گام تصمیمگیری (نمونهبرداری k=5)، میتوانند بهینهسازی عاملها را از «مهندسی پرامپت» به یک فرآیند تشخیصی سیستماتیک تغییر دهند.
برای پیادهسازی این یافتهها، توسعهدهندگان میتوانند به مخزن متنباز ALTK-Evolve دسترسی پیدا کنند که اکنون شامل تحلیلگر سازگاری و ابزارهای تولید دستورالعمل است، یا گزارش فنی کامل را در arXiv مطالعه کنند.
گام بعدی شما
- اگر از عاملهای هوش مصنوعی در محیط تولید استفاده میکنید، نرخ Pass@3 را برای درخواستهای تکراری اندازه بگیرید تا میزان ناپایداری سیستم خود را بسنجید.
- بهجای افزایش اندازه مدل برای رفع خطاهای تصادفی، روی شناسایی نقاط تصمیمگیری با توزیع احتمالی تخت تمرکز کنید.
- مخزن ALTK-Evolve را برای پیادهسازی خودکار دستورالعملهای سازگاری در خط لوله استنتاج بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو