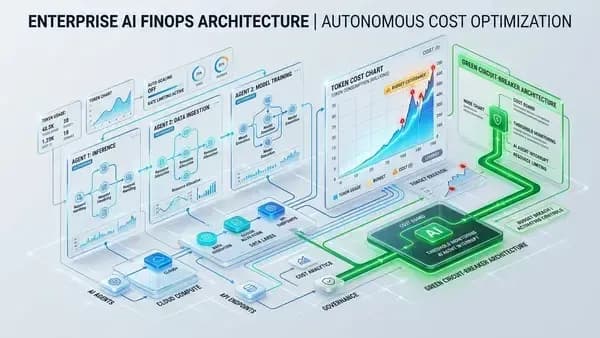
تصور کنید یک تیم مهندسی، خط لولهی تطبیق خودکار حسابها را از محیط آزمایش به تولید منتقل میکند و ناگهان صورتحساب ابری از ۱۸۰ دلار به ۱,۳۰۰ دلار در ماه میرسد. در محیطهای دمو، هر گام مدل زبانی بیش از ۹۰٪ نرخ موفقیت داشت، اما پس از سه هفته در محیط واقعی، بیش از ۸۰٪ اجراهای چندمرحلهای با خطا متوقف شدند یا خطاهای مدیریتنشده صادر کردند.
طبق دادههای صنعتی، تقریباً ۸۸٪ از پروژههای عامل (Agent) — شبیه دستیاری که میتواند بهطور مستقل برنامهریزی کند و ابزارها را اجرا کند — در مسیر رسیدن به تولید پایدار شکست میخورند یا متوقف میشوند.
ریاضیات شکست متوالی
این نرخ شکست از یک قانون بیرحم در ریاضیات متوالی نشأت میگیرد. اگر یک گام مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — نرخ موفقیت ۹۰٪ داشته باشد، یک حلقهی متوالی پنجگانه، قابلیت اطمینان کل سیستم را به ۵۹٪ کاهش میدهد (P(Success) = 0.90^5 ≈ 59.0%). به نقل از گزارشهای فنی، وقتی واقعیتهای محیط تولید اضافه میشوند، این عدد سقوط میکند:
- افت سینتکس در طرحوارههای JSON
- زمانبندی خارج (Timeout) در اتصال به APIهای بالادستی
- توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که اصلاً وجود ندارد — در پارامترهای طرحواره
حتی با دقت خوشبینانهی ۸۲٪ در هر گام، نرخ تکمیل یک وظیفهی ۵ مرحلهای به حدود ۳۶٪ میرسد. وقتی یک عامل برای جبران یک خطای کوچک در اعتبارسنجی، وارد حلقهی تکرارهای کنترلنشده میشود، فقط شکست نمیخورد، بلکه هزینهبرترین حالت شکست را تجربه میکند. این چالشها بهویژه در محیطهای برنامهنویسی مشهود است، جایی که نقص در مدیریت اجرا باعث شد نرخ موفقیت عاملهای کدنویس در LoopArena به شدت کاهش یابد.
همانطور که در تحلیل قبلی ما دربارهی شکست باتهای چندزبانه بدون مسیریابی درست اشاره کردیم، چالش اصلی در اینجا هوش مدل نیست، بلکه معماری سیستم است. بیشتر تیمها هزینهی عاملها را خطی میبینند و از یک فرمول ساده استفاده میکنند: هزینه تخمینی = (میانگین توکنها) × (تعداد کل اجراها) × (قیمت هر توکن). اما در واقعیت، این هزینهها درجهدوم (Quadratic) هستند.
تجمع درجهدوم زمینه (Context Compounding)
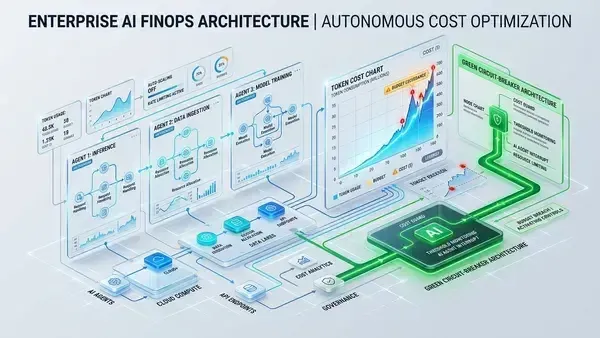
هر چرخش در یک حلقه، تمام تاریخچه چرخشهای قبلی را به ارث میبرد؛ از جمله دادههای حجیم ابزارها و ردپای زنجیره تفکر (Chain-of-Thought) — مثل وقتی شاگرد ریاضی پای تخته بلند بلند فکر میکند تا به جواب برسد. برای مثال، یک حلقهی ۴ مرحلهای بدون هرس کردن، بهسرعت متورم میشود:
- چرخش ۱ (هدف و برنامه): حدود ۶,۴۰۰ توکن ورودی.
- چرخش ۲ (اجرای ابزار ۱): تزریق دادههای خام پایگاهداده؛ حجم به ۱۴,۵۰۰ توکن میرسد.
- چرخش ۳ (ارزیابی و تکرار): تزریق ردپای خطا؛ حجم به ۲۸,۰۰۰ توکن میرسد.
- چرخش ۴ (سنتز نهایی): پردازش مجدد کل تاریخچه؛ توکنهای صورتحساب به بیش از ۶۰,۰۰۰ میرسد.
وظیفهای که باید ۰.۰۰۲ دلار هزینه داشته باشد، بهسرعت به ۰.۳۵ تا ۰.۴۰ دلار یا بیشتر برای هر تسک پذیرفتهشده تبدیل میشود. این «تجمع زمینه» عامل اصلی تخطی از بودجه است.
برای بقا، ۱۲٪ تیمهای موفق، حلقههای مدل زبانی را مانند ماشینهای وضعیت توزیعشده و شکننده میبینند و چهار حفاظ (Guardrails) قطعی را پیاده میکنند:
۱. هرس سلسلهمراتبی زمینه
تیمها از بازگرداندن خروجیهای خام ابزار به پرامپت اصلی پرهیز میکنند. در عوض، اجرای ابزار را با یک تجزیهکننده محلی میپوشانند که فرمتها را حذف کرده، طول آرایهها را به آنچه صراحتاً درخواست شده محدود میکند و دادههای JSON حجیم را به نقشههای کلید-مقدار فشرده تبدیل میکند.
۲. مدارشکنهای معنایی
برای جلوگیری از «حلقههای مرگ» — جایی که عامل مدام جزئیات کوچکی مثل CSS یا هدرهای مارکداون را تغییر میدهد — مهندسان سقف سخت برای تعداد چرخشها میگذارند. اگر عامل در سه چرخش متوالی نتواند وضعیت ماشین حالت خود را پیش ببرد، سیستم حلقه را بهاجبار متوقف کرده و یک snapshot از وضعیت را به یک مهندس انسان تحویل میدهد.
۳. مسیریابی مدلهای لایهای
مدلهای استدلالی (Reasoning Model) — مدلی که قبل از جواب، یک قدم درنگ میکند و فکر میکند — مانند o1 یا Sonnet 3.7 فقط برای برنامهریزی سطح بالای DAG و تطبیق نهایی ناهنجاریها رزرو میشوند. مدلهای کوچک و سریع مثل Claude 3.5 Haiku، GPT-4o-mini یا نمونههای محلی Ollama وظایف فراخوانی ابزار، نگاشت طرحواره و تجزیه CSV را بر عهده میگیرند. در این ساختار، هرگونه نقص در لایه هماهنگکننده میتواند کل سیستم را مختل کند، موضوعی که در تحلیل ما دربارهی شکست سامانههای چندعاملی در محیط عملیاتی به تفصیل بررسی شده است.
۴. حافظه پنهان پرامپت استاتیک (Byte-Static)
حافظه پنهان (Prompt Caching) مدرن میتواند تا ۸۰٪ هزینههای ورودی را کاهش دهد، اما فقط در صورتی که پیشوند پرامپت دقیقاً بایتبهبایت یکسان باشد. تیمهای موفق، برچسبهای زمانی پویا، شناسههای کاربر یا تاریخچه گفتگوهای هرسنشده را از ابتدای پرامپت حذف میکنند تا حافظه پنهان در هر چرخش باطل نشود.
این چرخش نشان میدهد که ساخت عاملهای آماده برای تولید، بیشتر تمرینی در مهندسی دفاعی سیستمهاست تا مهندسی پرامپت (Prompt Engineering) — هنر سؤال درست پرسیدن. تمرکز از مدلهای «باهوشتر» به سمت سیستمهای پیشبینیپذیری میرود که پایداری را بر خودمختاری اولویت میدهند.
برای توسعهدهندگان، معیار موفقیت دیگر نمره بنچمارک مدل نیست، بلکه «هزینه به ازای هر تسک پذیرفتهشده» است. بدون این سقفها، ریاضیات توکنهای تجمعی بهناچار از هر بودجه ابری پیشی میگیرد.
برای بهینهسازی بیشتر این جریانهای کاری، مهندسان باید الگوهای ردیابی OpenTelemetry را بررسی کنند تا دقیقاً شناسایی کنند حلقهها در کجا متوقف میشوند. مرز بحرانی بعدی، توسعه ماشینحسابهای تعاملی تجمع توکن است تا هزینهها پیش از استقرار پیشبینی شوند.
گام بعدی شما
- از الگوهای ردیابی OpenTelemetry برای شناسایی دقیق نقاط توقف حلقهها استفاده کنید.
- مدلهای لایهای را پیاده کنید تا مدلهای گرانقیمت فقط در گامهای تصمیمگیرنده حضور داشته باشند.
- برای پیشبینی هزینهها پیش از استقرار، از ماشینحسابهای تجمعی توکن استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو