تصور کنید یک سرور محلی یا مکبوک را دارید که بدون نیاز به اینترنت و با دقت میلیثانیهای، هزاران تیکت پشتیبانی را طبقهبندی میکند. این همان قابلیتی است که Kev، خانوادهای از مدلهای زبانی کوچک (SLM) — شبیه به دستیاران متخصصی که بهجای نوشتن مقاله، فقط فرمهای اداری را با دقت پر میکنند — فراهم میکند. این سیستم در واقع یک موتور تصمیمگیر است که منطق تصمیمگیری با دقت بالا را از طریق مدلهای کوچک اجرا میکند.
به نقل از مستندات منتشر شده در ۲۱ سپتامبر ۲۰۲۶، جرد پالمر (Jared Palmer) این مدلها را بر پایه معماری Qwen3.5 عرضه کرده است. این مدلها بر اساس معماری توصیف شده در مقاله Jev's Architecture Unmasked ساخته شدهاند. برخلاف مدلهای زبانی بزرگ (LLM) که متن آزاد تولید میکنند، Kev بهطور خاص برای تصمیمگیریهای ساختاریافته مهندسی شده است و احتمالات دقیقی را برای سؤالات «بله/خیر»، چندگزینهای و رتبهبندی ارائه میدهد. این رویکرد در راستای بررسیهای گستردهتر روی ساختارهای مدلهای زبانی است، مشابه آنچه در مجموعه ۷۲ معماری مدرن LLM در مخزن OpenArch برای درک بهتر پیادهسازیهای مختلف مشاهده میشود.
بسیاری از سیستمهای مسیریابی AI امروز بر پرامپتهای پیچیده در مدلهای غولپیکر تکیه دارند که اغلب دچار «سوگیری برچسب» (Label Bias) یا فرمتهای نامنظم میشوند. همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی استنتاج در لبه اشاره کردیم، نیاز به موتورهای تصمیمگیر سریع و قطعی (Deterministic) در حال افزایش است. Kev به عنوان یک جایگزین کاربردی برای مهندسانی عرضه شده که به یک موتور تصمیمگیر در سبک «سیستم یک» (System One) نیاز دارند؛ سیستمی که سریع باشد، نتایج قطعی بدهد و روی سختافزار خصوصی قابل میزبانی باشد. Kev با استفاده از یک لایه سازگارساز یا آداپتور لورا (LoRA) و یک «سر اشارهگر» (Pointer Head)، مدل پایه را به یک طبقهبند تبدیل میکند که فقط حدس نمیزند، بلکه میزان عدم قطعیت خود را نیز کمی میکند.
خانواده مدلها و عملکرد
مدل Kev در سه اندازه عرضه شده است که همگی بر پایه مدلهای پایه Qwen3.5 ساخته شدهاند. انتخاب مدل بسته به توازن میان محدودیتهای حافظه و نیاز به کالیبراسیون است:
- Kev-0.8B: کوچکترین گزینه، طراحی شده برای حداکثر سرعت و کمترین اشغال حافظه. این مدل از Qwen3.5-0.8B-Base استفاده میکند.
- Kev-4B: مدل میانرده و متوازن، مناسب برای اکثر وظایف مسیریابی در محیط عملیاتی. این مدل از Qwen3.5-4B-Base استفاده میکند.
- Kev-9B: نسخه با دقت بالا، برای زمانی که کالیبراسیون و دقت حیاتیتر از میزان مصرف حافظه است. این مدل از Qwen3.5-9B-Base استفاده میکند.
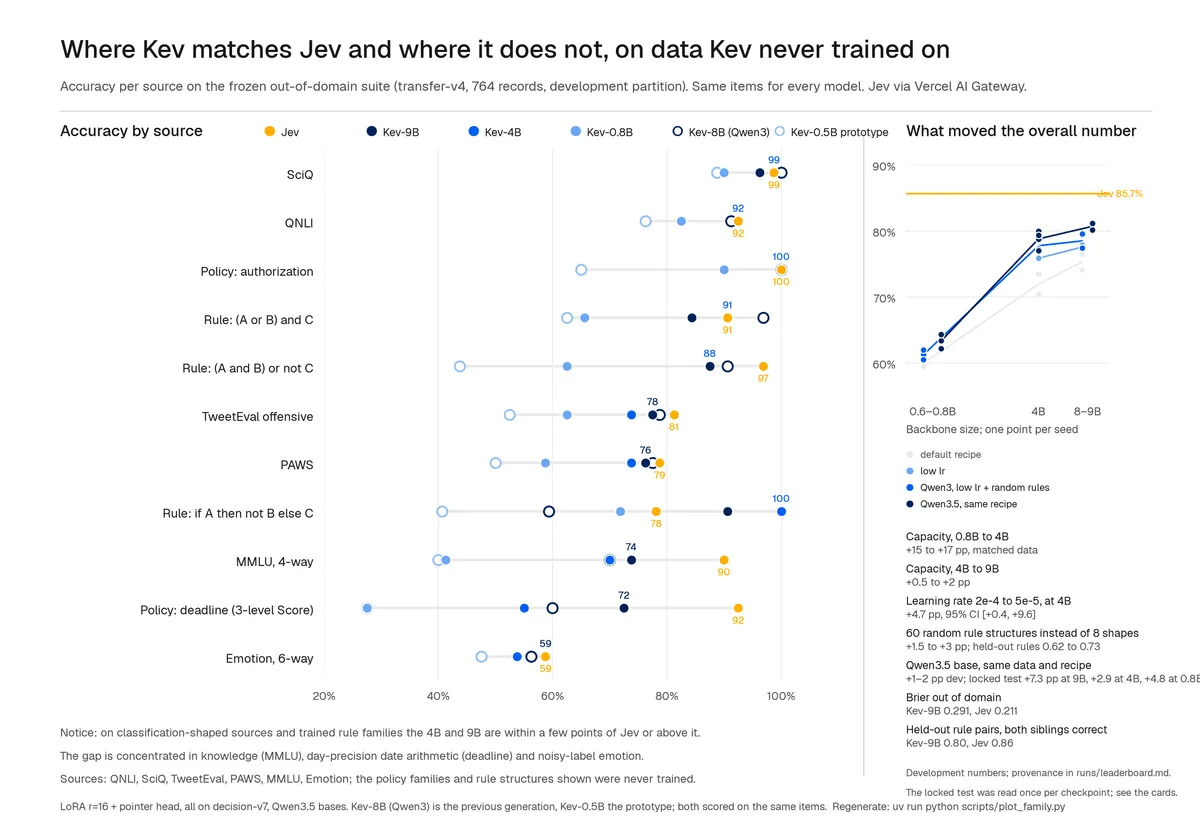
طبق گزارشهای فنی در گیتهاب، مدلهای 4B و 9B بهراحتی روی مکهای ۳۲ گیگابایتی با دقت bf16 اجرا میشوند. در آزمونهای رودررو، مدل Kev-9B تنها حدود ۴.۵ امتیاز با مدل تجاری و بسته Jev در مجموعههای توسعه منبع-جدید (new-source development sets) فاصله دارد، هرچند همچنان برای جایگزینهای وزن-باز بسیار رقابتی است. این دستاورد در زمینه اجرای مدلهای بهینه روی سختافزار اپل، یادآور پروژه Deltafin است که توانست مدل عظیم Kimi K3 را روی لپتاپهای مک اجرا کند، هرچند Kev بر روی سرعت و تخصص متمرکز است.
دادههای دقیق صحت، پیشرفت را در سراسر این خانواده نشان میدهد. در منابع آموزشدیده (نمونههای کنار گذاشته شده)، هر دو مدل Kev-4B و Kev-9B به دقت بالایی میرسند (به ترتیب ۰.۸۷۷ و ۰.۸۷۶ در مرحله توسعه). اما هنگام مواجهه با «منابع جدید» — یعنی مجموعهدادهها و انواع قوانین پالیسی که مدل روی آنها آموزش ندیده است — دقت Kev-9B به ۰.۸۱۲ میرسد، در حالی که مدل 0.8B به ۰.۶۴۳ سقوط میکند. امتیاز Brier (که در آن عدد کمتر نشاندهنده دقت بیشتر است) نیز برتری نسخه 9B را برجسته میکند: Kev-9B امتیاز ۰.۲۹۱ را کسب میکند در حالی که Kev-0.8B در منابع جدید امتیاز ۰.۵۱۳ را دارد.
معماری فنی: فراتر از پرامپتنویسی
Kev از تولید متن استاندارد استفاده نمیکند. در عوض، از یک آداپتور LoRA با رتبه ۱۶ و یک سر اشارهگر کوچک بهره میبرد. این معماری اجازه میدهد مدل یک «وضعیت» (متن ورودی) را یکبار پردازش کند و سپس به چندین سؤال مستقل پاسخ دهد، بدون اینکه سؤالات با یکدیگر تداخل داشته باشند یا بر هم اثر بگذارند.
در مدلهای Qwen3.5 که از لایههای Gated DeltaNet استفاده میکنند، سرور وضعیت را یکبار محاسبه کرده و حافظه (Cache) را برای هر ردیف سؤال بازاستفاده میکند. این امر جداسازی دقیق بین پرسوجوهای مختلف در یک درخواست واحد را تضمین میکند. سپس سر اشارهگر، وضعیت پنهان (hidden state) هر گزینه را در برابر وضعیت تصمیم سؤال میسنجد و این مقادیر را به یک توزیع احتمالی سافتمکس (Softmax) تبدیل میکند.
مکانیزم انواع تصمیمات
این سیستم سه نوع پرسش متمایز را در یک درخواست پشتیبانی میکند که هر کدام مکانیزم خروجی خاص خود را دارند:
- Noul (بله/خیر): احتمال وقوع گزینه «بله» را برمیگرداند.
- Choice (چندگزینهای): محتملترین گزینه، یک امتیاز اطمینان (Confidence Score) و توزیع احتمالی کامل برای تمام گزینهها را ارائه میدهد. برای سؤالات Choice با تعداد گزینههای K > 1، اطمینان به صورت
(p_max − 1/K) / (1 − 1/K)محاسبه میشود. اگر تنها یک گزینه وجود داشته باشد، اطمینان همیشه ۱ است. - Score (رتبهبندی): یک شاخص سطح میانگین (که از ۰ شروع میشود)، یک راهنما (Legend) و احتمالات را برمیگرداند. معیار اطمینان در اینجا اندازهگیری میکند که توزیع چقدر به محتملترین سطح نزدیک است، که در واقع تقریبی از فرمول غیرعمومی TypeSafe است.
در مدلهای پایه که فقط مبتنی بر Attention هستند (مانند نسل قبلی Qwen3)، وضعیت و سؤالات در یک توالی توکن واحد با استفاده از یک ماسک (Mask) خاص پردازش میشوند. این ماسک توجه اجازه میدهد یک توکن بتواند وضعیت و سؤال خودش را بخواند، اما مانع از خواندن سؤالات دیگر یا توکنهای آینده میشود. شناسههای موقعیت (Position IDs) دقیقاً بعد از وضعیت برای هر سؤال دوباره شروع میشوند تا اطمینان حاصل شود که مدل وضعیت را یکبار پردازش کرده اما به هر سؤال بهطور مستقل پاسخ میدهد.
پیادهسازی عملی و ابزارها
برای توسعهدهندگان، Kev جایگزینی مستقیم (Drop-in replacement) برای API سیستم یک (System One) شرکت TypeSafe است. این یعنی SDKهای پایتون موجود با کمترین تغییر در کد، میتوانند به سرور محلی Kev متصل شوند.
برای راهاندازی محیط، پایتون ۳.۱۲ به بالا و مدیریت بسته uv مورد نیاز است. یک استقرار معمولی شامل کلون کردن مخزن و اجرای سرور با یک مدل خاص، مانند jaredpalmer/kev-4b است:KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
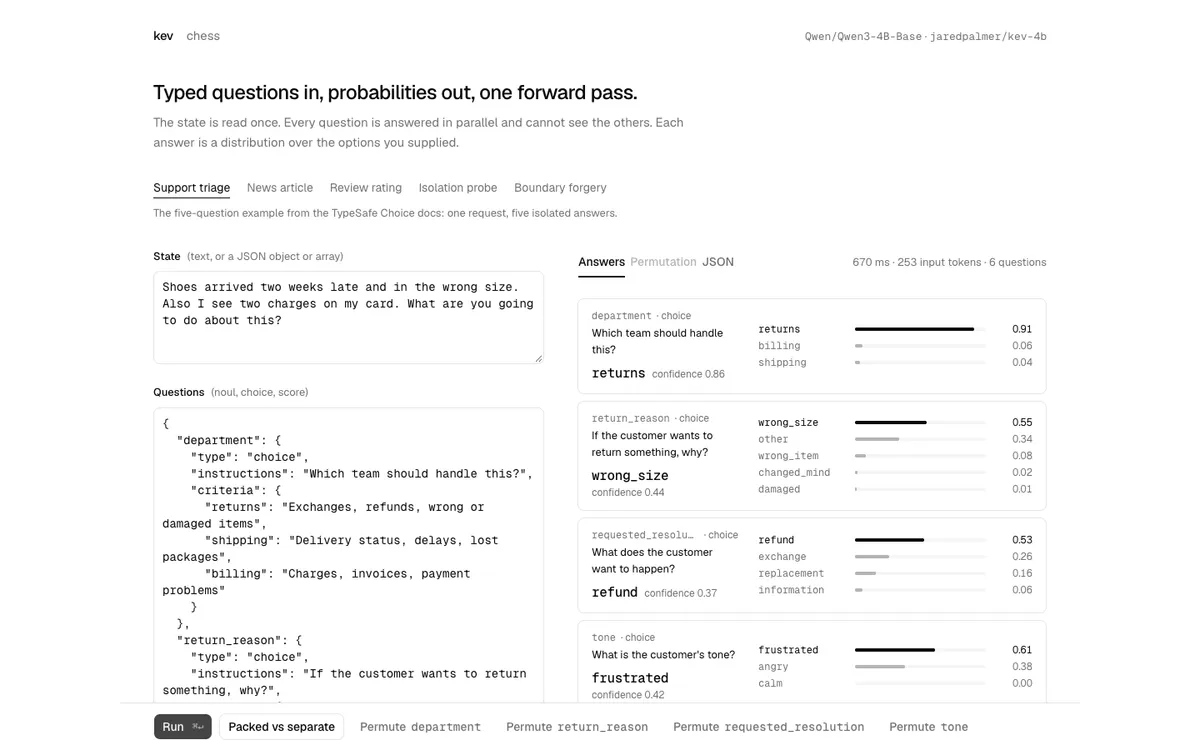
زمانی که سرور فعال شد، مدل میتواند تیکتهای پیچیده را مدیریت کند. برای مثال، درخواستی حاوی شکایت مشتری درباره تأخیر در ارسال کفش و شارژ مضاعف حساب را میتوان به نقطه اتصال /v1/systemone ارسال کرد. Kev میتواند بهطور همزمان دپارتمان درست (مرجوعی، ارسال یا صورتحساب) را تعیین کند، تصمیم بگیرد که آیا تیکت نیاز به ارجاع فوری به انسان دارد (Noul) و سطح عصبانیت مشتری را امتیازدهی کند (Score).
بنچمارکهای سختافزاری و اجرای محلی
عملکرد مدل بسته به سختافزار بهطور قابل توجهی متفاوت است. روی یک GPU H100، پاسخ به یک درخواست شامل پنج سؤال تنها چند ده میلیثانیه زمان میبرد. اما کاربران اپل سیلیکون با واقعیت متفاوتی روبرو هستند، زیرا در حال حاضر هیچ کرنل سریعی برای لایههای DeltaNet وجود ندارد و این امر PyTorch را مجبور میکند از کد مرجع (Reference Code) استفاده کند.
در تراشه M5 اپل با دقت bf16، زمان میانه مدل برای پنج سؤال (با سه گزینه برای هر کدام روی یک وضعیت حدوداً ۲۳۰ توکنی) عبارت است از:
- Kev-0.8B: ۳۲۹ میلیثانیه
- Kev-4B: ۷۷۹ میلیثانیه
- Kev-9B: حدود ۲ ثانیه
جرد پالمر برای کسانی که به تأخیر کمتر روی مک نیاز دارند، پیشنهاد میکند از نسل قبلی مدلهای Kev مبتنی بر Qwen3 (مانند jaredpalmer/kev-4b@qwen3) استفاده کنند که Attention-only هستند و بهطور قابل توجهی سریعترند. برای مثال، Kev-4B (Qwen3) همان درخواست را در ۱۷۴ میلیثانیه پاسخ میدهد در حالی که نسخه Qwen3.5 به ۷۷۹ میلیثانیه زمان نیاز دارد. مدل Kev-0.6B (Qwen3) حتی سریعتر است (۱۲۳ میلیثانیه) و Kev-8B (Qwen3) حدود ۳۰۰ میلیثانیه زمان میبرد.
برای بهینهسازی بیشتر عملکرد مک، سرور وزنهای LoRA را در fp32 ادغام میکند، از SDPA attention روی GPUهای اپل استفاده میکند و پیشوند وضعیت (State Prefix) را برای درخواستهای تکراری کش میکند. با یک وضعیت تکراری ۷۷۲ توکنی، تأخیر Kev-4B (Qwen3) از ۸۶۱ میلیثانیه به ۲۴۲ میلیثانیه کاهش مییابد. کاربران میتوانند این بهینهسازیها را با پرچمهایی مانند KEV_MERGE=0 یا KEV_PREFIX_CACHE=0 غیرفعال کنند.
شخصیسازی از طریق تنظیم دقیق
یکی از قدرتمندترین جنبههای Kev، قابلیت تنظیم دقیق (Fine-tuning) روی دادههای خاص هر دامنه است. اگر شرکتی دستهبندیهای مسیریابی یا قوانین ارجاع منحصربهفردی دارد، یک تنظیم دقیق کوتاه روی چند صد نمونه برچسبگذاری شده بسیار مؤثرتر از مهندسی پرامپت است.
آموزش با استفاده از آنتروپی متقاطع (Cross-entropy) روی پاسخ درست انجام میشود. مدلهای منتشر شده روی مجموعه decision-v7 آموزش دیدهاند که شامل ۱۰,۰۰۰ نمونه از ده مجموعه داده عمومی، ۸۹۶ نمونه پالیسی تولید شده و ۱,۶۸۰ نمونه از ۶۰ ساختار قانون تولید شده است. نرخ یادگیری بسته به اندازه مدل متفاوت است: 1e-4 برای 0.8B و 5e-5 برای 4B/9B. برای مدلهای پایه Qwen3.5، آداپتور همچنین روی پروژکشنهای DeltaNet پوشش داده میشود.
پالمر بر اهمیت استفاده از پرچم --init_from در هنگام آموزش تأکید میکند. شروع از یک نقطه بازرسی (Checkpoint) منتشر شده از Kev به مدل اجازه میدهد تواناییهای کلی تصمیمگیری خود را حفظ کند و در عین حال دانش دامنه جدید را بیاموزد. در یک تست شامل ۸۳۶ تصمیم ابزار پشتیبانی، تنظیم دقیق از روی یک مدل منتشر شده به صحت ۰.۸۸ در یک دامنه جدید رسید، در حالی که شروع از مدل پایه تنها به ۰.۳۳ در مجموعه ارزیابی اصلی دست یافت.
برای تنظیم دقیق سفارشی، کاربران میتوانند یک فایل JSONL ارائه دهند که در آن هر خط یک درخواست است و یک label به هر سؤال اضافه شده است. برای سؤالات Choice، برچسب نام گزینه است؛ برای Noul، یک مقدار Boolean است؛ و برای Score، شاخص سطح است که از ۰ شروع میشود. نرخ یادگیری پیشنهادی برای شروع این فرآیند 2e-5 است.
تستها و موارد خاص
Kev یک محیط Playground وب (اجرا شده روی Node 20.9+) برای تست اثر ترتیب گزینهها بر پاسخها و بررسی جداسازی سؤالات فراهم کرده است. این محیط دارای چندین پیشتنظیم تخصصی است:
- Packed vs Separate: مقایسه پرسیدن تمام سؤالات بهطور همزمان در مقابل پرسیدن تکتک آنها.
- Permute: اجرای یک سؤال Choice با شش ترتیب مختلف از گزینهها برای تست سوگیری.
- Isolation: تست اینکه آیا سؤالات میتوانند یکدیگر را «بخوانند» یا خیر.
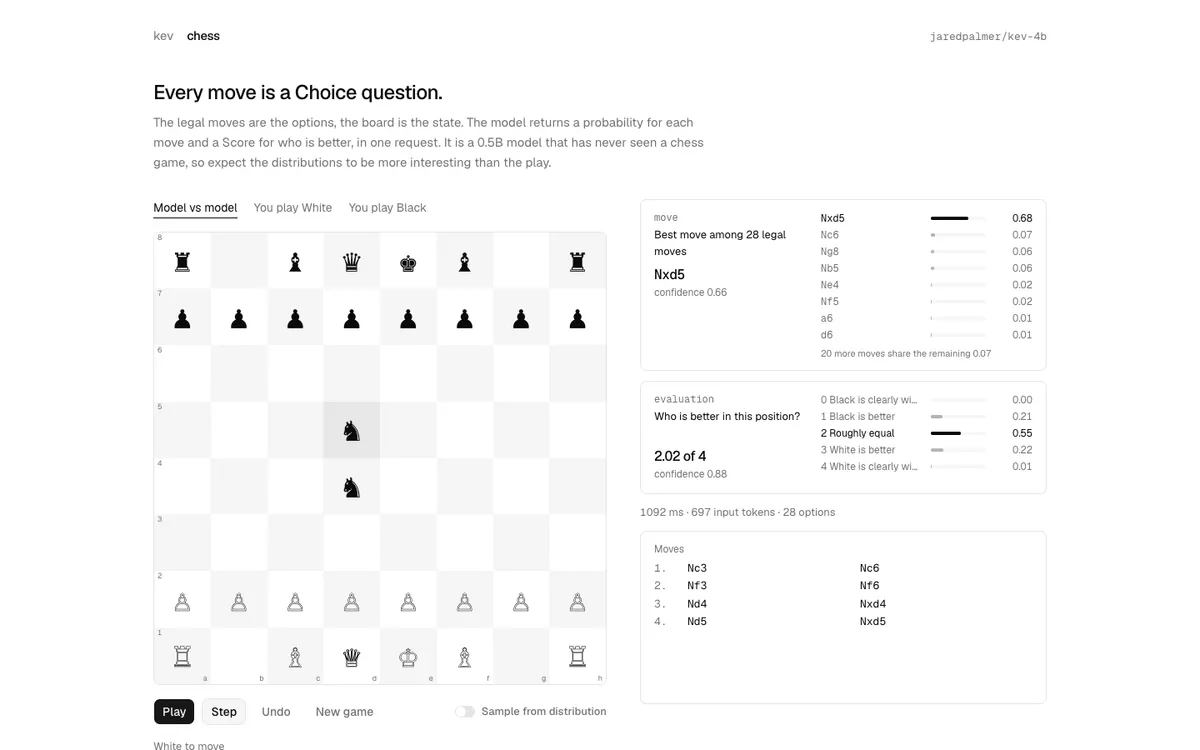
- Chess Demo: صفحه شطرنج ورودی است، حرکات قانونی گزینههای Choice هستند و یک سؤال Score وضعیت را رتبهبندی میکند. بازیها در localStorage ذخیره میشوند.
با این حال، سیستم محدودیتهای مستندی دارد. احتمالات در منابع جدید کاملاً کالیبره نیستند؛ برای مثال، Kev-4B در ۸.۲٪ موارد به یک پاسخ اشتباه، احتمال بالای ۰.۹ اختصاص میدهد (در Kev-9B این عدد ۷.۵٪ است). علاوه بر این، آموزش میتواند باعث «فرسایش مهارت» (Skill Erosion) در مدل پایه شود. محاسبات تاریخ یک مثال واضح است: مدل پایه Qwen3.5-9B آموزشندیده در سؤالات پالیسی ضربالاجل امتیاز ۰.۸۲ میگیرد، اما Kev-9B به ۰.۷۲ سقوط میکند.
سایر محدودیتها شامل سقف ۳۸۴ توکن برای وضعیت (State) و ۱,۰۲۴ توکن کل برای وضعیت بهعلاوه یک سؤال در هنگام آموزش است، هرچند در زمان سرویسدهی تا ۸,۱۹۲ توکن مجاز است. همچنین سرور در هر لحظه تنها یک درخواست را مدیریت میکند و فاقد احراز هویت داخلی است. در سؤالات دانشمحور نیز شکافی دیده میشود؛ امتیاز MMLU برای Kev برابر ۰.۷۴ است در حالی که برای Jev این عدد ۰.۹۰ است.
ارزیابی و محکها
ارزیابی با استفاده از دادههای منجمد در پوشه evals/ انجام میشود و چکسامها در مانیفستها ثبت شدهاند. بنچمارکها معیارهایی چون صحت (Accuracy)، امتیاز Brier، خطای کالیبراسیون و سهم تصمیماتی که میتوانند با بودجه خطای ۵٪ اتوماتیک شوند را گزارش میکنند.
معیارهای کلیدی ارزیابی:
- Transfer-v4: برای تستهای خارج از دامنه (Out-of-domain).
- Transfer-v9: شامل MMLU-Pro ۱۰-راهه و رکوردهای «ناشناختنی» که در آنها شواهد حذف شدهاند. برای این موارد، Kev-9B تنها در ۵٪ مواقع با اطمینان ≥۰.۹ پاسخ میدهد، در حالی که این عدد برای Kev-8B برابر ۲۶٪ است.
- مجموعههای خارجی: در ۱۴۴ تصمیم تالیفی SemIf، مدل Kev-9B امتیاز ۰.۹۱۷ گرفت. در ۹۰۰ تیکت پشتیبانی scienthoon، مدل Kev-9B در بخش مسیریابی ۰.۹۵۲ و در بخش لحن (Tone) ۰.۹۱۱ امتیاز کسب کرد.
جزئیات API و قابلیتهای سرور
مشخصات نقاط اتصال (Endpoints):
POST /v1/systemone: نقطه اتصال اصلی برای ارزیابی متن وضعیت در برابر مجموعهای از سؤالات.GET /v1/models: اطلاعات مربوط به مدل و نقطه بازرسی (Checkpoint) فعلاً بارگذاری شده را برمیگرداند.POST /v1/systemone/permute: بهطور خاص برای اجرای یک سؤال Choice با ترتیبهای مختلف گزینهها جهت شناسایی سوگیری طراحی شده است.POST /v1/systemone/separate: سرور را مجبور میکند هر سؤال را در یک پاس رفت (Forward Pass) مجزا اجرا کند.
مدیریت ورودی:
- Escaping: رشتههایی که شبیه جداکنندهها هستند در ورودی کاربر پیش از توکنبندی Escape میشوند تا از تزریق پرامپت (Prompt Injection) یا خطاهای ساختاری جلوگیری شود.
- Validation: درخواستهای نامعتبر خطای ۴۲۲ برمیگردانند.
- Token Counting: فیلد
usage.output_tokensتوکنهای موجود در پاسخهای سریالسازی شده را میشمارد، نه توکنهای تولید شده (Generated Tokens).
تحلیل: چرخش به سمت SLMهای تخصصی
Kev نماینده یک چرخش گستردهتر در حوزه AI است: حرکت از مدل «یک مدل برای همه کارها» به سمت معماریهای کوچکمقیاس و تخصصی برای وظایف شناختی خاص. با جداسازی پردازش «وضعیت» از «سر تصمیمگیر»، Kev مشکل رایج LLMها را حل میکند که در آن ترتیب گزینهها در پرامپت، پاسخ را تغییر میداد.
برای یک توسعهدهنده عملی، این به معنای توانایی ساخت خط لولههای طبقهبندی قابل اعتماد، خصوصی و سریع است، بدون اینکه نیاز باشد هزینه هر توکن را به یک ارائهدهنده ابری پرداخت کند. حرکت به سمت «سرهای اشارهگر» بهجای «تولید متن»، یک چرخش فنی حیاتی است که احتمال ریاضی را بر تقلید زبانی اولویت میدهد.
برای شروع، توسعهدهندگان میتوانند مخزن گیتهاب Kev را بررسی کرده و وزنهای پیشآموزشدیده را روی سختافزار محلی خود تست کنند تا ببینند آیا کالیبراسیون آن با نیازهای عملیاتی آنها سازگار است یا خیر.
گام بعدی شما
- مخزن گیتهاب Kev را بررسی کرده و مدل 4B را روی سختافزار محلی خود تست کنید تا میزان کالیبراسیون آن با نیازهای شما سازگار باشد.
- اگر از مک استفاده میکنید، برای دستیابی به تأخیر زیر ۲۰۰ میلیثانیه، نسخههای مبتنی بر Qwen3 را جایگزین Qwen3.5 کنید.
- برای دستهبندیهای خاص کسبوکارتان، مجموعهای از چند صد نمونه برچسبگذاری شده تهیه کرده و از قابلیت Fine-tuning برای افزایش دقت استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو