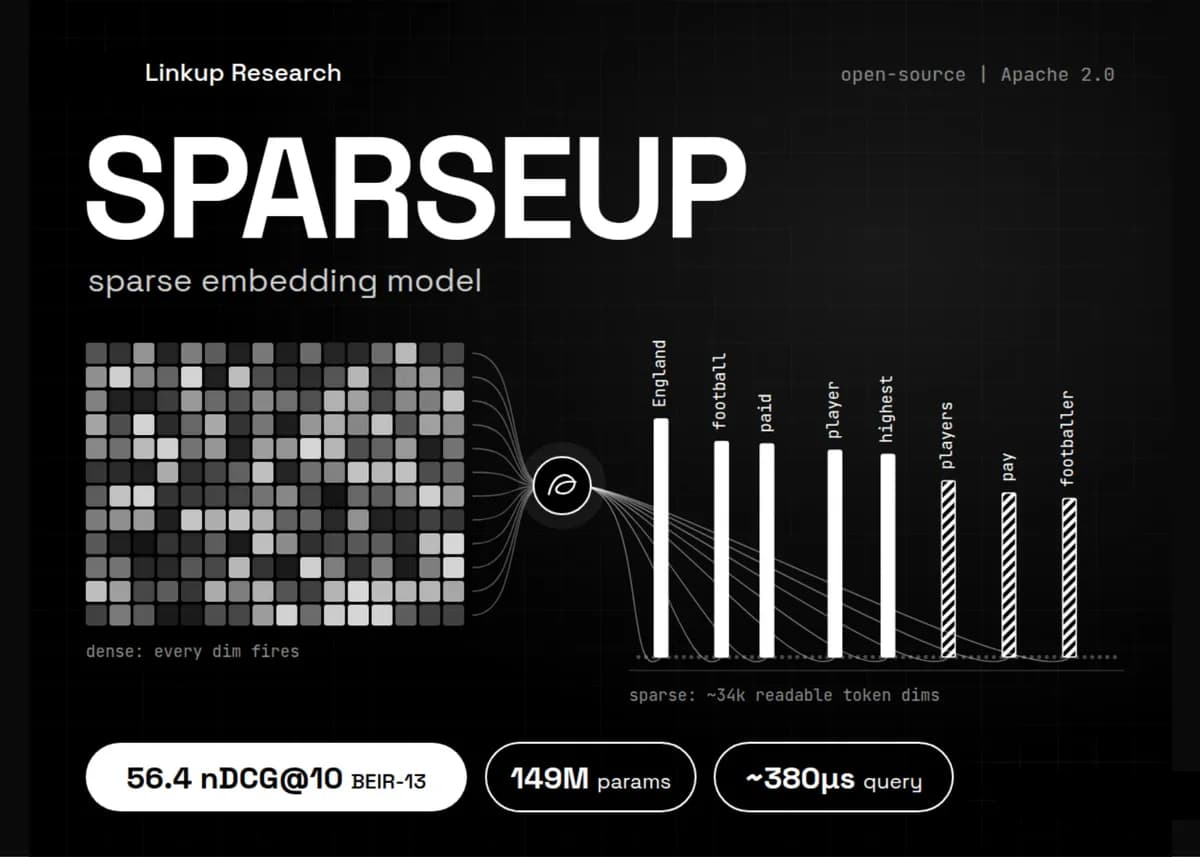
اگر به دنبال تعادلی میان دقت جستوجوی معنایی و سرعت خیرهکننده هستید، مدل جدید SPARSEUP قواعد بازی را برای مدلهای کوچک تغییر داده است. این مدل با ۱۴۹ میلیون پارامتر، اکنون پیشتاز مدلهای عمومی مبتنی بر واژگان در کلاس وزنی خود است و امتیاز ۵۶.۴ را در محک BEIR-13 به دست آورده است.
به نقل از مستندات فنی Linkup Research، این مدل تحت مجوز Apache 2.0 منتشر شده تا توسعهدهندگانی که به تفسیرپذیری بردارها نیاز دارند، دیگر مجبور نباشند کیفیت بازیابی را فدای شفافیت کنند. در دنیای امروز، اکثر سامانههای بازیابی بر بردار معنایی (Embedding) متراکم تکیه میکنند؛ بردارهایی که کل متن را در یک رشته عدد فشرده میکنند اما برای انسان مانند یک «جعبه سیاه» هستند. در مقابل، مدلهای پراکنده (Sparse) وزنها را روی یک واژگان واقعی توزیع میکنند، به این معنا که هر بُعد بردار مستقیماً به یک توکن خاص متصل است. این ساختار اجازه میدهد بردارها در شاخصهای معکوس سنتی جای بگیرند و در تطبیق کلمات نادر، بسیار موفقتر عمل کنند. این رویکرد در واقع تکامل یافتهی متدهای بازیابی است که تنظیم دقیق مدلهای چندبرداری در آنها توانسته بازیابی اسناد تخصصی را بهینه کند.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی استنتاج در مدلهای زبانی اشاره کردیم، کاهش اندازه مدل بدون افت کیفیت، کلید استقرار در مقیاس واقعی است. طبق گزارش Marktechpost، مدل SPARSEUP برای تکمیل خانواده مدلهای DenseOn و LateOn توسعه یافته است تا پژوهشگران بتوانند سبکهای بازیابی متراکم، پراکنده و تعاملی را در کنار هم مقایسه کنند.
معماری فنی و اصلاحات ساختاری
این مدل بر پایه معماری ModernBERT بنا شده و از یک نقطه بازرسی (Checkpoint) بدون نظارت LateOn آغاز شده است. تیم توسعه برای بازگرداندن قابلیتهای لازم، سرِ MLM اصلی ModernBERT را به مدل پیوند زدند. برای تنظیم دقیق (Fine-tuning)، از یادگیری تقابلی (Contrastive Learning) استفاده شد؛ بهطوری که هر پرسوجو با نمونههای منفی دروندستهای و ۷ نمونه منفی سخت (Hard Negatives) جفت شد. نکته قابل توجه این است که آموزش این مدل نیازی به تقطیر (Distillation) از مدلهای Cross-encoder نداشت و تنها روی یک پردازنده GPU مدل H100 اجرا شد. این پیادهسازی در کنار ۷۲ معماری مدرن LLM در مخزن متنباز OpenArch، به درک عمیقتر توسعهدهندگان از ساختارهای بهینه مدلهای زبانی کمک میکند.
برای حل مشکل «کیسه کلمات توقف» (Bag of Stopwords) که در مدلهای SPLADE رایج است، سه مکانیزم خاص پیاده شد:
- تغییر لاجیت (Logit Shifting): استفاده از تابع $\log(1 + \text{ReLU}(x - 15))$ برای جلوگیری از اشباع شدن لاجیتهای ModernBERT در ابتدای کار.
- Top-k در هر موقعیت: هر توکن ورودی تنها به ۱۲ بُعد قویترین واژگان محدود میشود تا از گسترش بیش از حد بردار جلوگیری شود.
- یکسانسازی حروف (Case Folding): ادغام شناسههای BPE (مثلاً "heat" و "Heat") در یک شناسه واحد برای کاهش ابعاد خروجی از ۵۰ هزار به حدود ۳۴ هزار.
عملکرد و محکهای ارزیابی
در محک BEIR-13، امتیاز ۵۶.۴ مدل SPARSEUP از رقبایی چون splade-v3 (۵۱.۷) و ModernBERT-VT (۵۲.۴) پیشی گرفته است. با این حال، در مقایسهای کنترلشده با دادههای یکسان، این مدل همچنان از LateOn (۵۸.۹) و DenseOn (۵۷.۹) عقبتر است. ضعف اصلی مدل در مجموعههای معنایی مانند FiQA و DBPedia است، اما در مجموعههای ArguAna و Touché برنده است و حتی در HotpotQA از DenseOn بهتر عمل میکند.
سرعت و میزان پراکندگی
کارایی، نقطه قوت اصلی این مدل است. در مجموعه MS MARCO، این مدل بهطور متوسط ۴۷ عبارت غیرصفر برای هر پرسوجو تولید میکند. وقتی این مدل با شاخص معکوس Seismic ترکیب شود، در هر رشته (Thread) تنها ۳۸۰ میکروثانیه زمان میبرد تا به بازخوانی (Recall) بالای ۹۷٪ دست یابد.
تیم Linkup اشاره کرد که افزایش اندازه بردارها میتوانست ۱ تا ۲ امتیاز به BEIR اضافه کند، اما آنها اولویت را به حفظ «پراکندگی» دادند تا سرعت استنتاج فدای دقت جزئی نشود. برای استقرار، توسعهدهندگان میتوانند وزنها را از طریق Hugging Face و با فعال کردن trust_remote_code=True در کتابخانه Transformers بارگذاری کنند.
گام بعدی شما
- اگر از سیستمهای RAG استفاده میکنید، مدل SPARSEUP را برای جایگزینی با مدلهای متراکم در لایه بازیابی اولیه تست کنید تا تأخیر (Latency) را کاهش دهید.
- برای بررسی تفاوت دقت، مدل را روی دادههای تخصصی خود در حوزههایی که کلمات کلیدی نادر دارند (مانند متون حقوقی یا پزشکی) ارزیابی کنید.
- مستندات Seismic را برای پیادهسازی شاخصهای معکوس بهینه مطالعه کنید.
اما تأثیر این بهینهسازیها بر مصرف حافظه در محیطهای تولیدی حتی جذابتر است — به تحلیل ما دربارهی کوانتش وزنها در مدلهای BERT مراجعه کنید.



گفتگو