هزینههای استنتاج در عاملهای کدنویسی با سرعتی غیرقابلتحمل در حال رشد است، اما راهکاری برای کاهش ۵۰ درصدی این هزینهها بدون دست زدن به مدلهای پایه پیدا شده است. در ۲۶ سپتامبر ۲۰۲۶، پژوهشگران انویدیا (Nvidia) از SoL-Pi پردهبرداری کردند؛ سامانهای که «هارنس» (Harness) یا همان لایه کنترلی حیاتی را بهینه میکند تا نحوه درک وضعیت، اجرای عملیات و پردازش بازخوردها توسط عامل بهینهتر شود.
تا پیش از این، اکثر تلاشها برای افزایش کارایی بر سطح مدل متمرکز بود؛ تکنیکهایی مانند کوانتایزیشن (Quantization)، بهبود هستههای توجه (Attention Kernels)، ارتقای زیرساختهای سرویسدهی یا جایگزینی مدلها با نسخههای ارزانتر. اما لایه هارنس که در سامانههایی مثل Codex، Claude Code و OpenClaw استفاده میشود، اغلب حاوی منطقهای تکراری است که توکنهای زیادی را هدر میدهد. به دلیل پیوستگی شدید مدیریت زمینه، استفاده از ابزار، اعتبارسنجی و منطق توقف (Abort Logic)، بهینهسازی دستی این لایه بسیار کند و مستعد خطا است. هر تغییری که در یک بخش باعث صرفهجویی در توکن شود، ممکن است در جای دیگر خطا ایجاد کند یا صرفاً هزینهها را به مراحل بعدی منتقل نماید.
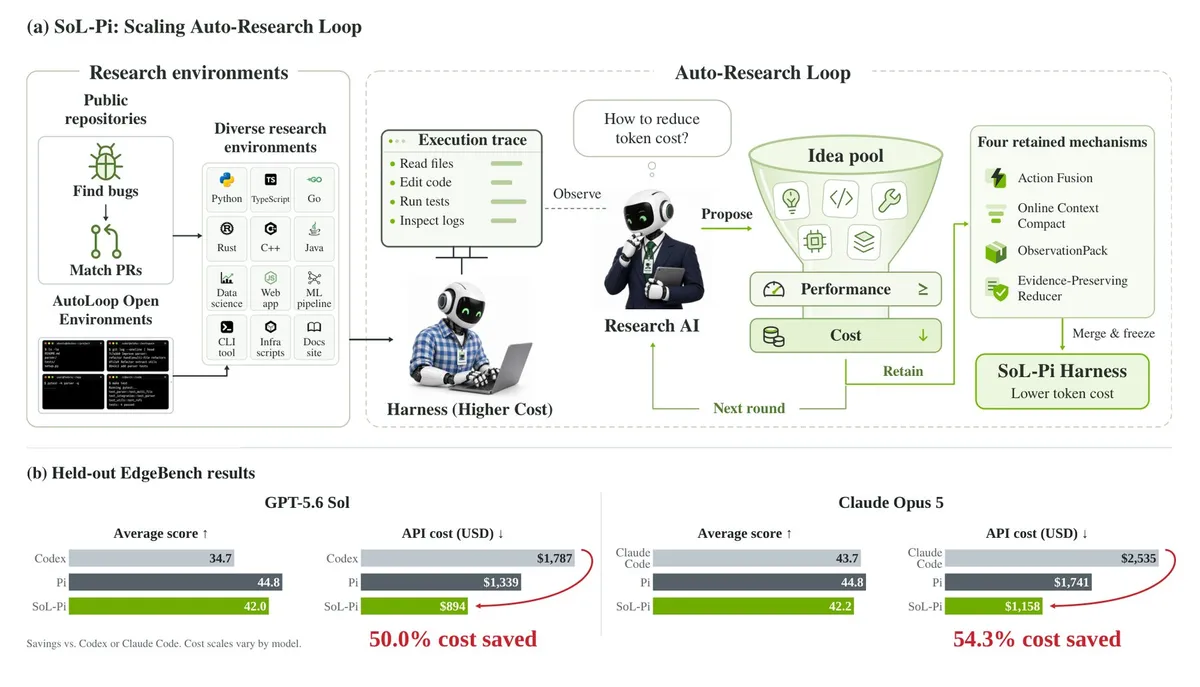
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی هزینههای استنتاج اشاره کردیم، تمرکز بر لایههای پیرامونی مدل میتواند نتایجی سریعتر از بازآموزی مدلها داشته باشد. این رویکرد با تلاشهای اخیر انویدیا برای کاهش ترافیک توکنها در عاملهای کدنویسی همسو است که بر بهینهسازی جریان دادهها تأکید داشت. SoL-Pi این فرآیند را با استفاده از یک عامل پژوهشی خودکار میکند که ردپای اجرا (Execution Traces) را تحلیل کرده و تغییراتی را در هارنس پیشنهاد میدهد. این سیستم ردپای اجرای یک عامل دیگر را زیر نظر میگیرد، اصلاحاتی را پیشنهاد میدهد و آنها را در محیطهای آماده آزمایش میکند. در نهایت، بررسیهای مربوط به قابلیتها و کارایی تعیین میکنند که کدام کاندیداها باقی بمانند؛ فرآیندی که نویسندگان آن را نوعی «خودبهبودی بازگشتی» مینامند.
برای جلوگیری از بیشبرازش (Overfitting) روی تکالیف خاص — ریسکی که در کارهای قبلی مشاهده شده بود و در آن هارنسهای بهینه شده در مواجهه با تکالیف ناآشنا سود چندانی نداشتند — پژوهشگران بازخورد جستوجو را از ارزیابی نهایی بهطور سختگیرانه جدا کردند. طبق مستندات، آنها از EdgeBench به عنوان یک محک ایزوله استفاده کردند؛ از ۵۱ تکلیف عمومی این محک، ۱۱ مورد برای اعتبارسنجی یکباره کاندیداهای نهایی استفاده شد، در حالی که ۴۰ مورد باقیمانده برای ارزیابی نهایی رزرو شدند تا هرگز وارد حلقه بهینهسازی نشوند و نتایج واقعیتر باشند.
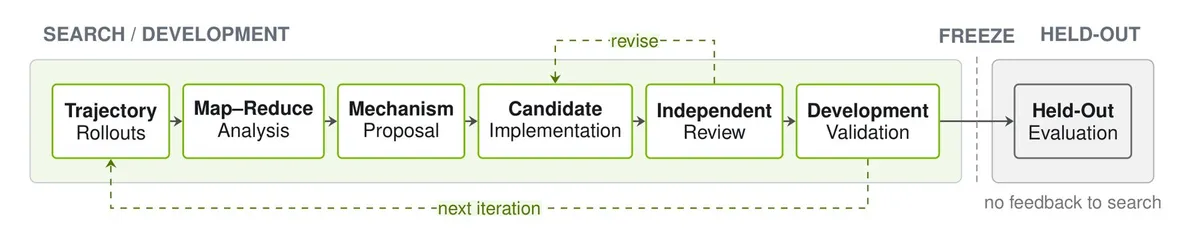
بر اساس گزارش پژوهشگران، این سیستم در ۵۳۵ محیط قابل اجرا، ۱۵۲ مسیر مختلف را بررسی کرد. این جستوجو شامل ۴۹۵ تکلیف استخراجشده از جفتهای Issue-Pull Request در گیتهاب و ۴۰ مورد تست مصنوعی بود که در مجموع منجر به بیش از ۳۰۰۰ اجرا و ۶۰ هزار تعامل بین عامل و محیط شد. البته تأکید شده است که افزایش مقیاس جستوجو لزوماً به معنای نتایج بهتر نیست و مقدار بیشتر جستوجو بهطور خودکار منجر به نتایج برتر نمیشود.
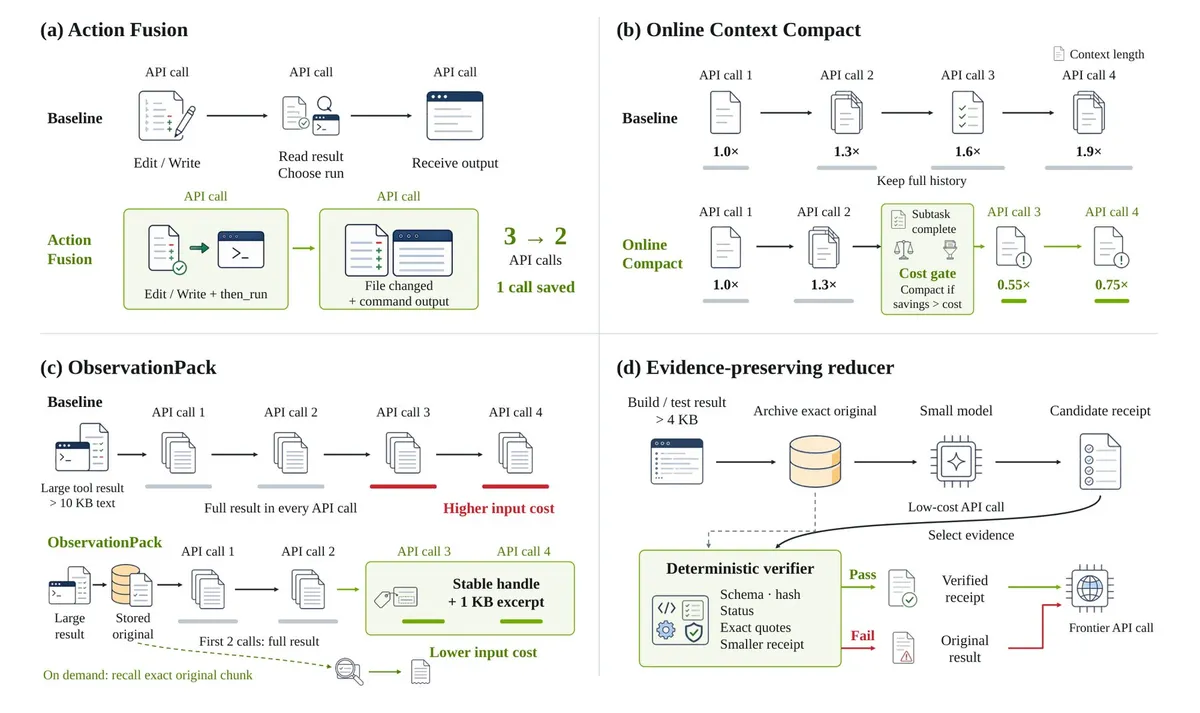
این فرآیند در نهایت چهار مکانیزم اصلی برای حذف کارهای زائد استخراج کرد:
- تلفیق عملیات (Action Fusion): ادغام دو گام متوالی (مثلاً ویرایش کد و سپس اجرای تست) در یک فراخوانی واحد برای حذف یک تعامل کامل با مدل زبانی.
- فشردهسازی آنلاین زمینه (Online Context Compact): این مکانیزم پس از هر گام برنامهریزی اجرا میشود و هرگاه بتواند بدون از دست دادن اطلاعات حیاتی، زمینه انباشته شده را کوتاه کند، این کار را انجام میدهد.
- بستهبندی مشاهدات (ObservationPack): آرشیو کردن خروجیهای طولانی ابزارها و جایگزینی آنها با خلاصههای کوتاه در گامهای بعدی، به جای ارسال مجدد متن کامل در هر بار.
- کاهشدهنده حفظ شواهد (Evidence-Preserving Reducer): ارسال لاگهای حجیم خطا و تست به یک مدل ارزانتر برای استخراج یافتههای کلیدی، همراه با یک گام تأیید خودکار برای شناسایی سرنخهای حیاتی که ممکن است در خلاصه سازی حذف شده باشند.
به گزارش the-decoder.com، کارآمدترین نسخه SoL-Pi که هر چهار مکانیزم را ترکیب میکند، ۴۹٪ توکن کمتری نسبت به هارنس اصلی Pi مصرف میکند، در حالی که ۹۳.۷٪ از امتیاز خود در EdgeBench را حفظ کرده است. جالب اینجاست که کاربرانی که اولویت را بر عملکرد گذاشته و تنها قویترین مکانیزم را انتخاب کردند، حتی ۵.۳٪ بهتر از امتیاز Pi عمل کردند و همچنان در مصرف توکن صرفهجویی شد. در مجموع، کاهش مصرف توکن بین ۴۴.۷٪ تا ۴۹٪ متغیر است.
از نظر مالی، این به معنای کاهش هزینه از ۱,۳۳۹ دلار به ۸۹۴ دلار برای یک اجرای آزمایشی خاص است. این بهینهسازیهای لایه کنترلی در کنار راهکارهای زیرساختی مانند گیتویهای SuperFast AI که هزینههای API را بهشدت کاهش میدهند، مسیر را برای تجاریسازی گستردهتر عاملهای هوشمند هموار میکند. بر اساس قیمتهای فعلی API، تخمین زده میشود که این سیستم ساعتی بین ۸.۷۵ تا ۱۳.۵۰ دلار نسبت به هارنسهای بومی Codex و Claude Code ارزانتر باشد و نسبت به Pi صرفهجویی ساعتی ۴.۳۶ تا ۵.۷۱ دلار ایجاد کند. در محک EdgeBench، میزان صرفهجویی نسبت به Codex حدود ۵۰٪ و نسبت به Claude Code حدود ۵۴.۳٪ است.
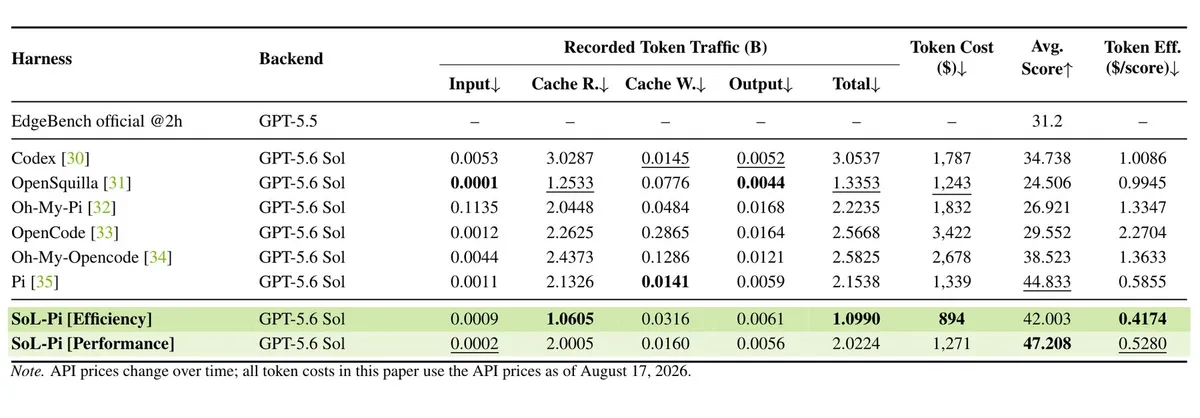
پژوهشگران این سیستم را ابتدا با GPT-5.6 Sol ساختند و سپس بدون تغییر روی Opus 5 اعمال کردند. در این حالت، ۹۴.۳٪ از عملکرد Pi حفظ شد و صرفهجوییهای مشابهی حاصل شد، هرچند مکانیزمها با شدت کمتری فعال شدند چون هارنس بر اساس مسیرهای GPT-5.6 Sol بهینه شده بود.
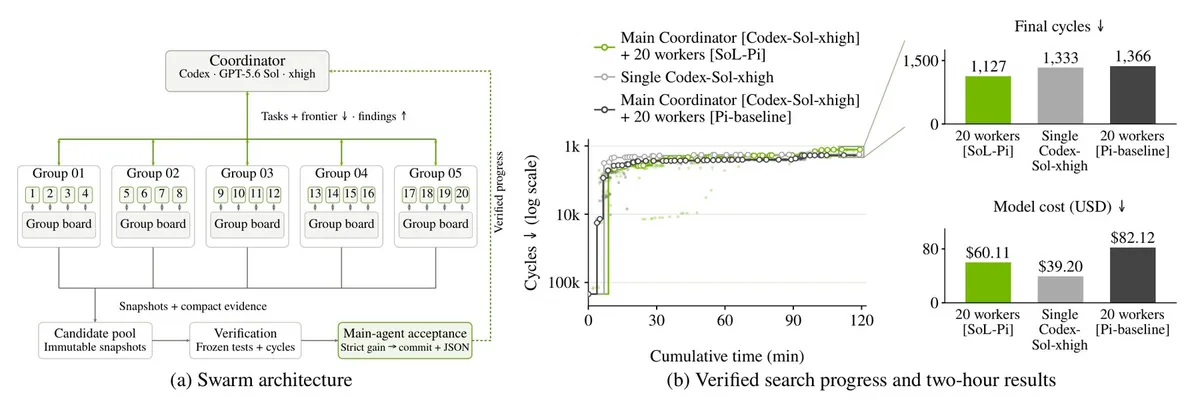
البته عملکرد در همه محکها یکسان نبود. در Terminal-Bench 4، سیستم SoL-Pi توانست ۱۵ مورد از ۶۳ تکلیف CPU را حل کند، در حالی که Codex و Pi هر کدام ۱۸ مورد را حل کردند؛ با این حال، هزینههای کل همچنان حدود یکچهارم کمتر از Pi بود. در تکالیف Lean 4 المپیاد ریاضی ۲۰۲۶ (IMO 2026)، این سیستم ۳ مورد از ۶ مسئله را با کمترین هزینه به ازای هر حل موفق، به دست آورد. همچنین در یک آزمایش بهینهسازی کرنل تخصصی با حضور دستهای از ۲۰ عامل (Worker Swarm)، SoL-Pi بهترین نتیجه کلی را با هزینهای حدود یکچهارم کمتر از یک دسته مبتنی بر Pi کسب کرد.
این دستاوردهای کارایی بدون هزینه نیستند؛ کاهش حجم زمینه میتواند بازاستفاده از حافظه پادمان (Prompt Cache) را کم کند. این موضوع در حالی اهمیت مییابد که طبق تحلیل پیتر واکر از OpenRouter، مصرف توکنهای عاملمحور از فوریه ۲۰۲۶ تاکنون ۱۴ برابر شده و نزدیک به ۷۰٪ آن مربوط به پرامپتهای کششده است. علاوه بر این، فشردهسازی زمینه ریسک دارد؛ یک مطالعه نشان داده که این روش بهطور متوسط تنها ۱۷٪ از دستورات کاربر را حفظ میکند.
این چرخش در استراتژی نشان میدهد که «پوشش» یا Wrapper دور یک مدل، به اندازه وزنهای خود مدل اهمیت دارد. تست ماه اوت توسط Composio نشان داد که مدل Deepseek V4 Flash بسته به فریمورک عامل مورد استفاده (از جمله Claude Code و Oh My Pi)، تا ۳ برابر تفاوت هزینه دارد. همچنین اریک پروونشر، توسعهدهنده Codex، هشدار داده است که استفاده از بیش از دو زیر-عامل اغلب بدون بهبود کیفیت، توکنها را میسوزاند چون آنها بیشتر وقت خود را صرف بررسی کار یکدیگر میکنند.
برای متخصصان فنی، این بدان معناست که مرز بعدی کارایی عاملها، نه فقط پرامپتنویسی بهتر یا مدلهای کوچکتر، بلکه بهینهسازی بازگشتی هارنس است. پژوهشگران آیندهای را متصورند که در آن هارنسها مانند مدلهای زبانی روی مجموعههای عظیم داده پیشآموزش میبینند تا جستوجو برای نسخههای بعدی ارزانتر شود.
منتظر ادغام این تکنیکهای بهینهسازی هارنس در فریمورکهای متنباز عاملها باشید، زیرا صنعت به سمت «کارایی بازگشتی» حرکت میکند تا هزینههای انفجاری گردشکارهای خودمختار را مدیریت کند.
گام بعدی شما
- بررسی فریمورکهای متنباز عاملها برای یافتن قابلیتهای فشردهسازی زمینه (Context Compression).
- ارزیابی مجدد تعداد زیر-عاملها در گردشکارهای خود برای جلوگیری از اتلاف توکن در بررسیهای متقابل.
- دنبال کردن ادغام تکنیکهای Action Fusion در ابزارهای توسعه خودکار کد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو