تصور کنید بتوانید قدرت رندرینگ پیشرفتهترین کارتهای گرافیک انویدیا را روی سختافزارهای دیگر یا حتی در یک تب مرورگر تجربه کنید. این دیگر یک رویا نیست، بلکه نتیجهی مهندسی معکوس دقیق یکی از پیچیدهترین سیستمهای بصری دنیای گیمینگ است.
یک توسعهدهنده پروژه OpenDLSS-NR را منتشر کرد؛ پیادهسازی مجددی بر پایه Vulkan از شبکه رندرینگ عصبی NVIDIA DLSS 5 که تطابق کامل بیت-به-بیت با نسخه اصلی (بیلد ۳۱۰.۸.۰) دارد. این پروژه اجازه میدهد فرآیند پیچیده رندرینگ زاینده خارج از اکوسیستم بسته انویدیا اجرا شود، در حالی که خروجی آن دقیقاً مشابه نسخه اصلی است.
سالهاست که فناوری DLSS انویدیا مانند یک «جعبه سیاه» از وزنهای اختصاصی و هستههای بسته عمل میکند. در حالی که تلاشهای قبلی بر روی بزرگنمایی (Upscaling) — شبیه به ذرهبینی که تصویر کوچک را میکشد تا بزرگ شود — متمرکز بود، این پروژه بخش «رندرینگ عصبی» (NR) را هدف قرار داده است. این بخش برخلاف ابزارهای افزایش رزولوشن، یک هوش مصنوعی زاینده (Generative AI) است؛ مثل نقاشی ماهری که فقط تصویر را بزرگ نمیکند، بلکه جزئیات جدیدی را بر اساس نویزهای تزریقشده خلق میکند و بافت پوست یا ساختار محیط را بر اساس یک تنظیمات سبک (Style Setting) بازسازی میکند. در واقع، این سیستم فریمهایی را که موتور گرافیکی قبلاً رسم کرده است، مجدداً رندر میکند تا جزئیات را از نویزهای تزریق شده استخراج کند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، دسترسی به ساختار داخلی مدلهای بسته، مرز بین «تخمین» و «دانش» را جابهجا میکند. طبق مستندات پروژه، این پیادهسازی یک U-net متشکل از بلوکهای ترنسفورمر با پنجرههای جابهجا شده است که یک ترنسفورمر بینایی (Vision Transformer یا ViT) در پایه دارد. این شبکه از ۷۱ بلوک در ۶ سطح پولینگ تشکیل شده و از ۱۴۱ مگابایت وزن استفاده میکند. برخلاف ابزارهای رایج، رزولوشن ورودی و خروجی در اینجا یکسان است و تمرکز مدل بر خلق جزئیات زاینده و ترکیب زمانی است.
منطق شبکه و سازوکار رندرینگ
بر اساس مستندات فنی، این شبکه به عنوان یک سیستم رندرینگ عصبی زاینده عمل میکند و عملیات بزرگنمایی انجام نمیدهد. برای تولید نتیجه نهایی، مدل مجموعهای از ورودیهای خاص را دریافت میکند: یک فریم رندر شده (که به عنوان یک پروکسی با محدوده دینامیکی پایین یا Low Dynamic Range ارائه میشود)، سه مسیر از نویز گاوسی، خروجی فریم قبلی که بازپروژکت (Reprojected) شده است و پنج اسکالر شرطی.
خروجی مدل شامل چهار کانال f32 برای هر پیکسل است. این کانالها به یک باقیمانده RGB (RGB residual) و یک لاجیت ترکیب زمانی (Temporal-blend logit) تقسیم میشوند. مسیر زمانی در نسخه دموی پروژه پیاده شده است، جایی که ورودیهای تاریخچه شبکه و لاجیت ترکیب هر پیکسل، یک حلقه بازخورد بازپروژکت شده را هدایت میکنند تا پایداری بصری در طول زمان حفظ شود.
معماری فنی و عملکرد
این پیادهسازی برای حفظ سرعت و دقت از قابلیتهای پیشرفته GPU استفاده میکند:
- دقت (Precision): استفاده از فعالسازهای FP8 (E4M3) با تجمع FP16 که مستقیماً روی هستههای تنسور (Tensor Cores) اجرا میشوند.
- هستهها (Kernels): پروژه هم هستههای مرجع GLSL و هم هستههای بهینهشده PTX را برای «مسیر سریع» ارائه میدهد. مسیر PTX از دستورات
mma.syncE4M3 با تجمع f16، حلقههایcp.asyncو زنجیرهسازی بدون مانع (barrier-free chaining) از طریق شمارندههای دستگاه استفاده میکند. - مکانیزمهای بهینهسازی: مسیر سریع از GEMMهای Split-K و توجه جهانی استریمشده (Streamed Global Attention) بهره میبرد. مسیر مرجع GLSL نیز از طریق سوئیچ
DLSS5VK_UNFUSED=1در دسترس است، هرچند این مسیر تمام مراحل میانی را متریالیزه میکند و به رزولوشن ۲۵۶۰x۱۴۴۰ محدود است. - پورت WebGPU: یک پیادهسازی ثانویه در مسیر
ports/browser-webgpu/اجازه میدهد این شبکه در مرورگر اجرا شود. با وجود نبود هستههای تنسور، عدم پشتیبانی از FP8 و نبود ادغام (Fusion) بین بلوکها، خروجی آن همچنان با کپچرهای اصلی تطبیق بیت-به-بیت دارد. این موضوع ثابت میکند که دقت مدل در مشخصات ریاضی و تعریف آن است، نه در سختافزار خاص.
بنچمارکهای عملکرد روی یک RTX 4070 SUPER نشان میدهد که شبکه بسیار بهینه است و در هر رزولوشن به ۲۴۱ دیسپچ (Dispatch) نیاز دارد. حداقل زمان اجرا برای ۴۰ فریم به شرح زیر است:
- ۷۶۸x۷۶۸: ۲.۸ میلیثانیه
- ۱۹۲۰x۱۰۸۰: ۷.۸ میلیثانیه
- ۲۵۶۰x۱۴۴۰: ۱۲.۶ میلیثانیه
- ۳۸۴۰x۲۱۶۰: ۲۹.۳ میلیثانیه
در مقابل، پورت WebGPU بهمراتب کندتر است و برای رزولوشن بسیار کوچک ۵۱۲x۵۱۲ حدود ۷۲ میلیثانیه زمان میبرد.
موتور تطبیق و اعتبارسنجی
نویسنده برای اثبات «تطبیق بیت-به-بیت»، یک سیستم اعتبارسنجی سختگیرانه طراحی کرده است. این ابزار ۷۵ مرز بلوک را بایت-به-بایت با کپچرهای ضبطشده از نرمافزار اصلی انویدیا مقایسه میکند. اگر حتی یک بیت در مراحل میانی یا خروجی نهایی متفاوت باشد، اعتبارسنجی شکست میخورد.
سیستم تطبیق از فیکسچرهایی (پوشههای حاوی manifest.json) برای تایید اجرای GPU استفاده میکند. این فیکسچرها چندین گیت یا دروازه کنترلی را بررسی میکنند:
- مرزها (Boundaries): مراجع E4M3 برای بلوکهای ۰ تا ۶۹ و پنج انتقال رمزگذار (Encoder Transitions).
- سر (Head): بخش f32 RGBA.
- خروجی (Output): تصویر نهایی که میتواند به صورت f32 (نیمی از RGBA) یا u8 (کپچر ۸ بیتی) باشد.
احکام این سیستم بسیار سختگیرانه است؛ «پاس» یعنی تطبیق کامل بیت-به-بیت. حتی اگر نتیجه فقط در علامت صفر (Sign of zero) متفاوت باشد، سیستم خطا میدهد. برای اطمینان از اینکه خروجیها با همان گراف تحت موانع (Barriers) مطابقت دارند، سیستم میتواند بخش Head و Output را چندین بار (به طور پیشفرض ۳ بار) ارسال کند.
کاربران میتوانند اجرا را با سوئیچهای مختلف تنظیم کنند. سوئیچ DLSS5VK_CHAIN=0 زنجیرهسازی شمارندهها را با موانع بین هر لانچ جایگزین میکند. سوئیچهای DLSS5VK_SPLITK=0 و DLSS5VK_NO_PTX_MLP=1 به ترتیب قابلیت Split-K و MLP در PTX را غیرفعال میکنند. همچنین DLSS5VK_CHAIN_MASK (با مقدار پیشفرض ۳) ماسکگذاری برای مراحل خبره (Expert stages)، بلوکهای c32 و Split GEMMها را کنترل میکند.
نیازمندیهای سختافزاری و نرمافزاری
اجرای این ابزار به سختافزارهای مدرن و درایورهای خاص نیاز دارد. کاربران به GPU با معماری Ada انویدیا (یا جدیدتر) و درایورهایی که افزونههای Vulkan زیر را در معرض قرار دهند، نیاز دارند:
VK_KHR_cooperative_matrixVK_NV_cooperative_matrix2VK_EXT_shader_float8VK_NV_cuda_kernel_launch
فرآیند بیلد به Visual Studio ۲۰۲۲ یا نسخههای جدیدتر با تولست C++ x64، پایتون ۳ برای ژنراتورهای PTX و Node.js به همراه npm و کتابخانه Pillow برای مبدل صحنه نیاز دارد. پروژه از یک زنجیره ابزارهای قابل حمل شامل glslang ۱۶.۶.۰، Vulkan-Headers v۱.۴.۳۶۳، CMake ۳.۳۱ و Ninja ۱.۱۳ استفاده میکند.
یکپارچهسازی و دمو
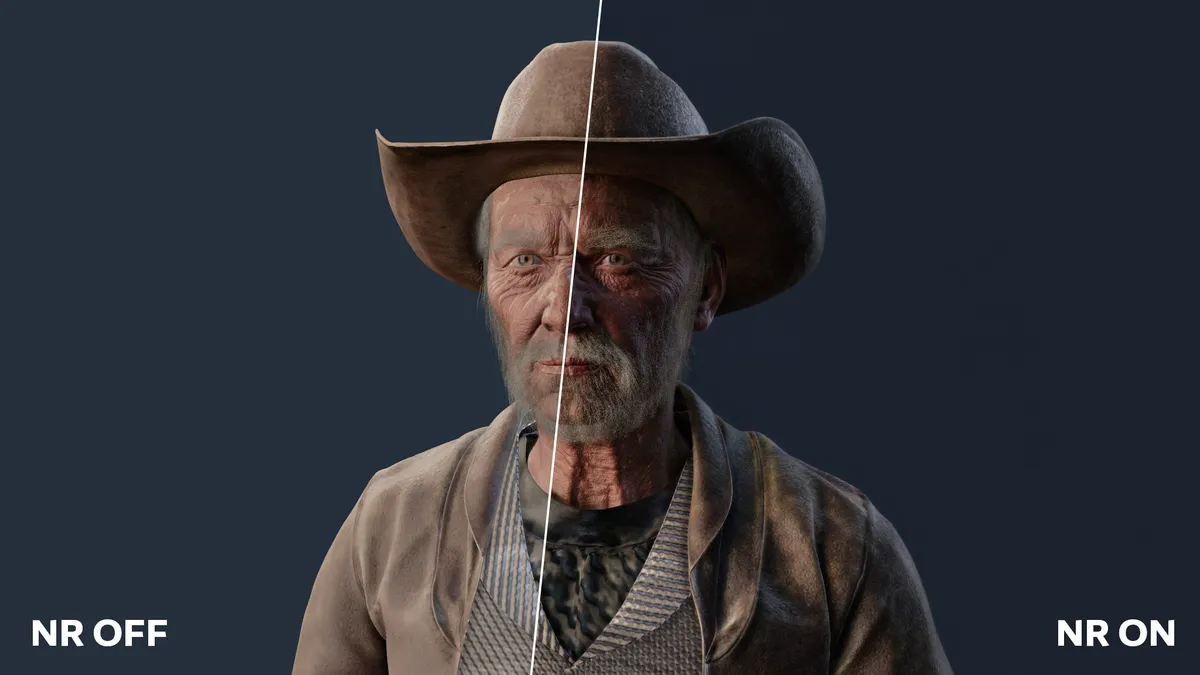
پروژه شامل یک دمو است که در فریمورک Filament (تحت لایسنس Apache-2.0) نسخه ۱.۷۷.۰ یکپارچه شده است. Filament برای پشتیبانی از بردارهای حرکت هر شیء (Per-object motion vectors) و یک هوک interop Vulkan پچ شده است. این دمو اجازه میدهد کاربران صحنههای glTF (مانند صحنه "Cowboy Gramps" اثر Muhammed Ismayil) را بارگذاری کرده و رندرینگ عصبی را در لحظه فعال یا غیرفعال کنند.
دایرکتوری مدل از طریق manifest.json خوانده میشود که شامل یک آرایه stages (شامل شناسه، فایل، طول بایت بستهبندی شده و sha256) و یک آرایه tensors (شامل نام، بلوک، لایه، پارامتر، مرحله، آفست مرحله و طول بایت) است. میزبان (Host) این وزنهای E4M3 را برای هستهها به فرمهای ماتریسی بازچیدمان میکند. سیستم بهشدت هر مدلی را که تعداد بلوکهای آن غیر از ۷۱ باشد، رد میکند.
این سطح از شفافیت برای فناوری DLSS بسیار نادر است. با ارائه مرجع CPU از محاسبات ریاضی و گراف کامل شبکه در فایل docs/network.md، این پروژه عملاً کاپوت آخرین رویکرد رندرینگ زاینده انویدیا را بالا زده است. از منظر فنی، این دستاورد بحث را از «چگونه DLSS را شبیهسازی کنیم» به «چگونه آن را بهطور کامل بازسازی کنیم» تغییر میدهد. این موضوع ثابت میکند که مشخصات ریاضی این شبکهها را میتوان از درایورهای اختصاصی جدا کرد، به شرطی که وزنها در دسترس باشند. این امر در را برای پژوهشگران باز میکند تا دقیقاً تحلیل کنند رندرینگ زاینده انویدیا چگونه نویز و ساختار را مدیریت میکند، بدون اینکه نیاز باشد بر اساس خروجی بصری حدس بزنند.
برای کاربر نهایی، این به معنای پتانسیل ایجاد خط لولههای رندرینگ منعطفتر است. اگر وزنها در بستر Vulkan یا WebGPU بارگذاری شوند، رندرینگ زاینده میتواند از وابستگی شدید به درایور رها شود و اجازه دهد «تنظیمات سبک» سفارشی یا وزنهای تغییریافته برای جلوههای هنری خاص ایجاد شود. این انعطافپذیری در دسترسی به سختافزار، یادآور تلاشهایی است که برای بهینهسازی دسترسی به GPUهای انویدیا در محیطهای مجازی صورت گرفته تا افت عملکرد به حداقل برسد.
در آینده باید منتظر تلاشهای جامعه متنباز برای ارائه مجموعهوزنهای سازگار یا نسخههای تغییریافته از شبکه ۷۱-بلوکی باشید که بتوانند عملکرد را برای GPUهای غیر از Ada بهینه کنند. این رویکرد بازسازی شبکههای عصبی پیچیده روی سختافزار، مشابه پروژه Fly.exe است که موفق شد ساختار عصبی یک مگس را روی کارت گرافیک شبیهسازی کند.
گام بعدی شما
- اگر توسعهدهنده گرافیک هستید، مستندات
network.mdپروژه را برای درک نحوه مدیریت نویز در رندرینگ زاینده مطالعه کنید. - برای تست عملکرد، دمو Filament را روی کارتهای سری ۴۰ انویدیا اجرا کنید تا تفاوت رندرینگ عصبی را در لحظه ببینید.
- منتظر تلاشهای جامعه متنباز برای ارائه مجموعهوزنهای سازگار با GPUهای قدیمیتر (غیر از Ada) باشید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو