تصور کنید برای استخراج ساختار یک فایل PDF، دیگر نیازی به خوشههای عظیم GPU نباشد. این همان واقعیتی است که Papero فراهم میکند؛ پروژهای متنباز که در ۱ اکتبر ۲۰۲۶ منتشر شد و اجازه میدهد فایلهای PDF را به فرمتهای Markdown، JSON، Word و Excel تبدیل کنید، بدون آنکه ترتیب خواندن یا فرمولهای ریاضی فدای مدلهای سنگین یادگیری ماشین شوند.
بسیاری از تجزیهکنندههای PDF با «شکاف ساختاری» دستوپنجه نرم میکنند. استخراج متن خام ساده است، اما تشخیص اینکه کدام ستون اول میآید یا جدول کجا تمام میشود، بهطور بدنامی دشوار است. این نقص معمولاً خط لولههای تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — را مختل میکند، زیرا مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — متنی بههمریخته دریافت میکند که منطق سند اصلی را ندارد.
یک مقاله علمی پیچیده با سه ستون و فرمولهای تودرتو LaTeX را در نظر بگیرید. ابزارهای سنتی معمولاً صفحه را بهصورت افقی میخوانند و جملات ستونهای مختلف را با هم ترکیب میکنند. Papero این مشکل را با استفاده از هندسه ساده و یک الگوریتم XY-cut که نسبت به ستونها حساس است، حل میکند تا جریان موردنظر سند را بازسازی نماید.
معماری فنی و موتورهای پردازش
به نقل از مستندات این پروژه در گیتهاب، این ابزار برای تضمین دقت از دو موتور همزمان استفاده میکند:
- موتور چیدمان (Layout Engine): این بخش که بر پایه PDFium ساخته شده، موقعیت، فونت و اندازه هر نویسه (Glyph) را میخواند. این موتور با شناسایی خطوط و تصاویر، جداول، لیستها و اشکال را بازسازی میکند و از یک XY-cut آگاه از ستونها برای بازسازی چیدمان استفاده میکند.
- Apache Tika: این مؤلفه مسئول مدیریت متادادهها، سرتیترهای PDF تگگذاری شده و نویسهخوانی نوری (OCR) — شبیه تبدیل عکس یک متن به حروف قابل تایپ — از طریق Tesseract برای صفحات اسکنشده است. همچنین این بخش پشتیبانی از فرمتهای غیر PDF مانند DOCX, PPTX, XLSX و EPUB را فعال میکند.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی خط لولههای داده اشاره کردیم، حذف وابستگی به مدلهای سنگین در لایههای پیشپردازش، سرعت کل سیستم را بهطور چشمگیری افزایش میدهد. این رویکرد یادآور تلاشهای شرکت LandingAI است که با بهینهسازی مدلهای استخراج داده، هزینههای عملیاتی را تا ۸۰٪ کاهش داد.
مکانیزمهای دقیق استخراج
Papero روی عناصری تمرکز کرده که معمولاً باعث شکست لودرهای LLM میشوند. این ابزار مقالات چندستونی را ستونبهستون میخواند و نویزهایی مثل سرصفحه، پانویس، شماره صفحه و لوگوهای تکراری را فیلتر میکند.
- جداول واقعی: این ابزار جداول خطکشیشده، بدون حاشیه و جداول LaTeX booktabs را شناسایی کرده و آنها را به سطر و ستون تبدیل میکند، حتی اگر سلولها شامل چندین خط متن باشند. این دادهها قابل انتقال به CSV یا Excel هستند. این دقت در تبدیل ساختارها، مشابه رویکردی است که Oxlo.ai برای تبدیل متون پیچیده مالی به دادههای دیجیتال ساختاریافته به کار میبرد.
- فرمولهای ریاضی: موتور پردازش، توانها، شاخصها، کسرهای تودرتو و علامتهای رادیکال ترسیمشده را شناسایی کرده و آنها را به LaTeX تبدیل میکند (مثلاً ۵/۱۲ به
\frac{5}{12}و ۱۰√۲ به\sqrt{2}تبدیل میشود). برای جلوگیری از دست رفتن دادهها، یک تصویر PNG برشخورده از فرمول نیز ارائه میشود. - اشکال و نمودارها: تصاویر و نمودارهای برداری به PNG تبدیل میشوند. سیستم کپشن، برچسبهای محور و راهنمای نمودار (Legend) را بهعنوان یک واحد یکپارچه در کنار هم حفظ میکند.
- دادههای موقعیتی: به هر بلوک یک جعبه محصور (Bounding Box) با مختصات [x0, y0, x1, y1] بر حسب نقاط (Points) اختصاص مییابد که مبدأ آن گوشه بالا-چپ است. این قابلیت به کاربر اجازه میدهد در پاسخهای RAG دقیقاً به نقطه موردنظر در صفحه ارجاع دهد یا روی صفحه ترسیم کند.
- حفظ قالببندی: در خروجیهای Word (.docx) و HTML، ترازبندی، تو رفتگیها، فاصله خطوط، بخشهای Bold و فونتها حفظ میشوند. حتی تکیهکلامهایی که در PDFهای LaTeX بهعنوان نویسههای جداگانه ترسیم شدهاند (مثلاً تبدیل Computa¸ca˜o به Computação) به درستی ترکیب شده و متنهای سفید نامرئی که توسط فرمسازها استفاده میشوند، حذف میگردند.
ساختار دادهای در سطح بلوک
در هنگام خروجی JSON، سیستم یک طرحواره بسیار دقیق ارائه میدهد. هر بلوک با یک شناسه منحصربهفرد (مثلاً p1-b4) شناسایی و دستهبندی میشود. انواع بلوکهای موجود عبارتند از:
- عناصر متنی: سرتیتر (همراه با سطح/Level)، پاراگراف، آیتم لیست (همراه با نشانگر/Marker) و کد.
- عناصر ساختاری: جدول (همراه با سطرها)، شکل، فرمول (همراه با LaTeX) و کپشن.
- عناصر حذفشده: سرصفحه، پانویس و شماره صفحه از جریان اصلی متن جدا شده و بهطور مجزا نگهداری میشوند.
برای هر پاراگراف، یک شیء style (شامل اندازه فونت، نام فونت و وضعیت Bold) و یک شیء format (شامل ترازبندی، تو رفتگی خط اول و فاصله خطوط) تعریف میشود. همچنین متن به بخشهای کوچکتر به نام runs تقسیم میشود تا بازههای خاص Bold یا Italic در یک بلوک واحد ردیابی شوند.
عملکرد و حریم خصوصی
بزرگترین تغییر در نیازهای محاسباتی است. برخلاف ابزارهایی مثل Marker یا Docling که به PyTorch یا مدلهای ML نیاز دارند، Papero روی CPU یک لپتاپ اجرا میشود. طبق گزارشهای بنچمارک روی مقالات متراکم arXiv، میانگین زمان استخراج ساختار ۳۹ میلیثانیه برای هر صفحه بود و در ۵۴ مقاله آزمایشی، هیچ شکستی ثبت نشد.
در مقایسه با کتابخانههای دیگر، Papero ترکیبی منحصربهفرد ارائه میدهد. در حالی که PyMuPDF، pdfplumber و pypdf جعبههای محصور را میدهند، اما فاقد ترتیب خواندن چندستونی و استخراج فرمولهای LaTeX هستند. در حالی که Docling و Marker این قابلیتها را دارند، اما به مدلهای سنگین ML نیاز دارند. Papero تنها ابزاری در این مجموعه است که بهطور کامل در مرورگر اجرا میشود.
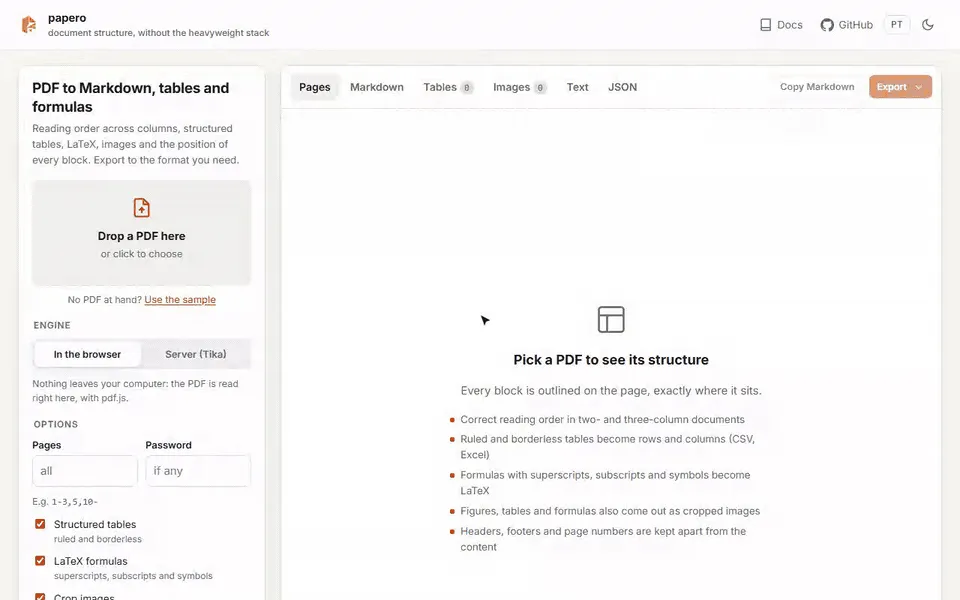
حریم خصوصی در تار و پود طراحی این ابزار است. با پورت کردن الگوریتم به جاوااسکریپت از طریق pdf.js، فایل PDF هرگز دستگاه کاربر را ترک نمیکند. کاربر میتواند در حدود ۳۰ ثانیه فایل را بارگذاری، هر بلوک را بازرسی، جداول را چک و خروجی Word بگیرد، بدون آنکه دادهای به سرور ارسال شود.
یکپارچهسازی و استقرار
توسعهدهندگان میتوانند با دستور ساده pip install papero-extract این ابزار را پیادهسازی کنند. کتابخانه توابعی مثل extract و extract_text (که سریعترین حالت برای استخراج متن خالص است) را فراهم میکند.
مثالهای پیادهسازی در پایتون:
- دستور
doc = extract("paper.pdf", images=True)اجازه دسترسی بهdoc.tables[0].rows(مثلاً[["Model", "Accuracy"], ["Base", "0.81"]]) یاdoc.formulas[0].latex(مثلاً"E = mc^{2}") میدهد. - توابع
doc.to_markdown()یاdoc.to_html()خروجی قالببندی شده ارائه میدهند. - تابع
doc.to_dict()طرحواره کامل JSON شامل متادادههایی مثل عنوان، نویسنده و زبان را برمیگرداند.
گزینههای CLI و API:
- CLI: کاربران میتوانند با دستور
pdf-text-api extract paper.pdf -o paper.md --imagesخروجی Markdown و تصاویر را دریافت کنند، یا با-f csv -o tables.csvفقط جداول را استخراج کنند. سایر فلگها شامل-p 1-5برای صفحات خاص و--fastبرای متن خالص است. - REST API: یک نقطه اتصال POST (
/v1/extract) از فرمتهایjson،markdown،text،html،csvوzipپشتیبانی میکند. پارامترها شاملper_page=trueبرای گنجاندن بلوکها و موقعیتها در JSON، و گزینههایocr(auto,force,off) است.
برای کسانی که به یک پشته کامل نیاز دارند، تنظیمات Docker Compose در دسترس است که API، Apache Tika و Tesseract را در یک کانتینر واحد جمع میکند تا پیشپردازش RAG در محیط عملیاتی آماده باشد. API را میتوان بهصورت محلی با دستور pdf-text-api serve --port 8000 اجرا کرد.
محدودیتهای موجود
اتکا به هندسه بهجای ML به معنای وجود برخی موارد خاص است. چیدمانهای بسیار نامنظم یا ماتریسهای ریاضی پیچیده و سیستمهای تراز شده ممکن است در خروجی LaTeX خطی شوند، هرچند تصویر ضمیمه بهعنوان جایگزین عمل میکند.
همچنین، جداول بدون حاشیه با فاصلههای بسیار کم بین ستونها ممکن است گاهی بهعنوان متن معمولی خوانده شوند. PDFهای اسکنشده همچنان به مسیر OCR سمت سرور نیاز دارند، زیرا Tesseract در مرورگر اجرا نمیشود. در برخی موارد، اگر تولیدکننده PDF نویسههای یک فونت ریاضی را تغییر شماره داده باشد، موتور پایتون ممکن است نمادی را گم کند که موتور مرورگر (که بر اساس نام نویسه میخواند) آن را میگیرد.
برای خروجیهای Word، هر صفحه در صفحه جداگانه خود حفظ میشود. چون Word خطوط را متفاوت از PDF میشکند، یک صفحه متراکم ممکن است گاهی چند خط به صفحه اضافی سرریز کند.
این رویکرد این فرض را تغییر میدهد که تجزیه با کیفیت بالای PDF نیازمند GPU است. Papero با اولویت دادن به هندسه و موتورهای سبک، مانع ورود برای پردازش محلی و خصوصی اسناد را از بین میبرد. این ابزار بهطور مؤثری «بار سنگین» را از مرحله استنتاج (Inference) به مرحله تحلیل هندسی منتقل میکند و جایگزینی ایدهآل برای توسعهدهندگانی است که سرعت و حریم خصوصی را بر انعطافپذیری مطلق مدلهای ML مبتنی بر بینایی ترجیح میدهند. این تمرکز بر پایداری ساختاری، مشابه رویکردی است که در راهکار Paper Office برای حذف ویرایش مستقیم XML و افزایش پایداری اسناد مشاهده میکنیم.
برای شروع، میتوانید مخزن گیتهاب را کلون کنید یا اپلیکیشن مرورگر را تست کنید تا ببینید اسناد خاص شما چگونه تجزیه میشوند.
گام بعدی شما
- اگر از خط لولههای RAG استفاده میکنید، Papero را جایگزین لودرهای مبتنی بر ML کنید تا سرعت پردازش اسناد را افزایش دهید.
- برای پروژههایی که حریم خصوصی دادهها حیاتی است، از نسخه مرورگر (Browser-based) این ابزار استفاده کنید.
- خروجی JSON را برای ایجاد سیستمهای ارجاع دقیق (Citation) به نقاط خاص صفحه در اپلیکیشن خود به کار ببرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو