اگر به دنبال مدل استدلالی هستید که روی سختافزار شخصی اجرا شود اما قدرت مدلهای ابری را داشته باشد، بازی تغییر کرده است. در ۱۵ اوت ۲۰۲۶، در نیمهشب به وقت ژاپن (JST)، گروه علیبابا (Alibaba Group) مدل Qwen3.8-27B را معرفی کرد؛ یک مدل متراکم و فشرده که تواناییهای استدلالی را که پیشتر فقط در مدلهای غولپیکر با تریلیونها پارامتر دیده میشد، به ابعاد کوچک آورده است. این رویکرد در راستای استراتژی جدید علیبابا برای توسعه مدلها با هدف رسیدن به هوش مصنوعی فوقبشر (ASI) قرار دارد که بر افزایش مقیاس و توانمندیهای استدلالی تأکید میکند.
این عرضه درست پس از معرفی مدل عظیم Qwen3.8-2.4T-A95B در ۱۲ اوت رخ داد. آن مدل پرچمدار که در Hugging Face منتشر شده، دارای تعداد خیرهکنندهای یعنی ۲.۴ تریلیون پارامتر است. در حالی که مدل ۲.۴ تریلیونی به عنوان یک معیار پیشرو عمل میکند — و بنچمارکهای استدلالی آن به مدل Kimi-K3 از شرکت Moonshot AI نزدیک شده است — نسخه ۲۷ میلیارد پارامتری دقیقاً برای جامعه مدلهای محلی (Local-LLM) طراحی شده است. این مدل تحت لایسنس Apache-2.0 منتشر شده که استفاده تجاری از آن را به صورت رایگان و بدون محدودیتهای سختگیرانه لایسنس Qwen3.8-Max (که معمولاً برای خدمات تجاری در مقیاس بزرگ نیازمند قراردادهای جداگانه است) فراهم میکند.
برخلاف بسیاری از مدلهای مدرن که از ساختار «ترکیب خبرهها» (Mixture-of-Experts یا MoE) و لایههای پراکنده استفاده میکنند، Qwen3.8-27B یک مدل متراکم (Dense) است. این یعنی در هر لحظه از پردازش هر توکن (Token) — مثل برشهای کوچکی از یک کیک طولانی که مدل تکهتکه میخورد — تمام پارامترها فعال میشوند. این طراحی معمولاً منجر به بهرهوری و قابلیت بالاتر در هر پارامتر میشود که نتایج آن در بنچمارکهای اخیر کاملاً مشهود است.
معماری توجه منحصربهفرد
این مدل از الگوهای رایج «توجه محلی و جهانی» (local + global) فاصله گرفته و در عوض، ترکیبی از شبکه دلتا گیتدار (Gated Delta Network یا GDN) و توجه گیتدار (Gated Attention یا GA) را به کار میگیرد.
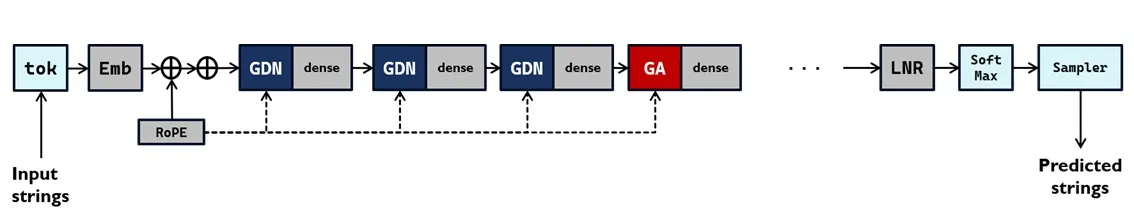
بر اساس مستندات فنی، GDN مسئول بهروزرسانی وضعیت و فشردهسازی اطلاعات است و ۷۵٪ لایههای توجه را تشکیل میدهد. ۲۵٪ باقیمانده لایههای توجه گیتدار هستند که در ساختار توجه پرسوجوی گروهی (Group Query Attention یا GQA) سازماندهی شدهاند و مدیریت تجمیع جهانی و بازیابی دقیق اطلاعات را بر عهده دارند. این چیدمان ابتدا در مدل Qwen3-Next-80B اتخاذ شد و سپس در نسخههای Qwen3.5 و Qwen3.6 نیز تداوم یافت.
به جای عبارت «محلی و جهانی»، توصیف دقیقتر برای این سازوکار «فشردهسازی و تجمیع» (compression + aggregation) است. تا جایی که ما میدانیم، خانواده Qwen در حال حاضر تنها خانواده مدلهای بزرگی است که از این رویکرد خاص استفاده میکند.
مشخصات فنی و محدودیتهای سختافزاری
بررسی فایل config.json در Hugging Face نشان میدهد این مدل از معماری Qwen3_5ForConditionalGeneration استفاده میکند. مشخصات کلیدی عبارتند از:
- حداکثر پنجره متنی (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد، شبیه میز کاری که جا برای چند ورق دارد — ۲۵۶ هزار توکن است (اگرچه در برخی محیطهای تست به ۶۴ هزار توکن محدود شده است).
- تعداد بلوکها: ۶۴ بلوک (با نسبت GDN به GA برابر با ۳ به ۱، متشکل از ۴ لایه در ۱۶ گروه).
- اندازه پنهان (Hidden Size): ۵,۱۲۰
- نوع FFN: متراکم (Dense)
- تابع فعالساز: SiLU
- بعد فعالساز (Activation Dimension): ۱۷,۴۰۸
این رویکرد «فشردهسازی و تجمیع» در حال حاضر منحصر به خانواده Qwen است. این ساختار به مدل اجازه میدهد عمق استدلال بالایی را حفظ کند، هرچند هزینه حافظه قابلتوجهی دارد. ردپای حافظه KV cache در این مدل به طور محسوسی بزرگتر از رقبایی مانند Muse Glimmer 30B یا Gemma-4-31B است.
اجرای محلی این مدل نیازمند مدیریت دقیق حافظه ویدیویی (VRAM) است. در یک محیط تست با استفاده از نمونه محاسباتی سریع GPUSOROBAN مجهز به NVIDIA RTX A4000 (۱۶ گیگابایت GDDR6)، نسخه کوانتیده ۴ بیتی با کمبود حافظه مواجه شد. مشخصات دقیق سیستم مورد استفاده به شرح زیر بود:
- GPU: NVIDIA RTX A4000 (16GiB GDDR6)
- پهنای باند حافظه: ۴۴۸.۰ گیگابایت بر ثانیه
- قدرت پردازشی: ۱۹.۱۷ TFLOPS (FP32)، ۳۸.۳۴ TFLOPS (BF16)، ۱۵۳.۴ TOPS (INT8)، ۳۰۶.۷ TOPS (INT4)
- سیستم: ۱۱ هسته vCPU، ۵۰ گیگابایت حافظه سیستم، Ubuntu 24.04 Server، CUDA 13.2، درایور NVIDIA نسخه ۵۸۰
برای جا دادن مدل در حافظه، استفاده از نسخه کوانتیده ۲ بیتی (Qwen3.8-27B-UD-Q2_K_XL.gguf با حجم ۱۲ گیگابایت) که با Unsloth Dynamic 2.0 بهینه شده بود، در کنار یک رمزگذار بینایی کوانتیده (mmproj-bf16.gguf با حجم ۸۸۹ مگابایت) ضروری بود. این تنظیمات از llama.cpp نسخه 0.1.0-dev (بیلد ۱۰۴۵۰، کامیت ece963f41) استفاده میکرد. سازگاری با بیلدهای موجود llama.cpp یک مزیت بزرگ است، زیرا معماری با Qwen3.5 سازگار باقی مانده است.
بیشترین فشار حافظه مربوط به KV Cache است. در حالت FP16 و با پنجره متنی ۶۵,۵۳۶ توکن، این حافظه ۴,۰۹۶ مگابایت اشغال میکند. اگر بخواهیم از ظرفیت کامل ۲۶۲,۱۴۴ توکن استفاده کنیم، تنها برای حافظه کش به ۱۶,۳۸۴ مگابایت VRAM نیاز داریم، بدون اینکه وزنهای مدل را حساب کنیم. در حالت استاندارد، کل حافظه اشغال شده روی RTX A4000 برابر با ۱۳,۸۹۷.۵۳ مگابایت بود که ۹,۵۶۷.۸۹ مگابایت آن مربوط به دادههای وزن مدل بود.
مقایسه حافظه کش (KV Cache)
سربار حافظه در Qwen3.8-27B به دلیل طراحی غنی لایههای تجمیع است. در مقایسه با سایر مدلهای هیبریدی:
- Muse Glimmer 30B: از SWA+Global (۳:۱) با ۱۳ لایه تجمیع (۲ هد در ۱۲۸ بعد) استفاده میکند. حافظه کش برای ۱۲۸ هزار توکن ۱,۷۴۲ مگابایت است. هدف طراحی: استنتاج سبک.
- Gemma-4-31B: از SWA+Global (۵:۱) با ۱۰ لایه تجمیع (۴ هد در ۵۱۲ بعد) استفاده میکند. حافظه کش برای ۱۲۸ هزار توکن ۵,۹۲۰ مگابایت است. هدف طراحی: تعادل بین استدلال و حافظه.
- Qwen3.8-27B: از GDN+Global (۳:۱) با ۱۶ لایه تجمیع (۴ هد در ۲۵۶ بعد) استفاده میکند. حافظه کش برای ۱۲۸ هزار توکن ۸,۱۹۲ مگابایت است. هدف طراحی: استدلال پیشرفته.
این اعداد نشان میدهد علیبابا پاسخهای عمیق و قابلاعتماد را به سرعت و سبکی استنتاج ترجیح داده است. شبکه دلتا گیتدار به تنهایی کارآمد است، اما تکرار بالای لایههای Global و طراحی غنی KV، نیازهای حافظه را به شدت افزایش داده است.
منطق تفکر و عملکرد استدلالی
یکی از چشمگیرترین تغییرات، فرآیند استدلال داخلی مدل است. مدلهای قبلی Qwen به داشتن یک صدای داخلی «تردیدآمیز» معروف بودند و اغلب در مرحله تفکر، منطق خود را زیر سؤال میبردند. Qwen3.8-27B تا حد زیادی از این وضعیت عبور کرده است.
در llama.cpp پارامتر جدید reasoning_effort اجازه میدهد عمق تفکر را از طریق پرامپت سیستمی کنترل کنید. سطوح پشتیبانی شده عبارتند از:
- xhigh (پیشفرض): پرامپتی را تزریق میکند تا مدل با دقت فکر کند، مفروضات را اعتبارسنجی نماید، جایگزینها را بررسی کند و صحت و شفافیت را در اولویت قرار دهد.
- medium: هیچ پرامپت سیستمی تزریق نمیشود.
- low: پرامپتی را تزریق میکند تا تفکر کوتاه و متمرکز باشد و مستقیماً به نتیجه برسد.
تحلیل بخش تفکر مدل نشان میدهد که فرآیند کاملاً منطقی است. مدل زبان تفکر (انگلیسی) را از زبان خروجی (مثلاً ژاپنی) جدا میکند، استنتاج متنی را از زوایای مختلف انجام میدهد و در لحظه خوداصلاحی میکند. به عنوان مثال، وقتی از مدل درباره شرایط زمین در کیوشو پرسیده شد، مدل ابتدا شروع به نوشتن «میاگی» کرد اما بلافاصله آن را به «میازاکی» اصلاح کرد.
همچنین مدل طوفان فکری جامع برای دانش انجام میدهد، کلمات کلیدی را بر اساس منطقه و زمینشناسی لیست میکند و ساختار خروجی (مثلاً انتخاب بین جدول یا لیست گلولهای) را پیش از نهایی کردن پاسخ، به صورت تکرار شونده شبیهسازی میکند. این فرآیند «بسیار منطقی» توصیف شده و فاقد لحن احساسی منفی است که در Qwen3.5 دیده میشد.
متدولوژی آموزش: فراتر از راهاندازی سرد
این پیشرفت نتیجه تغییر در روش آموزش است. تیم Qwen از متد «راهاندازی سرد زنجیره تفکر طولانی» (Long CoT Cold Start) که در DeepSeek-R1 استفاده شده بود، فاصله گرفته است؛ چرا که آن روش اغلب نویزهای احساسی از دادههای فرومهایی مثل ردیت (Reddit) را وارد لحن مدل میکرد. این تمایل به «راهاندازی سرد» باعث میشد مدلها در میانه استدلال متوقف شده و دوباره از صفر شروع کنند.
به جای آن، آنها از یک معیار ارزیابی داده بدون نیاز به آموزش به نام High-Entropy Sum (HES) در مراحل SFT، RFT و RL استفاده کردند. HES مانع از این میشود که نقاط تصمیمگیری مهم توسط متون کلیشهای و کمارزش (boilerplate) رقیق شوند و به مدل اجازه میدهد راهکارهای باکیفیت را بهینهتر یاد بگیرد.
علاوه بر این، مدل پرچمدار Qwen3.8-Max از سیستمهای RL مقیاسبندی شده در دنیای واقعی، یک سیستم پاداش عمومی برای اعتبارسنجیهای متنوع و یک متعادلکننده دادههای آنلاین برای ارتقای توانایی تکمیل وظایف در زنجیرههای ابزاری استفاده کرد. این نشان میدهد دستاوردهای مدل ۲۷ میلیارد پارامتری صرفاً نتیجه تقطیر (Distillation) از مدلهای پیشرو نیست، بلکه تکاملی واقعی در طراحی خط لوله آموزش است. همچنین احتمالاً تیم سازنده مشکل «بیشفکری» (overthinking) را که در تحقیقات اخیر روی تردیدهای خودکار در زنجیره تفکر طولانی شناسایی شده بود، برطرف کرده است.
قابلیتهای چندوجهی
مدل Qwen3.8-27B دارای یک رمزگذار بینایی بر اساس معماری SigLIP2-SO-400M است. در تستهای عملی، این مدل توانست نمودارهای فنی پیچیده را با دقت بالا تحلیل کند. این توانمندی در پردازش بصری، یادآور موفقیتهای قبلی علیبابا در این حوزه است، مانند زمانی که مدل Qwen-Image-2.1 با ۷ میلیارد پارامتر توانست مدلهای بسته را در تحلیل تصاویر شکست دهد. فعال کردن رمزگذار بینایی، مصرف حافظه را تقریباً ۱,۳۳۶ مگابایت افزایش میدهد و مجموع آن را روی RTX A4000 به ۱۵,۳۶۹.۵۱ مگابایت میرساند.
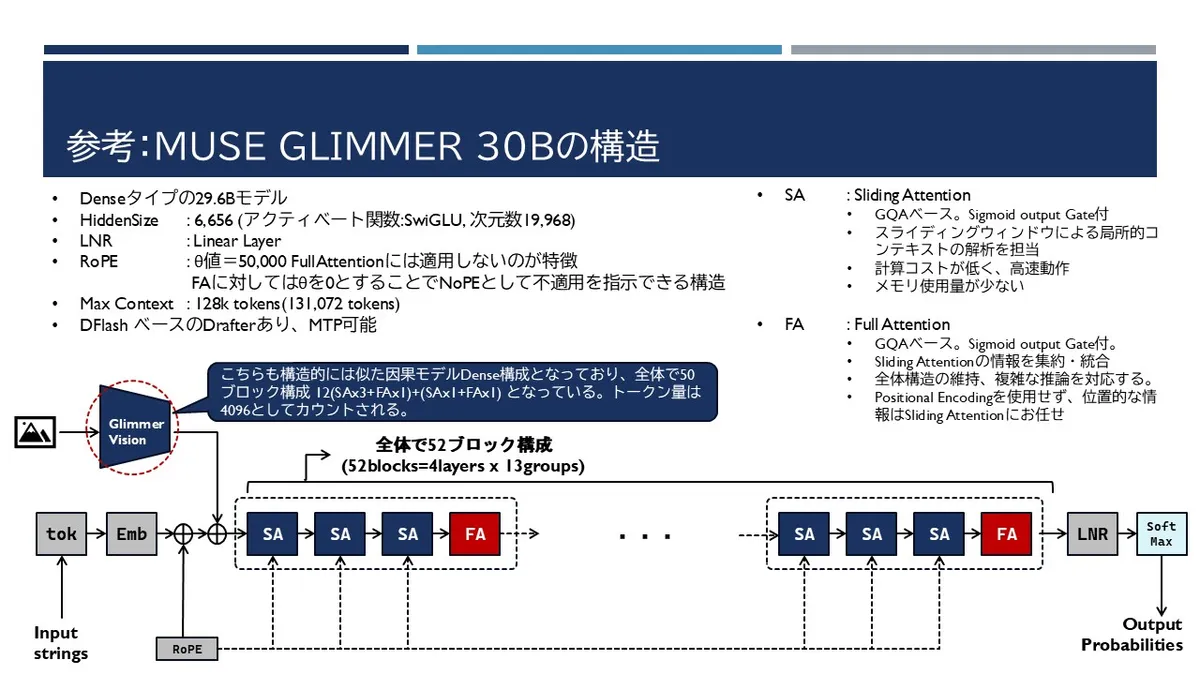
در تحلیل یک نمودار معماری Muse Glimmer، مدل نه تنها مشخصات فنی را درست استخراج کرد، بلکه یک تناقض در برچسبهای تصویر را هم شناسایی کرد؛ جایی که برچسب نمودار «پیکربندی ۵۲ بلوکی» را نوشته بود اما در توضیحات کنار آن «۵۰ بلوک» ذکر شده بود. مدل به درستی استدلال کرد که عدد ۵۲ احتمالاً شامل لایههای بینایی است و عدد ۵۰ فقط مربوط به لایههای رمزگشای متن است. حتی یک غلط تایپی احتمالی را شناسایی کرد و اشاره کرد که عبارت «بدون اطلاعات موقعیتی» احتمالاً به معنای «بدون کدگذاری موقعیتی» (no positional encoding) است.
این سطح از جزئیات از مدلهای کلاس ۳۰ میلیارد پارامتری قبلی پیشی گرفت و پاسخی تولید کرد که تقریباً دو برابر طولانیتر از پاسخ Muse Glimmer 30B برای همان وظیفه بود. استدلال رمزگذار بینایی به طور محسوسی توانمندتر به نظر میرسید که احتمالاً به دلیل تنظیم دقیق (fine-tuning) اضافی است.
بنچمارکها: جهش در هوش
ارزیابیهای شخص ثالث نشاندهنده جهشی بزرگ است. در شاخص هوش Artificial Analysis، مدل Qwen3.8-27B با فعال بودن حالت تفکر، امتیاز ۵۲ را کسب کرد.
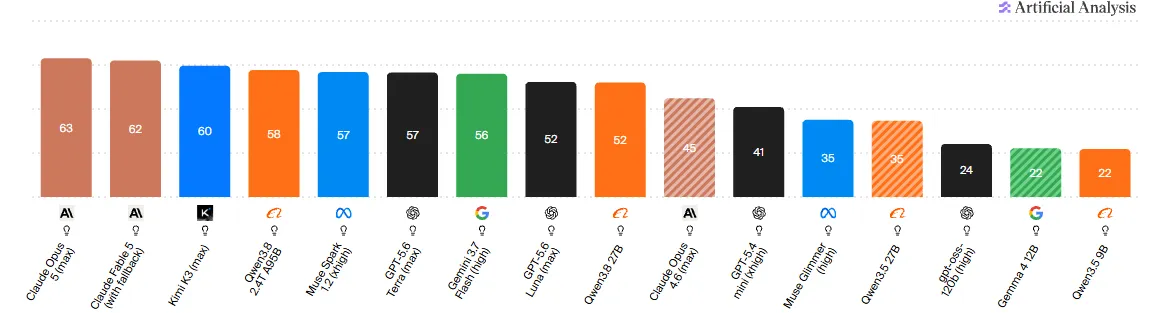
این امتیاز آن را با GPT-5.6 Luna برابر و از Claude Opus 4.6 پیشی میدهد. در وظایف کدنویسی ایجنتی، امتیاز ۷۳ را در Terminal Bench 2.1 کسب کرد که به طور قابل توجهی از امتیاز ۵۱.۷ مدل Muse Glimmer 30B بالاتر است. سایر بنچمارکهای قابل توجه عبارتند از:
- GPQA Diamond (استدلال علمی): ۸۹.۲ (در برابر ۸۳.۵ Muse Glimmer)
- LiveCodeBench v6 (کدنویسی رقابتی): ۹۰.۳ (در برابر ۸۸.۸ Opus 4.6)
- IFBench (پیروی از دستورات): ۷۹.۵ (در برابر ۶۲.۵ Opus 4.6)
- CoWorkBench (کارهای اداری): ۷۰.۷ (در برابر ۶۱ مدل Qwen3.6-27B)
- Agents' Last Exam (امتیاز): ۴۲.۹ (در برابر ۲۷.۳ مدل Qwen3.6-27B)
- DeepSWE 1.1 (کدنویسی ایجنتی): ۴۲.۲ (در برابر ۱۳.۳ مدل Qwen3.6-27B)
- HLE (استدلال چندرشتهای): ۳۰.۸ (در برابر ۲۲ مدل Muse Glimmer)
البته این هوش به قیمت کاهش سرعت تمام شده است. در تستها، تعداد توکنهای مصرفی Qwen3.8-27B برای رسیدن به پاسخ، تقریباً سه برابر Muse Glimmer بود. مدل Qwen3.8-27B زمان کل ۲۴۸,۶۷۹ میلیثانیه را برای ۵,۸۳۵ توکن ثبت کرد (۲۳.۲۳ توکن بر ثانیه)، در حالی که Muse Glimmer برای ۱,۹۳۴ توکن به ۸۳,۱۳۶ میلیثانیه زمان نیاز داشت (۲۲.۵۲ توکن بر ثانیه).
تحلیل تحریریه
برای متخصصان هوش مصنوعی محلی، Qwen3.8-27B توازن بین اندازه و هوش را تغییر میدهد. ما شاهد روندی هستیم که در آن «فشرده» دیگر به معنای «سازش» یا «ضعیفتر بودن» نیست. علیبابا با اولویت دادن به قابلیت استدلال خام نسبت به استنتاج سبک، ابزاری ایدهآل برای تحقیقات عمیق (Deep Research) و جریانهای کاری پیچیده ایجنتی خلق کرده است.
با این حال، نیاز بالای VRAM برای متون طولانی همچنان یک گلوگاه است. کاربران باید بین استدلال با دقت بالا (KV cache در حالت FP16) و پنجرههای متنی طولانیتر (KV cache کوانتیده) یکی را انتخاب کنند. برای مثال، استفاده از کوانتیزاسیون q8_0 یا turbo3 میتواند حافظه کش ۱۳۱ هزار توکنی را از ۸,۱۹۲ مگابایت به ترتیب به ۴,۰۹۶ مگابایت یا ۲,۹۷۶ مگابایت کاهش دهد. برای پنجره کامل ۲۶۲ هزار توکنی، متد turbo3 میتواند حجم کش را به ۵,۹۵۲ مگابایت برساند.
حکم نهایی
پیروزی واقعی در اینجا مربوط به بهرهوری آموزش است؛ فاصله گرفتن از آموزش Long-CoT با روش «راهاندازی سرد»، نشاندهنده رویکردی بالغتر به یادگیری تقویتشده (RL) است که نویزهای احساسی را در منطق مدل کاهش میدهد. این تغییر، در کنار معیار HES، نشان میدهد که دستاوردهای مدل صرفاً نتیجه تقطیر از مدلهای پیشرو نیست، بلکه تکاملی واقعی در طراحی خط لوله آموزش است.
اگر در حال ساخت خط لولههای RAG یا ایجنتهای خودمختار هستید، باید مهندسی پرامپت خود را بازنگری کنید. ساختار منطقی استدلال Qwen3.8 اساساً با Qwen3.5 متفاوت است، به این معنی که پرامپتهای قدیمی ممکن است دیگر همان رفتار را تحریک نکنند. منتظر واکنش جامعه به سربار KV cache باشید. اگر متدهای کوانتیزاسیون جدید بتوانند حجم کش را بدون از بین بردن عمق استدلال کاهش دهند، Qwen3.8-27B میتواند به ستون فقرات پیشفرض برای سیستمهای ایجنتی محلی تبدیل شود.



گفتگو