اگر امروز با خطاهای Out-Of-Memory در تحلیل دادههای حجیم روی GPU دستوپنجه نرم میکنید، استاندارد جدید توان عملیاتی تغییر کرده است. سیستم DGX B200 اکنون میتواند دادهها را با سرعت خیرهکننده ۱.۸ ترابایت بر ثانیه جابهجا کند.
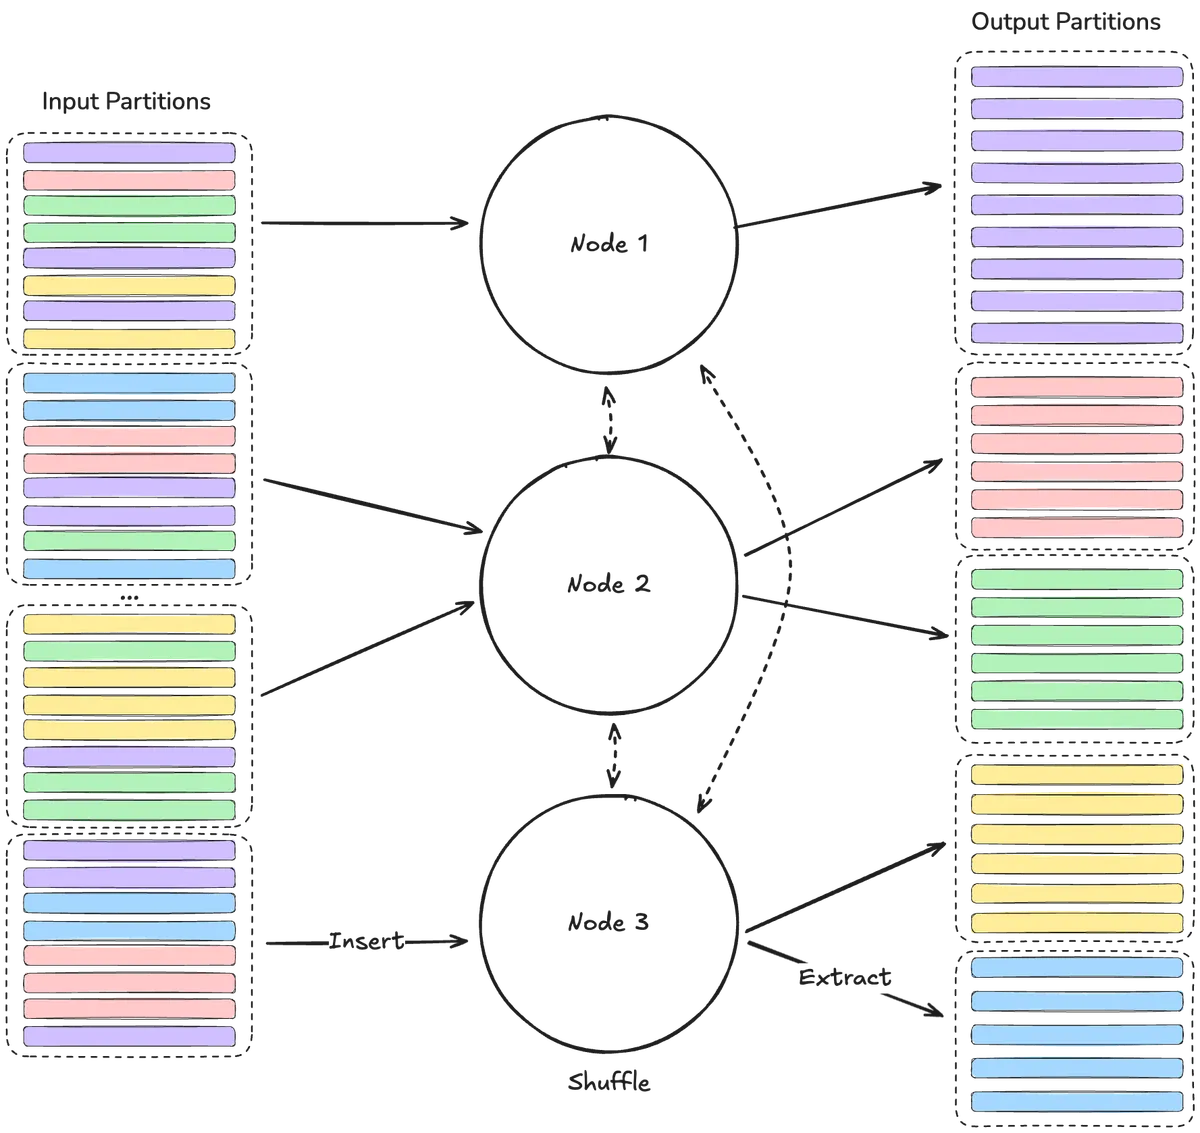
طبق گزارش فنی منتشر شده در ۲۵ سپتامبر ۲۰۲۶ توسط بنجامین زایتلن (Benjamin Zaitlen)، این دستاورد نشاندهنده تغییری بنیادین در نحوه مدیریت فرآیند «شافل» (Shuffle) یا همان جابهجایی دادههای ساختاریافته برای عملیات Join و Sort است. شافل گرانترین بخش تحلیل دادههای ساختاریافته است؛ زیرا دادهها باید از هر پردازش به تمام پردازشهای دیگر منتقل شوند. این عملیات «همه-به-همه» (all-to-all) بهندرت فشار محاسباتی ایجاد میکند — زیرا محاسبه هشها برای مسیریابی دادهها نسبتاً ارزان است — اما یک کابوس حافظه است. اگر حجم دادهها از حافظه ویدیویی (VRAM) — که شبیه به یک میز کار کوچک اما بسیار سریع است — بیشتر شود، اکثر سیستمها به سادگی با خطای OOM متوقف میشوند.
همانطور که در تحلیلهای قبلی ما درباره بهینهسازی زیرساختهای پردازشی اشاره کردیم، گلوگاه اصلی همواره تعادل بین سرعت پردازش و ظرفیت حافظه بوده است. در این راستا، RapidsMPF یک شافلکننده «خارج از حافظه» (Out-of-core) معرفی کرده است که قابلیت استفاده مجدد دارد. این ابزار فشار حافظه را نه به عنوان یک خطای مرگبار، بلکه به عنوان یک «بودجه» برای انتقال داده به حافظه میزبان (Host Memory) یا همان Spill میبیند. به این ترتیب، توسعهدهندگان میتوانند مجموعهدادههایی را پردازش کنند که بسیار بزرگتر از حافظه فیزیکی GPUهای آنهاست، بدون اینکه سیستم دچار لرزش (Thrashing) شود یا شکست بخورد.
چرا شافل کردن هزینهبر است؟
به نقل از مستندات فنی انویدیا، سه دلیل اصلی برای هزینهبر بودن شافل در یک جریان کاری وجود دارد:
- فشار شدید حافظه: شافل اغلب نیاز به نگهداری نسخهای کامل از تمام دادهها دارد. در موارد استریمینگ، فشار حافظه به سرعت افزایش مییابد و منجر به خطاهای OOM میشود.
- انتقال داده: دادهها باید به صورت فیزیکی از پردازش A به پردازش B یا از گره A به گره B منتقل شوند، به این معنی که عملکرد توسط سرعت لایه انتقال محدود میشود.
- همگامسازی: در موتورهای پردازشی Bulk-Synchronous، دادههای خروجی تا زمانی که تمام تولیدکنندگان کارشان تمام نشود، قابل مصرف نیستند. این سد (Barrier) میتواند کل برنامه اجرا را متوقف کند.
مکانیسم Join توزیعشده
برای درک اهمیت این موضوع، یک Inner Join استاندارد بین دو جدول، مانند partsupp و lineitem را تصور کنید. در یک محیط تکحافظهای، سیستم از یک رویکرد دو مرحلهای استفاده میکند:
۱. مرحله ساخت (Build): جدول کوچکتر (partsupp) اسکن شده تا یک جدول هش روی کلیدهای Join (مثلاً ps_partkey و ps_suppkey) ساخته شود و هر کلید هش شده به ردیف مربوطه نگاشت شود. این جدول هش باید پیش از شروع مرحله بعد، کاملاً پر شود.
۲. مرحله جستوجو (Probe): جدول بزرگتر (lineitem) اسکن شده و کلیدهای آن هش میشوند. تطابق بین هشهای ساخت و جستوجو منجر به تولید یک ردیف خروجی میشود و ردیفهای بدون تطابق حذف میشوند.
لازم به ذکر است که Joinهای Left، Right و Full Outer نیز از همین استراتژی Build/Probe استفاده میکنند، هرچند قوانین متفاوتی برای ردیفهای تطبیقنیافته دارند. در کمترین حالت، یک Join در حافظه باید جدول ساخت، جدول جستوجو، جدول خروجی و جدول هش ساخته شده روی سمت ساخت را در خود نگه دارد. این بهینهسازیهای الگوریتمی در سطح حافظه یادآور تلاشهای اخیر برای افزایش سرعت مرتبسازی است، مشابه آنچه در رویکرد جدید گوگل برای بهینهسازی Quicksort مشاهده شد تا محدودیتهای سختافزاری با الگوریتمهای هوشمندتر برطرف شوند.
در یک سیستم توزیعشده، کلیدهای مشابه باید ابتدا به یک رنک (Rank) یا گره منتقل شوند. برای اجرای یک Distributed Hash-Join، سیستم باید مراحل زیر را طی کند:
- اسکن جدول ساخت و هش کردن کلیدهای Join برای انتخاب پارتیشن مقصد با استفاده از فرمول
hash(keys) % n_out_partitions. - بستهبندی (Pack) و ارسال هر ردیف به رنکی که مالک آن خواهد بود.
- اسکن جدول جستوجو و مسیریابی ردیفها به همان روش، تا کلیدهای جستوجو در رنکی قرار گیرند که کلیدهای ساخت مربوطه را در اختیار دارد.
- انتظار تا زمانی که هر رنک ارسالها را به پایان برساند تا تضمین شود که رنک، تمام ردیفهای مربوط به کلیدهای تحت مالکیت خود را دریافت کرده است.
- اجرای Join در حافظه روی برش (Slice) محلی هر رنک.
این فرآیند نیازمند چندین تخصیص حافظه همزمان است. در بدترین حالت، اگر هر مرحله کاملاً متریالیزه شود، یک رنک موارد زیر را نگه میدارد:
- جدول ساخت (اسکن منبع)
- جدول جستوجو (اسکن منبع)
- جدول ساخت مرحلهبندی شده (بستهبندی شده برای ارسال)
- جدول جستوجو مرحلهبندی شده (بستهبندی شده برای ارسال)
- برش شافلشده ساخت (دریافت شده)
- برش شافلشده جستوجو (دریافت شده)
- جدول هش روی برش ساخت
- جدول خروجی
از آنجایی که یک رنک ممکن است به طور گذرا هم دادههای اصلی و هم نسخه شافلشده را نگه دارد، مصرف حافظه میتواند تا ۳ برابر حجم دادههای ورودی افزایش یابد. به همین دلیل RapidsMPF به جای تمرکز صرف بر سرعت محاسبات، روی استریمینگ و مدیریت خارج از حافظه تمرکز کرده است.
محک زدن B200
زایتلن این کتابخانه را با استفاده از ابزار bench_shuffle روی یک سیستم DGX B200 مجهز به هشت GPU بلکول (هر کدام ۱۸۰ گیگابایت VRAM) و دو پردازنده Intel Xeon Platinum 8570 آزمایش کرد. در این بنچمارک از rrun (یک ابزار لانچ چندپردازشی شبیه به MPI که قادر به متصل کردن پردازشها به گرههای NUMA است) و همچنین UCXX/UCX برای انتقال شتابیافته و GPUDirect RDMA استفاده شد.
تنظیمات این محک برای ایجاد یک خط مبنا (Baseline) به شرح زیر بود:
- تعداد ردیفها در هر رنک (-n): ۵۳۶,۸۷۰,۹۱۲ ردیف (که منجر به ۲ گیگابایت برای هر ستون با نرخ ۴ بایت به ازای هر ردیف میشود).
- تعداد ستونها (-c): ۱۰ ستون (مجموعاً ۲۰ گیگابایت برای هر رنک، یا ۱۶۰ گیگابایت در مجموع ۸ رنک).
- پارتیشنها: ۱ پارتیشن ورودی به ازای هر رنک (-p) که به ۸ پارتیشن خروجی (-o) شافل شد.
- تعداد اجراها: ۳ دور گرمکردن (-w) و ۱۰ دور زمانسنجی (-r).
- حافظه: از استخر منابع حافظه RMM استفاده شد و محدودیت حافظه دستگاه در ابتدا نامحدود بود.
- پرچمها: قابلیت حذف خروجی (
-s) برای شبیهسازی استریمینگ و پروفایلینگ حافظه (-x) فعال بود.
در این تست پایه، سیستم به توان عملیاتی جهانی ۱.۸ ترابایت بر ثانیه رسید. پروفایلینگ حافظه نشان داد در حالی که هر رنک ۲۰ گیگابایت ورودی داشت، اوج مصرف حافظه دستگاه به ۶۰ گیگابایت رسید. به طور مشخص، ۲۰ گیگابایت برای ورودی و ۴۰ گیگابایت در مرحله partition_and_pack مصرف شد، زیرا دادهها هش شده و در بافرهای مقصد کپی میشدند.
پروفایل دقیق حافظه
تحلیل لاگهای bench_shuffle برای رنک ۰ توزیع حافظه زیر را نشان میدهد:
- main (RmmResourceAdaptor): اوج مصرف ۶۰ گیگابایت / مجموع انباشته ۱.۲۹ ترابایت.
- partition_and_pack: اوج مصرف ۴۰ گیگابایت / مجموع انباشته ۴۴.۰۶ گیگابایت.
- split_and_pack: اوج مصرف ۲۰ گیگابایت / مجموع انباشته ۲۰ گیگابایت.
- unpack_and_concat: اوج مصرف ۲.۵۰ گیگابایت / مجموع انباشته ۲۰ گیگابایت (۸ بار اجرا شده است).
تخلیه هوشمند و گلوگاه PCIe
آزمون واقعی زمانی رخ داد که محدودیت حافظه به صورت مصنوعی کاهش یافت. با پایین آوردن محدودیت حافظه دستگاه از حالت نامحدود به ۱۲ گیگابایت، تیم مشاهده کرد که سیستم چگونه با «تخلیه» (Spilling) برخورد میکند.
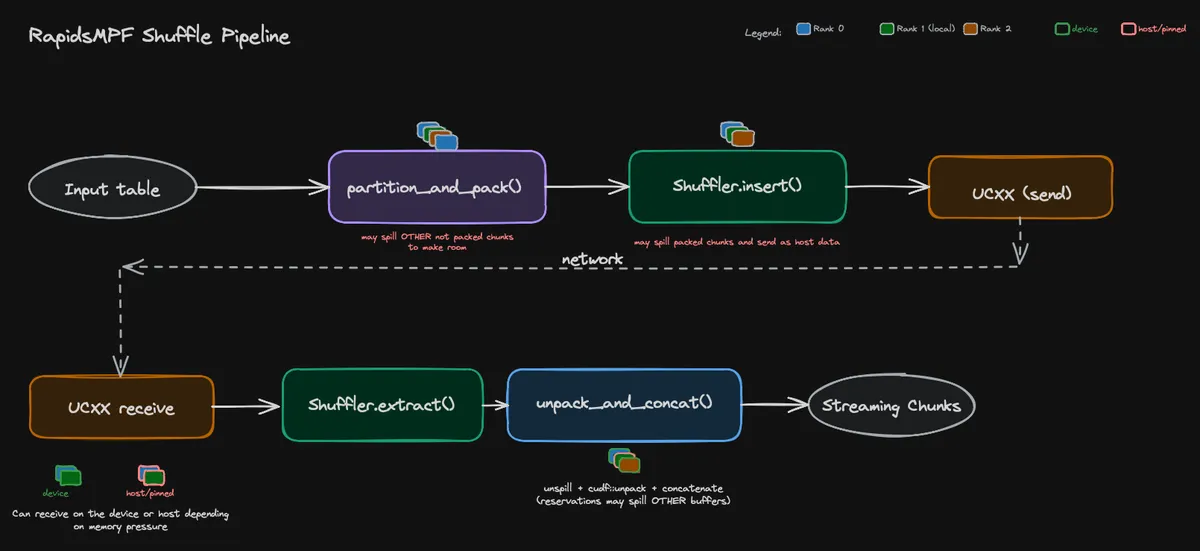
وقتی محدودیت حافظه روی ۳۲ گیگابایت (-l 32768) تنظیم شد، سیستم کرش نکرد. در عوض، RapidsMPF از UCXX استفاده کرد تا فشار حافظه را در سمت دریافت رصد کند. سیستم به جای انتقال داده به GPU و سپس بیرون راندن آن به میزبان (که باعث Thrashing میشود)، بافرها را مستقیماً در حافظه میزبان پذیرفت. این موضوع با ظهور alloc-pinned_host (۵.۶۲ گیگابایت) و copy-pinned_host-to-device (۵.۶۲ گیگابایت) در آمارها تایید شد، در حالی که مقدار copy-device-to-pinned_host روی صفر باقی ماند.
این روش «تخلیهای که هرگز نیاز به تخلیه ندارد»، بهینهترین راه مدیریت فشار حافظه است. اما یک گلوگاه سختافزاری را معرفی میکند: گذرگاه PCIe Gen 5. در حالی که سرعتهای داخلی B200 عظیم است، انتقال داده از میزبان به دستگاه بهطور متوسط حدود ۳۲ گیگابایت بر ثانیه برای هر GPU بود. از یک اجرای ۳۳۵.۱۵ میلیثانیهای، ۱۷۱.۸ میلیثانیه صرف انتقال ۵.۶۲ گیگابایت داده به دستگاه شد.
نتایج مقیاسبندی تخلیه
با کاهش بیشتر محدودیت حافظه، افت عملکرد به صورت نرم و یکنواخت (Monotonic) باقی ماند:
- بدون تخلیه (∞ گیگابایت): توان عملیاتی جهانی ۱.۷۹ ترابایت بر ثانیه | اوج حافظه دستگاه ۶۰ گیگابایت.
- شروع تخلیه (۳۲ گیگابایت): ۴۸۰.۲ گیگابایت بر ثانیه | حجم D2H صفر | حجم H2D ۵.۶ گیگابایت (۱۹۱.۴ میلیثانیه / ۲۹.۴ گیگابایت بر ثانیه).
- تخلیه سبک (۲۸ گیگابایت): ۲۸۷.۰ گیگابایت بر ثانیه | حجم D2H صفر | حجم H2D ۹.۷ گیگابایت (۳۷۹.۰ میلیثانیه / ۲۵.۶ گیگابایت بر ثانیه).
- تخلیه متوسط (۲۴ گیگابایت): ۲۱۱.۷ گیگابایت بر ثانیه | حجم D2H صفر | حجم H2D ۱۳.۸ گیگابایت (۴۹۱.۰ میلیثانیه / ۲۸.۰ گیگابایت بر ثانیه).
- تخلیه شدید (۲۰ گیگابایت): ۱۱۸.۶ گیگابایت بر ثانیه | حجم D2H ۰.۳ گیگابایت | حجم H2D ۱۷.۵ گیگابایت (۶۲۲.۳ میلیثانیه / ۲۸.۱ گیگابایت بر ثانیه).
- تخلیه بسیار شدید (۱۶ گیگابایت): ۸۰.۵ گیگابایت بر ثانیه | حجم D2H ۴.۱ گیگابایت | حجم H2D ۱۸.۱ گیگابایت (۱۳۴۰.۰ میلیثانیه / ۱۳.۵ گیگابایت بر ثانیه).
- تخلیه حداکثری (۱۲ گیگابایت): ۵۵.۵ گیگابایت بر ثانیه | حجم D2H ۸.۱ گیگابایت | حجم H2D ۱۸.۸ گیگابایت (۱۱۷۰.۰ میلیثانیه / ۱۶.۱ گیگابایت بر ثانیه).
تخلیه واقعی از دستگاه به میزبان (Device-to-Host) تنها در محدودیت ۲۰ گیگابایت فعال شد، جایی که محدودیت با اندازه ورودی برابر بود. گزارش اشاره میکند که انتقال به پیکربندی Grace-Blackwell با اتصالات C2C (Chip-to-Chip) میتواند پهنای باند میزبان به دستگاه را ۵ تا ۱۰ برابر افزایش داده و به ۹۰۰ گیگابایت بر ثانیه برساند.
یکپارچگی با اکوسیستم
RapidsMPF تنها یک ابزار مستقل نیست؛ بلکه در حال ادغام در اکوسیستم گستردهتر AI و داده است. این سیستم در حال حاضر از دو بخش بزرگ تشکیل شده است:
۱. کتابخانه Shuffle: طراحی شده برای تخلیه و مدیریت حافظه خارج از هسته با انتقال شتابیافته.
۲. شبکه Actor: مورد استفاده برای ساخت خط لولههای داده استریمینگ.
پذیرشهای کلیدی شامل موارد زیر است:
- cuDF Polars: از هر دو جزء Shuffle و Actor Network استفاده میکند.
- NeMo-Curator: از جزء شافل برای کیوریشن دادهها بهره میبرد.
- Ray Data: در حال حاضر این کتابخانه را به صورت تجربی تست میکند.
تحلیل: جابهجایی گلوگاه
برای مهندسان داده، این موضوع فرض بنیادین محاسبات GPU را تغییر میدهد. از نظر تاریخی، GPU یک فضای حافظه «سریع اما کوچک» بود. اگر مجموعهداده شما جا نمیشد، مجبور بودید دادهها را به صورت دستی تکه تکه (Chunk) کنید یا به موتورهای کندتر مبتنی بر CPU بروید.
RapidsMPF به طور موثری GPU را به یک حافظه کش (Cache) برای استخر بزرگتر حافظه میزبان تبدیل میکند. با خودکارسازی منطق تخلیه و دریافت، بار دستی مدیریت حافظه را حذف میکند. گلوگاه از «آیا این سیستم کرش میکند؟» به «سرعت گذرگاه PCIe من چقدر است؟» تغییر یافته است.
این امر لینک C2C در معماری Grace-Blackwell را به یک زیرساخت حیاتی تبدیل میکند. توانایی جابهجایی داده با سرعت ۹۰۰ گیگابایت بر ثانیه بین CPU و GPU همان چیزی است که در نهایت باعث میشود شافل خارج از حافظه، به اندازه شافل در حافظه سریع به نظر برسد.
برای مشاهده این قابلیتها در عمل، توسعهدهندگان میتوانند لاگهای scaled-spilling-b200 را بررسی کنند یا رابطهای C++/Python کتابخانه RapidsMPF را در خط لولههای ETL خود پیادهسازی کنند.
گام بعدی شما
- اگر از خط لولههای ETL سنگین استفاده میکنید، رابطهای C++/Python کتابخانه RapidsMPF را برای حذف خطاهای OOM بررسی کنید.
- در طراحی زیرساختهای آینده، به جای افزایش صرف VRAM، روی پهنای باند اتصال CPU به GPU (مانند C2C) سرمایهگذاری کنید.
- لاگهای
scaled-spilling-b200را برای تحلیل رفتار سیستم در شرایط کمبود حافظه مطالعه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو