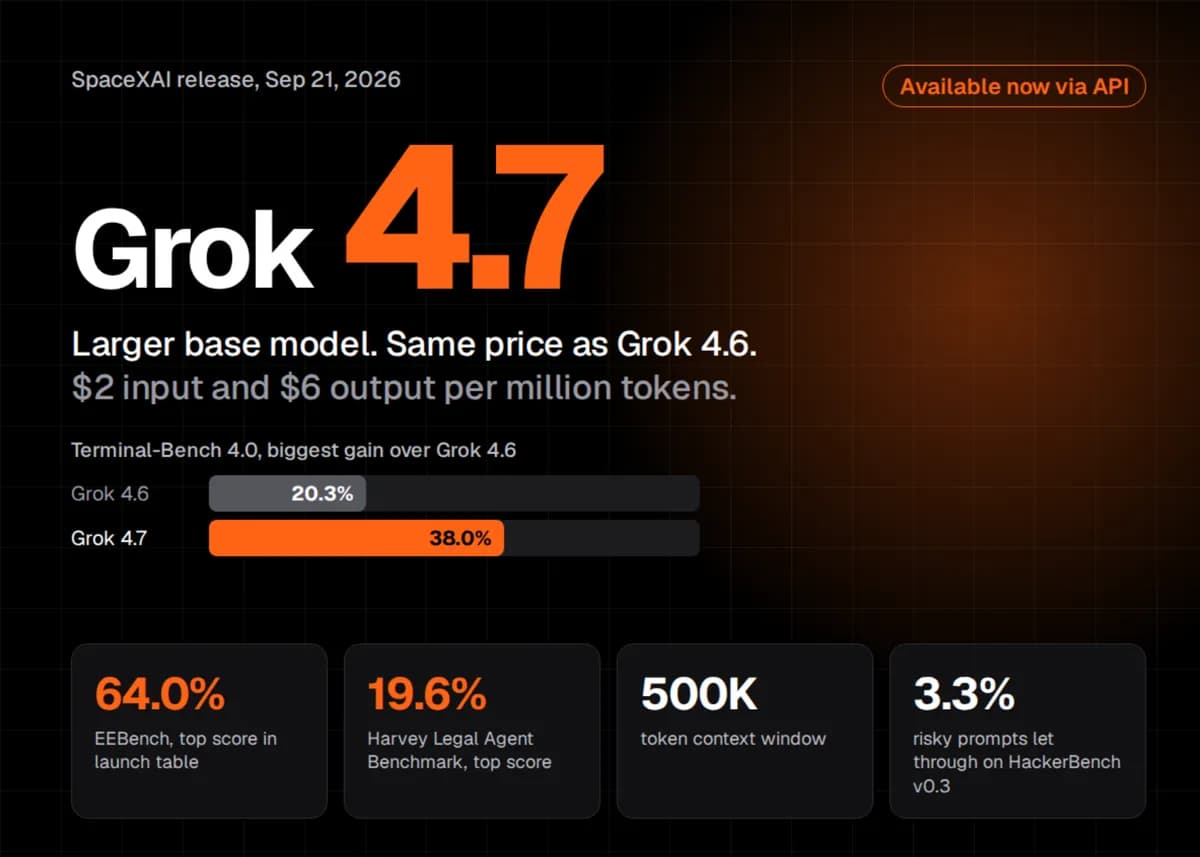
اگر امروز برای استنتاج از مدلهای پیشرفته هزینه میپردازید، SpaceXAI با یک حرکت جسورانه، معادلهی قیمت و عملکرد را تغییر داده است. مدل جدید Grok 4.7 در محک EEBench به امتیاز ۶۴٪ رسید، در حالی که قیمت آن دقیقاً مشابه نسل قبلی باقی مانده است. این مدل که در ۲۱ سپتامبر منتشر شد، بهطور خاص برای کارهای دانشی حرفهای، گردشهای کاری عاملمحور (Agentic) و برنامهنویسی سطح بالا طراحی شده است، بدون آنکه هزینهای اضافی بر کاربران API تحمیل کند.
این بهروزرسانی در حالی رخ میدهد که کل صنعت به سمت مدلهای استدلالی (Reasoning Models) حرکت میکند؛ مدلهایی که محاسبات زمان استنتاج (test-time compute) را بر پیشبینی سادهی توکن بعدی اولویت میدهند. SpaceXAI با حفظ قیمت ۲ دلار برای هر میلیون توکن ورودی و ۶ دلار برای هر میلیون توکن خروجی، در تلاش است تا قابلیتهای استدلالی سطح بالا را که معمولاً توسط رقبا با قیمتهای ممتاز (Premium) عرضه میشوند، به یک کالای ارزانقیمت و در دسترس تبدیل کند.
همانطور که در تحلیلهای پیشین ما دربارهی رقابت مدلهای استدلالی اشاره کردیم، کاهش هزینه در کنار افزایش دقت، خطرناکترین استراتژی برای رقبایی است که قیمتهای بالا دریافت میکنند.
Grok 4.7 اکنون به صورت مدل میزبانیشده در دسترس است. کاربران میتوانند همین امروز از طریق APIهای xAI، Cursor، Grok Build، OpenRouter، Vercel و Cloudflare از این مدل استفاده کنند. برای کاربرانی که نیاز به اقامت دادهای خاص دارند، یک نقطه اتصال (Endpoint) منطقهای در ایالات متحده در آدرس https://us.api.x.ai/v1 در دسترس است. این نقطه اتصال، استنتاج را در داخل خاک آمریکا نگه میدارد و در مقابل، ۱۰٪ هزینه اضافی دارد. همچنین SpaceXAI به توسعهدهندگان توصیه میکند که برای اطمینان از نرخ موفقیت بالای حافظه پنهان (cache hits) در هنگام فراخوانیهای API، حتماً یک prompt_cache_key تنظیم کنند.
طبق مستندات فنی منتشر شده در marktechpost.com، Grok 4.7 چهار تغییر معماری بنیادین را معرفی کرده است:
- مدل بنیادی جدید: این نسخه مدل پایه Grok 4.6 را بهطور کامل کنار گذاشته و از یک مدل بنیادی (Foundation Model) بزرگتر استفاده میکند.
- یادگیری تقویتی گسترده (Extended RL): اجرای طولانیتر فرآیند یادگیری تقویتی با تمرکز ویژه بر وظایفی که تکمیل آنها نیاز به ساعتها زمان دارد.
- خود-راستیسنجی (Self-Verification): تقویت بررسیهای داخلی برای مدیریت دقیقتر پنجرههای متنی طولانی و افزایش صحت پاسخها.
- Bot Harness: آموزش بومی برای زیرساخت Grok Bot جهت بهبود عملکرد در کارهای دانشی متنی و تعاملی.
مشخصات فنی این مدل شامل پنجره زمینه (Context Window) ۵۰۰ هزار توکنی و تاریخ قطع دانش تا مه ۲۰۲۶ است. این مدل از چهار سطح استدلال (Low, Medium, High به عنوان پیشفرض، و xHigh) پشتیبانی میکند. از نظر مودالیته، مدل ورودیهای متنی و تصویری را میپذیرد و خروجی را به صورت متن ارائه میدهد. ابزارهای در دسترس شامل فراخوانی تابع (Function Calling)، جستوجوی وب، جستوجوی شبکه X و اجرای کد است. همچنین از APIهای Responses و Chat Completions پشتیبانی میکند.
بر اساس گزارشهای عملکردی، Grok 4.7 در حالت xHigh در تمامی معیارها از نسخه ۴.۶ پیشی گرفته است. بیشترین جهش در Terminal-Bench 4.0 رخ داده که امتیاز مدل را از ۲۰.۳٪ به ۳۸.۰٪ رسانده است. همچنین در محک Harvey Legal Agent با امتیاز ۱۹.۶٪، مدل Fable 5.1 Max را که تنها ۶.۷٪ کسب کرده بود، بهشدت شکست داد.
سایر نتایج کلیدی عبارتند از:
- EEBench: افزایش ۱۱ امتیازی و رسیدن به ۶۴.۰٪ که بالاترین امتیاز در جدول عرضه است.
- CursorBench 4.0: کسب امتیاز ۴۶.۳٪ و پیشی گرفتن از Grok 4.6 (۴۰.۴٪) و GPT-5.6 Sol Max (۴۱.۷٪).
- DeepSWE v1.1: دستیابی به صحت ۷۱.۰٪ در سطح تلاش بالا.
- HealthBench Professional: کسب امتیاز ۵۶.۷٪.
- AA Briefcase v1.1: رسیدن به امتیاز ۱,۶۵۷.
با این حال، این مدل در همه دستهها برنده نیست. Fable 5.1 Max همچنان در چهار محک از هفت محک پیشتاز است، از جمله کسب امتیاز ۵۷.۹٪ در Terminal-Bench 4.0؛ هرچند هزینه ورودی آن ۵ برابر (۱۰ دلار در میلیون) و هزینه خروجی آن ۸.۳ برابر (۵۰ دلار در میلیون) بیشتر از Grok است. همچنین GPT-5.6 Sol Max با ۷۲.۷٪ همچنان صدرنشین DeepSWE v1.1 است.
در محک GDPval که کارهای دانشی حرفهای را میسنجد، Grok 4.7 xhigh امتیاز ۱,۶۹۵ Elo را کسب کرد که نسبت به ۱,۶۰۵ در Grok 4.6 high پیشرفت قابل توجهی است. اگرچه Fable 5.1 max با ۱,۷۳۵ پیشتاز است و GPT-6 Astra max امتیاز ۱,۵۴۲ را ثبت کرده، اما SpaceXAI اشاره میکند که Grok 4.7 در ایجاد اسناد و ارائهها (Presentations) برتری دارد.
در حوزه امنیت، SpaceXAI یک پشته حفاظتی جدید را پیاده کرده است. به نقل از اعلام شرکت، این مدل در برابر jailbreak و درخواستهای غیرمجاز مقاومترین مدل آزمایششده آنهاست و در محک زیستامنیتی LatchBio امتیاز ۶۲.۴٪ را کسب کرده است. همچنین با استفاده از HackerBench v0.3 (محک اختصاصی SpaceXAI برای وظایف سایبری خطرناک و مخرب)، این مدل تنها ۳.۳٪ از پرامپتهای خطرناک با کاربرد دوگانه را پذیرفته است. شرکت تأکید میکند که این مدل بهندرت کارهای امنیتی مشروع را مسدود میکند. برای تقویت این بخش، دسترسی محدود و دعوتنامهای به قابلیتهای Red-team برای تحقیقات دفاعی در اختیار شرکای منتخب امنیت سایبری قرار گرفته است.
از منظر استراتژیک، این عرضه نشان میدهد SpaceXAI بهجای تسلط مطلق بر بنچمارکها، «مرز قیمت-عملکرد» را اولویت قرار داده است. با ثابت نگه داشتن هزینهها در حالی که اندازه مدل پایه افزایش یافته، آنها در حال فشار آوردن به رقبا برای کاهش قیمت مدلهای استدلالی سطح بالا هستند.
علاوه بر این، ادغام همزمان Grok Bot در خودروهای تسلا نشان میدهد که ارزش اصلی مدل دیگر تنها در API نیست، بلکه در اکوسیستم است؛ جایی که مدل به یک عامل صوتی تبدیل شده که قادر است ایمیلها و رزروها را بهصورت بدون دست (hands-free) در کابین تسلا مدیریت کند. این پیشروی در تعاملات صوتی در ادامه بهبودهای چشمگیر در دقت تبدیل گفتار به متن صورت گرفته که تجربه کاربری را در محیطهای پویا ارتقا میدهد.
توسعهدهندگان میتوانند نسخه تخصصی Grok 4.7 Fast را در Cursor و Grok Build تجربه کنند که سرعت خروجی را دو برابر میکند، اما هزینه آن نیز دو برابر است. این نسخه سریع در سطح رایگان Grok Build قرار ندارد و در API عمومی xAI در دسترس نیست.
گام بعدی شما
- اگر از Cursor استفاده میکنید، مدل Grok 4.7 را برای پروژههای با codebase بزرگ (به دلیل پنجره متنی ۵۰۰ هزار توکنی) تست کنید.
- برای کاهش هزینههای API، حتماً از
prompt_cache_keyبرای افزایش نرخ hit در حافظه پنهان استفاده کنید. - عملکرد مدل را در وظایف استدلالی طولانیمدت با مدلهای رقیب مقایسه کنید تا نقطه شکست دقت را بیابید.
اما داستان سختافزاری این تحول و نحوه مدیریت این حجم از محاسبات حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو