تصور کنید به جای نوشتن عبارتهای پیچیده regex یا دستورات LIKE، بتوانید به پایگاهداده بگویید: «تمام تیکتهایی را بیاور که مشتری در آنها تهدید به لغو قرارداد کرده است». این قابلیت اکنون با ابزار sqljev (نسخه ۰.۱.۰) به واقعیت تبدیل شده است. این ابزار قضاوتهای معنایی را مستقیماً در فرآیند کوئرینویسی برای هشت سیستم مدیریت پایگاهداده اصلی ادغام میکند.
به نقل از مستندات این پروژه، سالهاست که SQL با مفهوم «معنا» دستوپنجه نرم میکند. در حالی که این زبان بهراحتی میتواند «تیکتهای ایجاد شده در این هفته» را بیابد، اما بهطور بومی نمیتواند تشخیص دهد کدام تیکتها شامل «تهدید مشتری به لغو قرارداد» هستند، کدام قراردادها به «تضمین قیمت» اشاره دارند یا کدام گزارشهای عوارض جانبی، «آسیب کبدی» را توصیف میکنند. این موارد را نمیتوان با عملگرهای =، LIKE یا regex استخراج کرد. طبق گزارش توسعهدهندگان، روش سنتی این بود که دادهها به یک نوتبوک خارجی صادر شوند، توسط یک مدل قضاوت شوند و نتایج هرگز به محیط اصلی پایگاهداده — جایی که بقیه بخشهای پرسوجو قرار دارند — بازنگردند.
همانطور که در تحلیلهای قبلی ما دربارهی مدلهای کوچک و تخصصی اشاره کردیم، جابهجایی محاسبات به نزدیکی دادهها کلید بهرهوری است. sqljev این مشکل را با افزودن توابعی مانند jev()، jev_prob() و jev_choice() به زبان کوئری حل میکند. این توابع اجازه میدهند یک مدل — شبیه به یک داور سریع که هر سطر را میخواند و بله یا خیر میگوید — به عنوان یک فیلتر بولی یا طبقهبندیکننده در یک دستور SELECT استاندارد عمل کند. این رویکرد، قضاوت را به داخل کوئری بازمیگرداند و اجازه میدهد فیلترهای معنایی با دستورات استاندارد SQL مانند JOIN، GROUP BY و LIMIT ترکیب شوند. استراتژی این است: محاسبات ریاضی، تاریخها و تطبیقهای دقیق را در SQL نگه دارید و قضاوت درباره معنا را به مدل بسپارید. این تلاش برای نزدیکتر کردن منطق برنامه به لایهی داده، مشابه رویکردی است که در ابزار SQLBraid برای حذف لایههای میانی و تامین امنیت تایپی مشاهده کردیم.
پایگاههایداده مورد پشتیبانی و نحوه ادغام
این ابزار از طریق روشهای مختلف با محیطهای متنوعی سازگار شده است تا بیشترین کارایی را داشته باشد:
- Snowflake، Databricks، BigQuery، Redshift و DuckDB: در این سیستمها، سطرها بهصورت JSON ارسال میشوند. برای مثال، در Snowflake میتوان از کوئری
SELECT * FROM tickets t WHERE jev(OBJECT_CONSTRUCT(t.*), 'the customer threatens to cancel');استفاده کرد. همچنین برای توابع احتمال و انتخاب میتوان ازto_json(t)بهره برد؛ مانند:SELECT subject, jev_prob(to_json(t), 'the customer is angry') AS p FROM tickets t ORDER BY p DESC LIMIT 20;یا برای مسیریابی تیکتها:SELECT jev_choice(to_json(t), 'which team should handle this?', ['billing', 'technical', 'security', 'sales']) AS team, count(*) FROM tickets t GROUP BY team; - SQL Server و Azure SQL: ادغام در نسخه ۲۰۲۵ از طریق
sp_invoke_external_rest_endpointصورت میگیرد. برای نسخههای ۲۰۱۶ تا ۲۰۲۲، جدول پاسخها از بیرون با یک دستور پر میشود. مثال:EXEC jev.judge N'dbo.tickets', N'the customer is angry';یا استفاده از احتمال:SELECT * FROM dbo.tickets AS t WHERE jev.prob((SELECT t.* FOR JSON PATH, WITHOUT_ARRAY_WRAPPER), N'the customer is angry') >= 0.5; - PostgreSQL و MySQL: این دو پایگاهداده برای اجرا به هیچ افزونه (Extension) یا دسترسی superuser نیاز ندارند.
معماری استقرار
برای بهینهسازی، روش استقرار در هر پلتفرم متفاوت است:
- در Snowflake، مدل Laya میتواند درون حساب کاربری و از طریق Snowpark Container Services اجرا شود.
- در Databricks، توابع pandas UDF روی هر executor ثبت میشوند.
- در BigQuery، از توابع راه دور (Remote Functions) که روی Cloud Run میزبانی میشوند استفاده شده است.
- در Redshift، از AWS Lambda استفاده میشود.
- در DuckDB، از Arrow UDFها در همان فرآیند داخلی (in-process) استفاده میشود.
همچنین، گیتوی (Gateway) این سیستم از API اختصاصی Jev پشتیبانی میکند؛ به این معنی که pg-jev روی یک Postgres سلف-هاست نیز میتواند روی Laya اجرا شود.
موتور پردازشی: Laya و عملکرد
بهصورت پیشفرض، sqljev از مدل Laya محصول Convai Innovations استفاده میکند که یک مدل وزنهای باز (Open Weights) تحت لایسنس Apache 2.0 است. برخلاف مدلهای زاینده (Generative LLMs)، Laya یک مدل تصمیمگیر است؛ یعنی متن نمینویسد، بلکه تصمیم میگیرد. این مدل با دریافت یک سطر و یک پرسش تایپشده (بله/خیر، انتخاب از بین گزینهها، یا امتیازی در سطوح مرتبشده)، احتمالی کالیبره شده را در یک تکگذر (single forward pass) برمیگرداند. این ویژگی نیاز به مهندسی پرامپت (Prompt Engineering)، اصلاح JSON یا تنظیمات دما (Temperature) را بهطور کامل از بین میبرد.
از نظر عملکرد، Laya برای عملیات با حجم بالای پایگاهداده بهینه شده است. روی یک GPU T4، این مدل بهطور متوسط ۳۳ میلیثانیه برای هر تصمیم زمان میبرد که در حالت دستهای (batch) به ۷ میلیثانیه کاهش مییابد. دادههای سطر هرگز شبکه شما را ترک نمیکنند و هزینهای بهازای هر توکن پرداخت نمیکنید. برای کسانی که به دقت Zero-shot بالاتری نیاز دارند، نسخه میزبانیشده Jev از TypeSafe در تنظیمات موجود است، هرچند که در این حالت سطرها به بیرون ارسال شده و هزینه آن ۰.۰۴۲ دلار بهازای هر ۱ میلیون توکن ورودی است.
مقایسه Laya (پیشفرض) در مقابل Jev (میزبانیشده):
- لایسنس/وزنها: Laya دارای لایسنس Apache 2.0 و وزنهای باز است، در حالی که Jev یک API اختصاصی است.
- اجرا: Laya روی سرور شما (GPU یا CPU) اجرا میشود، اما Jev در ابر TypeSafe است.
- هزینه: Laya رایگان (۰ دلار بهازای توکن) است، اما Jev هزینه ۰.۰۴۲ دلار/۱ میلیون توکن دارد.
- تأخیر: Laya حدود ۳۳ میلیثانیه (T4) و Jev حدود ۲۵۰ میلیثانیه برای هر درخواست است.
- دقت Zero-shot: Laya دارای دقت ۰.۳۶۲ (پایه) و Jev دارای دقت ۰.۷۲۷ است.
- دقت Fine-tuned: Laya به ۰.۷۶۶ میرسد، اما Jev قابلیت تنظیم دقیق ندارد.
- مجموعه گزینههای گسترده: Laya در تست Banking77 دقت ۰.۴۲۵ و Jev دقت ۰.۸۷۰ دارد.
مکانیسمهای افزایش سرعت
برای حفظ سرعت در سطح پایگاهداده، sqljev از استراتژیهای زیر استفاده میکند:
- دستهبندی (Batching): هر پایگاهداده بهطور پیشفرض فراخوانیهای UDF را دستهبندی میکند. Snowflake، BigQuery، Redshift، Spark و DuckDB صدها یا هزاران سطر را در هر فراخوانی ارسال میکنند و
jev.judgeدر SQL Server هر بار ۵۰۰ سطر میفرستد. هر دسته تنها یک فراخوانی موتور است. - کشینگ (Caching): سطرهای یکسان تنها یکبار قضاوت میشوند. پاسخها بر اساس محتوای سطر و پرسش کش میشوند، بنابراین اجرای مجدد کوئریها یا تغییر آستانهها (thresholds) بدون هزینه است.
- گذرهای پیشرو مشترک (Shared Forward Passes): مواردی که در کش نیستند، در یک گذر پیشرو (بهصورت پیشفرض ۶۴ سطر) بستهبندی شده و بر اساس طول مرتب میشوند. در CPU، این کار سرعت را از ۰.۳۵ ثانیه (تکتک) به ۰.۱۹ ثانیه برای هر سطر میرساند.
- استریمینگ (Streaming): هنگام استفاده از
--where... --limit Nسیستم پس از یافتن اولین N مورد تطبیقیافته، متوقف میشود.
در یک بنچمارک روی GPU لپتاپ RTX 4090، این سیستم ۱۴۰,۰۰۰ تصمیم را در ۲۷۱ ثانیه (۵۱۶ مورد در ثانیه) پردازش کرد. اجرای مجدد ۱۳ کوئری به دلیل کشینگ تنها ۰.۹ ثانیه زمان برد. با استفاده از یک مدل جایگزین فوری، سربار سیستم ۹۸,۰۰۰ تصمیم در ثانیه اندازهگیری شد.
صحت و تنظیم دقیق
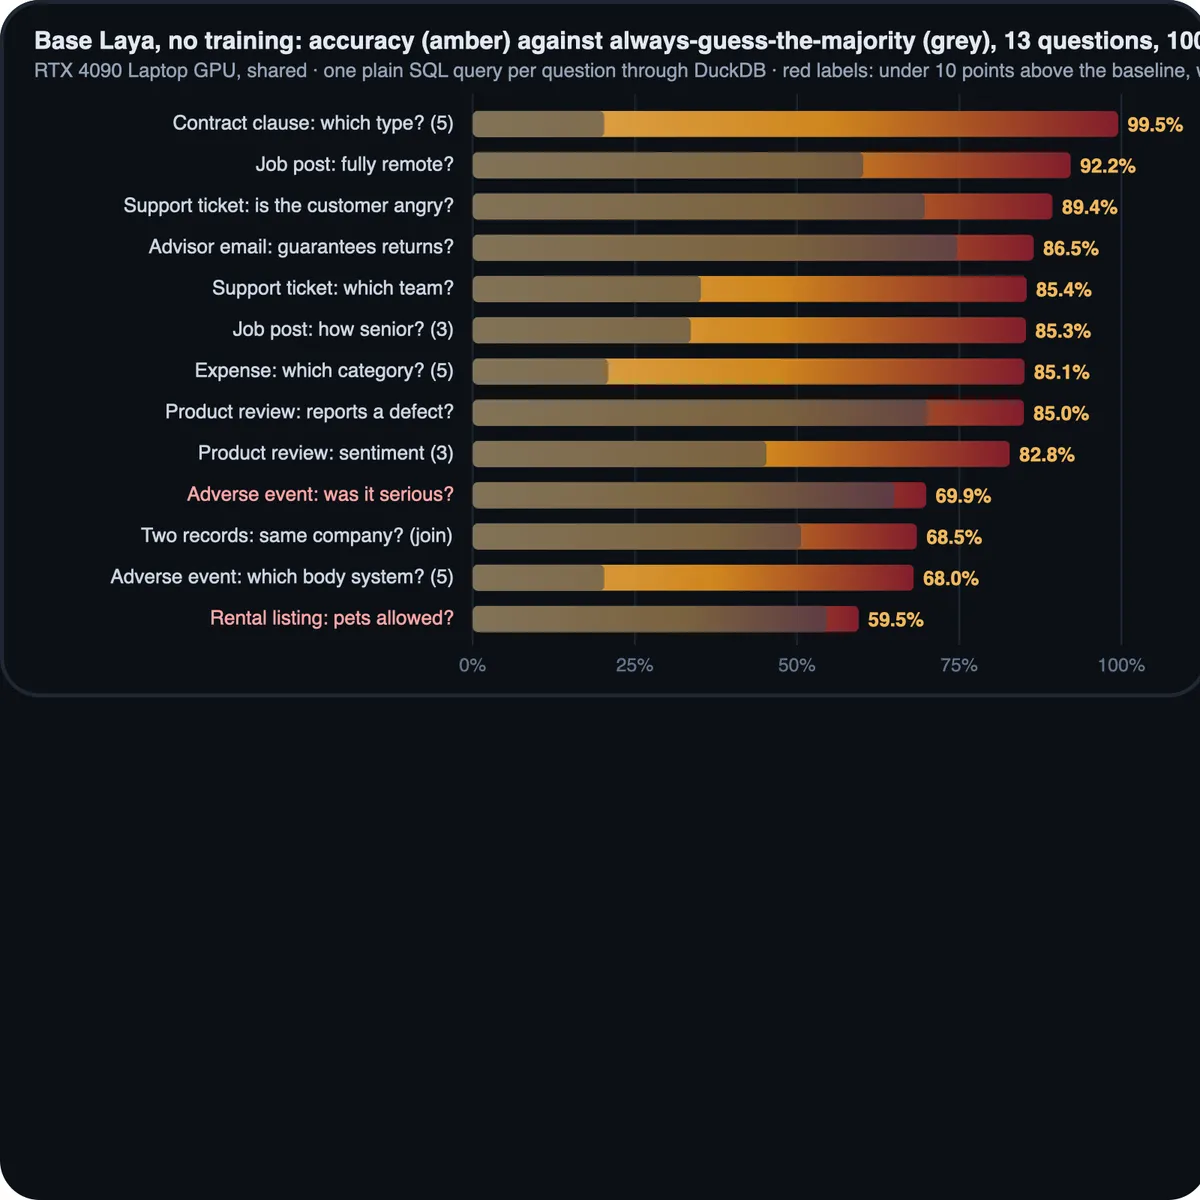
صحت مدل در حالت Zero-shot (بدون نمونه قبلی) بسته به وظیفه متفاوت است. در تستهای انجام شده روی ۱۰۰,۰۰۰ سطر در ۱۰ جدول مصنوعی با مدل پایه Laya انگلیسی، نتایج به این شرح بود:
- دقت بالا: تشخیص نوع بند قرارداد (۹۹.۵٪ دقت، ۱۶۰۶ سطر/ثانیه)، وضعیت دورکاری آگهی شغلی (۹۲.۲٪ دقت، ۳۷۵ سطر/ثانیه) و عصبانیت تیکتهای پشتیبانی (۸۹.۴٪ دقت، ۵۶۷ سطر/ثانیه).
- دقت متوسط: بازگشت ایمیلهای مشاور (۸۶.۵٪)، تیم پشتیبانی تیکت (۸۵.۴٪)، ارشدیت شغلی (۸۵.۳٪)، دستهبندی هزینهها (۸۵.۱٪)، نقص محصول در بررسیها (۸۵.۰٪) و تحلیل احساسات محصول (۸۲.۸٪).
- دقت پایین: جدی بودن عوارض جانبی (۶۹.۹٪ در مقابل ۶۵.۰٪ خط پایه)، شناسایی دو رکورد از یک شرکت (۶۸.۵٪)، سیستم بدنی عوارض جانبی (۶۸.۰٪) و اجازه ورود حیوانات خانگی در اجارهها (۵۹.۵٪ در مقابل ۵۴.۶٪ خط پایه).
این شکاف جایی است که قابلیت تنظیم دقیق (Fine-tuning) — شبیه به وقتی که به یک پزشک عمومی، تخصص پوست میدهیم تا در یک حوزه دقیق شود — حیاتی میشود. کاربران میتوانند مدل را روی دادههای برچسبدار خود از طریق یک فرآیند چهارمرحلهای CLI آموزش دهند:
۱. ایجاد مجموعه داده: استفاده از sqljev dataset برای ایجاد بخشهای آموزش و تست. ستون برچسب هرگز به مدل نشان داده نمیشود تا مدل دقیقاً آنچه را که از او پرسیده خواهد شد، بیاموزد.
۲. ارزیابی: اجرای sqljev eval برای مشاهده عملکرد مدل پایه روی سطرهای خاص شما.
۳. تنظیم دقیق: استفاده از sqljev finetune روی GPU. یک Colab T4 رایگان کافی است و با استفاده از --train-layers 12 میتوان مصرف حافظه را زیر ۱۰ گیگابایت نگه داشت.
۴. انتشار: اندازهگیری مجدد و سپس استفاده از sqljev publish برای ارسال چکپوینت به مخزن و متصل کردن sqljev gateway به آن.
در یک دموی دارویی درباره جدی بودن عوارض جانبی، تنظیم دقیق روی تنها ۳,۰۰۰ سطر آموزشی (با ۱,۰۰۰ سطر برای تست)، دقت را در دو دقیقه روی یک GPU لپتاپ از ۶۹.۴٪ به ۱۰۰٪ رساند.
مرجع توابع
sqljev مجموعهای ثابت از توابع را برای هر هشت پایگاهداده ارائه میدهد:
jev(row, condition): یک مقدار بولی برمیگرداند (با آستانه ۰.۵).jev_prob(row, condition): یک عدد اعشاری (۰ تا ۱) برای مرتبسازی بر اساس فوریت یا احتمال برمیگرداند.jev_choice(row, question, options): متنی را برای مسیریابی (مثلاً کدام تیم یا دستهبندی) برمیگرداند.jev_score(row, question, levels): یک موقعیت وزندار بر اساس احتمال را در سطوح مرتبشده برمیگرداند.jev_eval(row, question, kind, options): یک شیء JSON شامل تمام احتمالات و میزان اطمینان (confidence) برمیگرداند.
محدودیتهای عملیاتی
برای جلوگیری از گلوگاههای عملکردی، رعایت این الگوها ضروری است:
- محدود کردن قبل از قضاوت: پایگاهدادهها لیست SELECT را قبل از ORDER BY... LIMIT محاسبه میکنند. قرار دادن
jev_prob()در کنار LIMIT 100 باعث میشود تمام سطرهای جدول قضاوت شوند. ابتدا از یک subquery برای محدود کردن تعداد سطرها استفاده کنید. - فیلترهای ارزان SQL: هیچ ایندکسی نمیتواند به یک شرط زبان طبیعی پاسخ دهد. هر سطری که به
jev()میرسد یکبار قضاوت میشود. ابتدا از فیلترهای استاندارد SQL استفاده کنید تا حجم دادههای ارسالی به مدل کاهش یابد. - محدودیت توکن: مدل Laya در انگلیسی ۵۱۲ توکن (Token) — تکههای کوچکی از متن شبیه برشهای کیک — و در حالت چندزبانه ۱۰۲۴ توکن (تا ۸۱۹۲ با
max_len) را میخواند؛ بنابراین فقط ستونهای ضروری را ارسال کنید. - تثبیت مدلها (Pin Models): پاسخها ممکن است بین چکپوینتهای مختلف تغییر کنند. وقتی نتایج وارد گزارشهای رسمی میشوند، مدل خود را Pin کنید.
این تغییر، فرض بنیادی بازیابی دادهها را دگرگون میکند. به جای treating AI به عنوان یک مرحله پسپردازش، sqljev مدل را به عنوان یک اپراتور درجه اول SQL در نظر میگیرد. برای توسعهدهنده، این بدان معناست که «معنای» یک ستون، به اندازه «نوع داده» آن، قابل کوئری زدن است.
گام بعدی شما
- اگر از PostgreSQL یا MySQL استفاده میکنید، sqljev را بدون نیاز به دسترسیهای مدیریتی نصب و تست کنید.
- برای دادههای تخصصی (مانند حقوقی یا پزشکی)، از فرآیند چهارمرحلهای
sqljev finetuneبرای ارتقای دقت استفاده کنید. - کوئریهای خود را بازبینی کنید تا توابع معنایی را بعد از فیلترهای سختافزاری و تاریخ قرار دهید.
اما تأثیر این رویکرد بر معماری پایگاهدادههای برداری و جستوجوی معنایی حتی عمیقتر است — به تحلیل ما دربارهی Vector Databases مراجعه کنید.



گفتگو