۷۰ میلیثانیه. این همان تأخیری است که اجازه میدهد هوش مصنوعی بهجای یک چتبات کند، مانند یک قطعه نرمافزاری در لحظه (Real-time) عمل کند. برای رسیدن به این سرعت، شرکت TypeSafe AI در ۱۵ سپتامبر ۲۰۲۶ مدل Jev را بهعنوان نخستین مدل «سیستم یک» خود برای اتوماسیونهای ساختاریافته و پرسرعت عرضه کرد.
بسیاری از عاملهای هوش مصنوعی در مقیاس واقعی شکست میخورند چون به مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — متکی هستند که متن را توکن به توکن تولید میکند. این فرآیند متوالی، کند است و منجر به توهم (Hallucination) — یعنی وقتی مدل با اطمینان چیزی میگوید که اصلاً وجود ندارد، شبیه دوستی که خاطرهای را اشتباه تعریف میکند — میشود. برای یک کسبوکار، یک خطای کوچک در نوع داده (Type Error) در زنجیرهای از وابستگیها میتواند کل گردشکار اتوماتیک را متوقف کند. این چالشها در مدلهای سنتی منجر به توسعه رویکردهای جدیدی شده است، مانند مدلهای LLM-JEPA که با شبیهسازی واقعیت توانستند نرخ توهم را در مدلهای Llama3 و Gemma2 کاهش دهند.
دیوگو آلمیدا (Diogo Almeida)، بنیانگذار TypeSafe AI و پژوهشگر سابق OpenAI، معتقد است صنعت بیش از حد بر چت تمرکز کرده و «تفکر سیستم یک» توصیفشده توسط دانیل کانمن را نادیده گرفته است. آلمیدا پیشتر در OpenAI روی روشهایی کار کرد که مدلهای زبانی را در پیروی از دستورات توانمند ساخت؛ تحقیقاتی که در نهایت قدرت بخشیدن به ChatGPT را ممکن کرد. با این حال، او متوجه شد که علیرغم تمام هیاهوهای تبلیغاتی، یک حلقه حیاتی برای دستیابی به اتوماسیون واقعی مفقود است.
در حالی که «سیستم دو» برای استدلالهای کند، متفکرانه و آگاهانه است، سیستم یک برای تصمیمات سریع و شهودی به کار میرود. Jev نسخهای نرمافزاری از همین شهود است. نام این مدل از ویلیام استنلی جِونز گرفته شده است؛ تیم سازنده انتظار دارد هوش ماشینی مسیری شبیه به زغالسنگ طی کند، جایی که افزایش بهرهوری منجر به انفجار تقاضا میشود. آنها باور دارند هر کاهش ۱۰ برابری در هزینه هوش، کاربردهای جدیدی را در مقیاس بسیار بزرگتر باز میکند.
معماری سرعت
به نقل از مستندات فنی شرکت، TypeSafe AI برای دستیابی به این هدف، کل پشته فناوری را از ابتدا بازسازی کرد. آنها نمونهبرداری خودبازگشتی (Autoregressive Sampling) — که در آن مدل هر بار یک کلمه را بر اساس کلمات قبلی پیشبینی میکند و هر توکن مشروط به توکن قبلی است — را با یک نمونهبردار موازی جایگزین کردند. این تغییر به Jev اجازه میدهد تمام خروجیها را در یک پرسوجوی واحد تولید کند. این رویکرد باعث میشود مدل کاملاً با سختافزار سازگار (Hardware-aware) و بهشدت بهینه باشد. این بازنگری در زیرساختها یادآور این نکته است که بدون پذیرش معماریهای چندوجهی، بسیاری از پشتههای فناوری هوش مصنوعی تا سال ۲۰۲۶ منسوخ خواهند شد.
آموزش و کالیبراسیون
این مدل با روش جدیدی به نام «یادگیری تقویتی برای تصمیمات کالیبره شده» (RLCD) آموزش دیده است. این روش با متدهای رایج بهینه سازی تفاوت بنیادی دارد:
- RLHF/RLVR: یادگیری تقویتی با بازخورد انسانی (RLHF) یا یادگیری تقویتی با پاداشهای قابل تأیید (RLVR)، بر ترجیحات انسانی (نوشتههایی که انسانها میپسندند) یا خروجیهای برنامهنویسیشده (مثل اثباتهای ریاضی) تمرکز دارد.
- RLCD: بر کالیبراسیون (Calibration) تصمیمات تمرکز میکند تا پاسخها را با احتمالات صادقانه از نظر معرفتی (Epistemically honest probabilities) در وظایف سیستم یک ارائه دهد.
این یعنی وقتی Jev پاسخی میدهد، امتیاز اطمینان آن دقیقاً نشاندهنده احتمال درست بودن است. برخلاف مدلهای زبانی بزرگ که حتی هنگام تخمین اطمینان، بیش از حد مطمئن و متناقض هستند، Jev همواره عدم قطعیت را اعلام میکند. اگر مدلی ۹۵٪ دقیق باشد اما نتواند آن ۵٪ خطا را شناسایی کند، نمیتواند یک وظیفه را بهطور کامل اتوماتیک کند؛ Jev با همبست کردن اطمینان بالا با دقت بالا، این مشکل را حل میکند.
بنچمارکهای عملکرد و هزینه
طبق گزارش فنی TypeSafe AI، مدل Jev تغییری عظیم در اقتصاد و سرعت نسبت به مدلهای پیشرو ایجاد کرده است:
- تأخیر: زمان پاسخدهی نهایی بین ۷۰ تا ۵۰۰ میلیثانیه است، در حالی که مدلهای پیشرو بین ۳ تا ۳۲۹ ثانیه زمان میبرند. این یعنی Jev برای پرسوجوهای سیستم یک، ۴۰ تا ۲۰۰ برابر سریعتر است.
- هزینه ورودی: قیمت توکنهای ورودی ۰.۰۴۲ دلار به ازای هر میلیون توکن (معادل ۴۲ دلار به ازای هر میلیارد توکن) است. برای مقایسه، ورودی LLMها بین ۰.۲۰ تا ۱۰ دلار است.
- هزینه خروجی: توکنهای خروجی رایگان هستند (آنقدر ارزان هستند که نیازی به اندازهگیری ندارند)، در حالی که در LLMها معمولاً ۵ برابر گرانتر از ورودیها هستند.
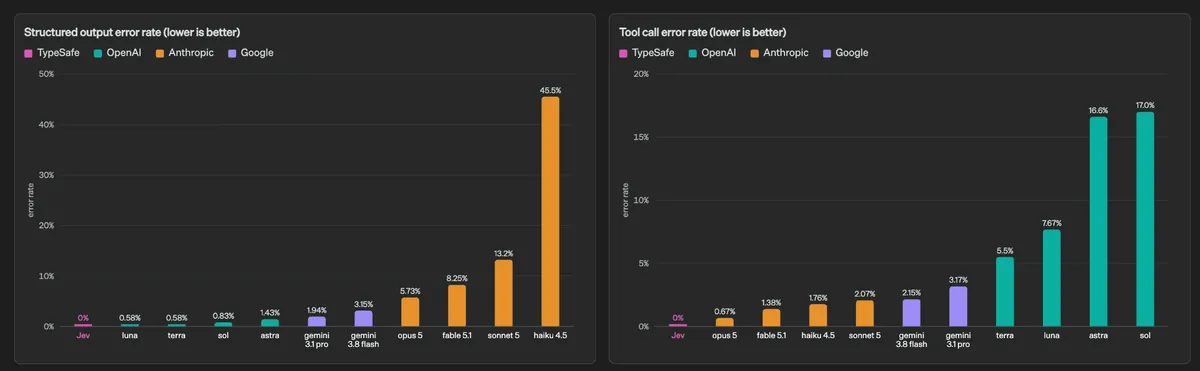
- قابلیت اطمینان: این مدل بهطور ریاضی قادر به تولید خطای نوع (Type Error) نیست چون بهجای رشتههای متنی منعطف، مقادیر ساختاریافته و تایپشده تولید میکند. تطبیق طرح (Schema matching) تضمین شده است و به همین دلیل تیم سازنده نرخ خطای ۰٪ را در نمودارهای خود ثبت کرده است.
ارزیابی گردشکار
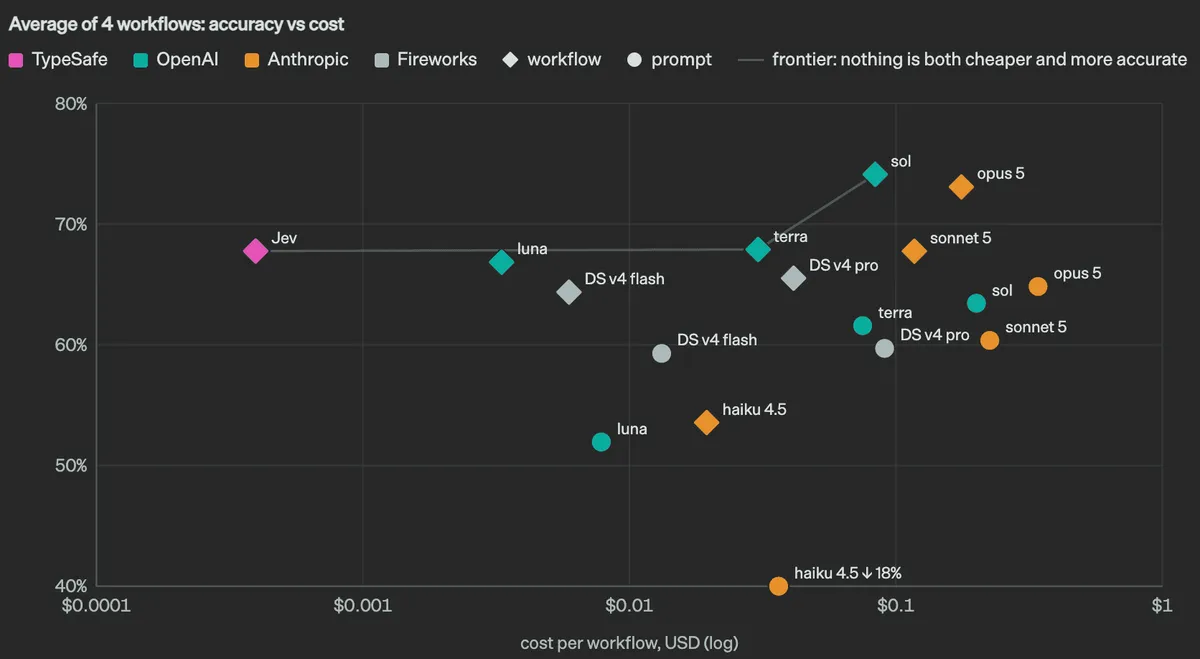
در ارزیابیهای عملیاتی، Jev با مدلهای GPT-6 Astra و Fable 5.1 مقایسه شد. برای اندازهگیری این موضوع، TypeSafe AI نوع جدیدی از ارزیابی را ایجاد کرد که فرض میکند یک گراف محاسباتی درست (یک «گردشکار» در کد) وجود دارد و از پیشبینیهای بزرگترین و گرانترین مدلهای خارجی بهعنوان احتمالات مرجع استفاده میکند.
TypeSafe AI ادعا میکند Jev برای اتوماسیونهای تجاری در سطح تولید، تا ۱۹۳.۶ برابر سریعتر و ۴۴۴.۶ برابر ارزانتر است. در این تستها، Jev مرز پارتو (Pareto frontier) را تقریباً دو مرتبه بزرگی (۱۰۰ برابر) در اختیار داشت. تیم سازنده اشاره کرد که برای محدود کردن LLMها به تصمیمات ساختاریافته سازگار، از یک پوشش (Wrapper) مدل زبانی سیستم یک استفاده کردند، اما این روش حتی از خروجیهای استاندارد LLM نیز کندتر و گرانتر بود.
نکات فنی و محدودیتها
تیم سازنده چند نکته را ذکر کرده است: ارزیابیهای سرعت عمدتاً از لپتاپهایی در ساحل غربی آمریکا (محل استقرار فعلی سرویس) انجام شده است. همچنین اعتراف کردند که چون گردشکارهای ارزیابی توسط تیم داخلی قابلیتهای مدل خودشان طراحی شده، احتمال وجود برخی سوگیریها هست.
علاوه بر این، با استفاده از میانگین GPT-6 Astra و Fable 5.1 بهعنوان پاسخ مرجع، تیم معتقد است که احتمالاً عملکرد نسبی Jev و مدلهای DeepSeek را کمتر از واقعیت تخمین زدهاند، زیرا پاسخ مرجع به سمت مدلهای OpenAI و Anthropic سوگیری دارد.
کاربردهای دنیای واقعی
از آنجا که Jev «چت» نمیکند، مانند یک فراخوانی تابع (Function Call) با هوش سطح بالا عمل میکند. این مدل وضعیتهای بدون ساختار (مانند وضعیت ساختاریافته یک برنامه) را بهعنوان ورودی میگیرد و تصمیمات احتمالی تایپشده را بهعنوان خروجی برمیگرداند. کاربردهای ایدهآل آن عبارتند از:
- دستورات If هوشمند: جایگزینی منطقهای سختافزاری دستنویس و شکننده با قوانین تصمیمگیری منعطف (Fuzzy) برای طبقهبندی، مسیریابی، امتیازدهی، استخراج یا شاخهبندی.
- تجربه کاربری (UX) در لحظه: ادغام هوش مصنوعی در برنامههایی که پاسخ زیر ۱۰۰ میلیثانیه برای تجربه کاربر حیاتی است.
- پردازش دادههای حجیم: تبدیل پتابایتها داده به ویژگیها و بینشها (Insights) از طریق Map-Reduce بدون هزینههای سنگین تولید رشتههای متنی.
- حفاظها (Guardrailing): عمل بهعنوان یک داور پرسرعت برای امتیازدهی، تأیید و شناسایی تلاشهای [jailbreak] در پرامپتهای LLM، ردپاهای استدلالی و خروجیها.
دموهای عملیاتی
تیم برای اثبات تواناییها، دو دموی خاص ساخت:
- Doom Bot: رباتی که وضعیت بازی را بهعنوان یک ساختار داده (و نه تصویر) ۱۰ بار در ثانیه پردازش میکند. مهندس پروژه اشاره کرد که ۱۰ پرسوجو در ثانیه حدود ۷ دلار در ساعت هزینه دارد، مبلغی که بسیار کمتر از انتظارات برای هوش مصنوعی در لحظه است. تیم قصد دارد یک راهنمای جامع منتشر کرده و رویدادهای هکاتون برای این پروژه برگزار کند.
- Wikiracing: عاملی که بین صفحات ویکیپدیا جابهجا میشود و تنها از لینکهای موجود استفاده میکند. با وجود صدها یا هزاران لینک در هر صفحه، Jev مزیت عدم توهم در انتخابهای با تعداد بالا (High-cardinality) را نشان داد. Jev از تعداد گزینههای تا ۲۵۵ مورد پشتیبانی میکند؛ برای اعداد بالاتر، از یک سیستم دو مرحلهای شامل امتیازدهی مستقل و سپس انتخاب صریح استفاده میکند. در این دمو، Jev با گامهای کمتری نسبت به LLMهای غیر استدلالی به مقصد رسید که نشاندهنده هوش بالاتر است.
موازنه: خداحافظی با متن
قدرتهای Jev حاصل یک فداکاری است: این مدل نمیتواند متن تولید کند. نه مقالهای مینویسد، نه شعری و نه پاسخی در قالب چت. با حذف انعطافپذیری رشتههای متنی — که میتوانند هر چیزی از کد گرفته تا پیامهای رد درخواست باشند — خطر «از ریل خارج شدن» مدل بهطور کامل حذف شده است.
این یک پارادایم جدید در معماری هوش مصنوعی است. توسعهدهندگان میتوانند از یک LLM پیشرو برای استدلالهای پیچیده (سیستم دو) و از Jev برای هزاران تصمیم سریع و ساختاریافته (سیستم یک) که برای اجرای آن استدلال در نرمافزار لازم است، استفاده کنند.
در یک نمایش مقایسهای در کنار GPT-5.6 Terra، مدل Jev تمام احتمالات را بهصورت موازی تولید کرد، در حالی که مدل OpenAI بهصورت خودبازگشتی عمل میکرد. در حالی که GPT-5.6 Terra بهعنوان معیار هوش استفاده شد، تنها مورد اختلاف بین دو مدل در دمو، روی «سطح احتمال ریزش کاربر» (Churn likelihood level) بود؛ نقطهای که تیم TypeSafe اعتراف کرد واقعاً مبهم به نظر میرسید. آنها اشاره کردند که همین دمو بود که در ابتدا آنها را متقاعد کرد تا تمام توان خود را روی مدلهای سیستم یک متمرکز کنند.
این چرخش، هوش مصنوعی را از یک «کمکخلبان» که نیاز به نظارت انسانی دارد، به یک قطعه قابلاعتماد در سیستمهای خودگردان تبدیل میکند. وقتی مدل بتواند عدم قطعیت خود را بهطور سازگار اعلام کند، نرمافزار میتواند تصمیمات با اطمینان پایین را بهطور خودکار به انسان ارجاع دهد و اتوماسیون واقعی را ممکن سازد.
برای توسعهدهندگان، عصر مهندسی پرامپت (Prompt Engineering) — هنر سؤال درست پرسیدن، مثل کسی که میداند چطور از یک مشاور باتجربه بهترین جواب را بگیرد — برای کارهای سادهای مثل طبقهبندی یا مسیریابی به پایان میرسد و جای خود را به طرحهای (Schema) تعریفشده و احتمالات کالیبره میدهد که مستقیماً در کدهای موجود قرار میگیرند. TypeSafe AI در حال حاضر دسترسی زودهنگام را برای توسعهدهندگان باز کرده تا کاربردهای جدید «علمی-تخیلی» را کشف کنند و نقاط ضعف مدل را شناسایی نمایند.
گام بعدی شما
- اگر در حال ساخت عاملهای هوش مصنوعی هستید، بررسی کنید کدام بخشهای زنجیره تصمیمگیری شما نیاز به استدلال پیچیده دارد و کدام بخشها را میتوان به مدلهای سریع سیستم یک سپرد. این رویکرد در برنامههای جامع آموزشی، مانند برنامه Eduleem که بر RAG و توسعه عاملها در محیطهای ابری تمرکز دارد، مورد تأکید قرار گرفته است.
- برای کاهش هزینههای استنتاج، مدلهای تولید متن را در لایههای مسیریابی (Routing) حذف و از خروجیهای ساختاریافته استفاده کنید.
- در دسترسی زودهنگام TypeSafe AI ثبتنام کنید تا محدودیتهای مدل Jev در کاربردهای خاص صنعت خودتان را بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو