پنجرهٔ زمینه ۲۶۲ هزار توکنی و حالت تفکر بومی؛ اینها هستهٔ اصلی توانمندیهای Apertus 1.5 هستند. طبق اعلام تیم توسعه، این مدلها در ۲۴ ژوئیه ۲۰۲۶ تحت لایسنس Apache 2.0 در Hugging Face منتشر شدند تا مدلهای ۸ و ۷۰ میلیارد پارامتری پیشین را از موتورهای متنی ساده به پیشرانهای چندوجهی (Multimodal) تبدیل کنند که قادر به پردازش تصویر، صوت و زنجیرههای استدلالی پیچیده هستند.
این عرضه در حالی رخ میدهد که صنعت هوش مصنوعی به سمت تفکر «سیستم ۲» — جایی که مدلها پیش از پاسخ دادن، استدلال میکنند — و چندوجهی بودن بومی حرکت میکند. در حالی که بسیاری از مدلها برای بینایی به رمزگذارهای مجزا تکیه میکنند، Apertus 1.5 این مودالیتهها را مستقیماً در توکنسازی (Tokenization) ادغام کرده است. این رویکرد بازتابدهنده روند یکپارچهسازی معماریهاست؛ همانطور که در تحلیل قبلی ما دربارهی بهینهسازیهای استنتاج محلی در پیادهسازی WebGPU توسط ChangelogPro اشاره کردیم، شفافیت در لایههای زیرین مدلها اکنون به یک اولویت تبدیل شده است.
معماری چندوجهی بومی
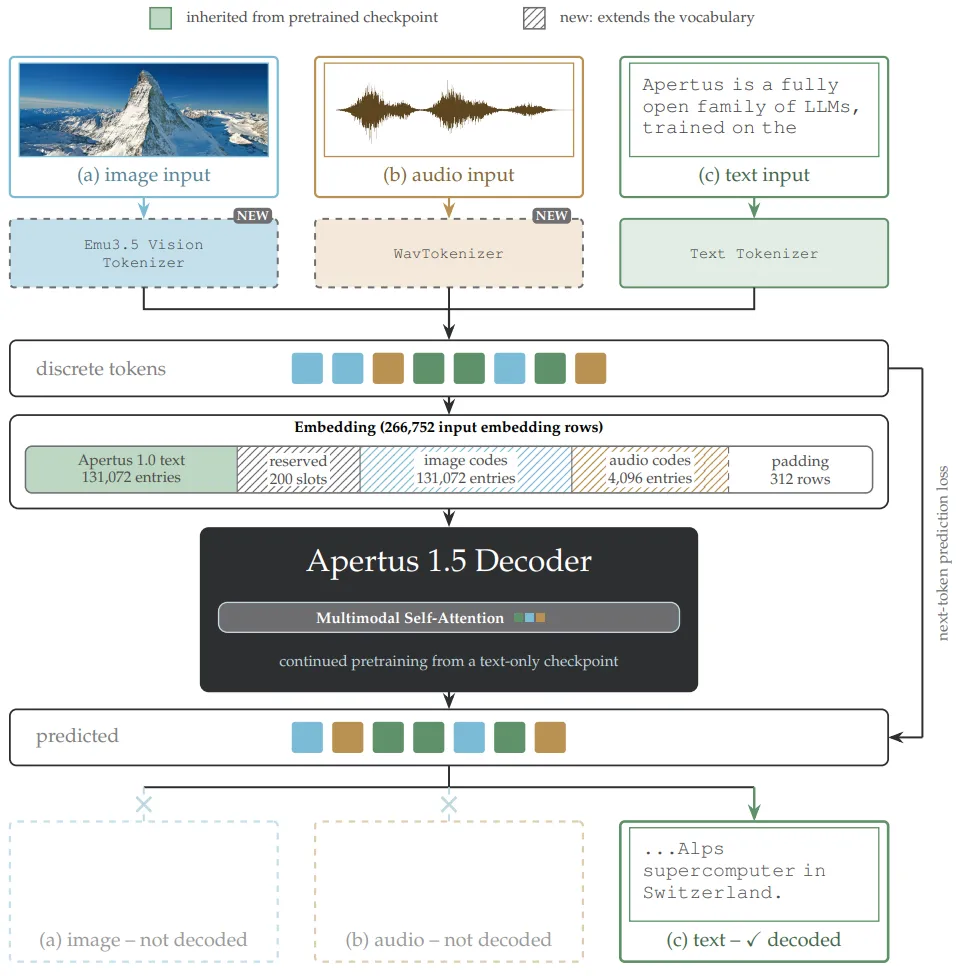
Apertus 1.5 از رمزگذارهای بینایی سنتی فاصله گرفته و از رویکرد «همجوشی زودهنگام» (Early-fusion) استفاده میکند. در این روش، تصاویر و صوتها به جای پردازش در شبکههای جداگانه، به عنوان توکنهای مجزا در همان توالی متن قرار میگیرند.
- تصاویر: از طریق توکنساز Emu3.5 پردازش شده و یک تصویر ۵۱۲×۵۱۲ را به ۱,۰۲۴ توکن تبدیل میکنند.
- صوت: توسط WavTokenizer با نرخ ۴۰ توکن بر ثانیه مدیریت میشود.
به نقل از مستندات فنی، چون تیم توسعه تنها دایره لغات را گسترش داده و معماری را بدون تغییر نگه داشته است، سرعت آموزش مدلها در حالت متنی ثابت مانده است. نکته مهم این است که این مدلها اگرچه تصویر و صوت را میفهمند، اما خروجی آنها فقط متن است. این قابلیت اجازه میدهد اسناد، نمودارها و عکسها وارد گفتگو شوند و زبان گفتاری پردازش شود، هرچند قابلیت صوتی همچنان در وضعیت آزمایشی است.
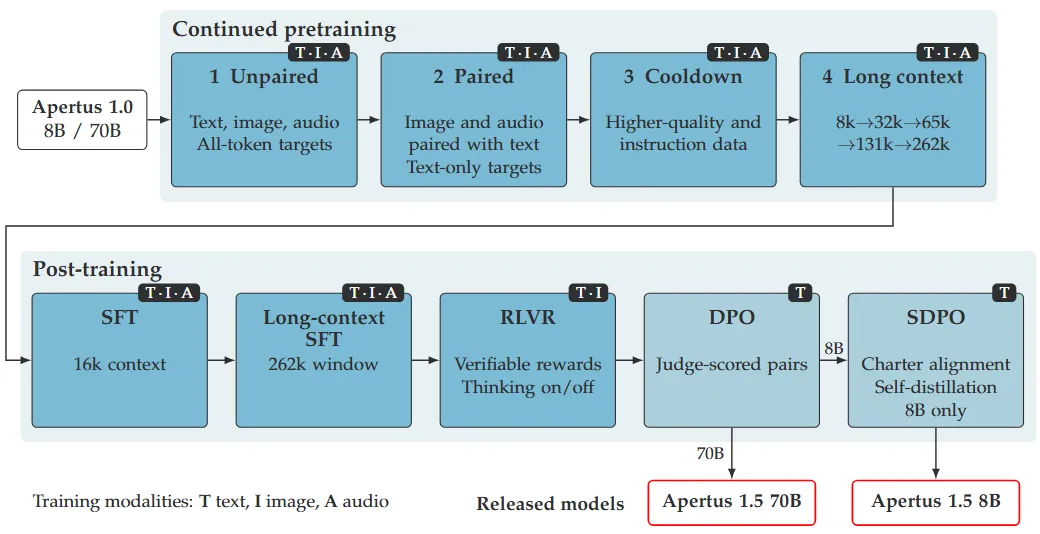
خط لوله آموزش
گذار از نسخه ۱.۰ به ۱.۵ مستلزم پیشآموزش (Pre-training) گستردهای بود. مدل 8B حدود ۴ تریلیون توکن (مجموعاً ۱۹ تریلیون) و مدل 70B حدود ۲ تریلیون توکن (مجموعاً ۱۷ تریلیون) به حافظه خود اضافه کردند.
بر اساس گزارش پروژه، پیشآموزش در چهار مرحله متمایز رخ داد:
۱. جفتنشده (Unpaired): یادگیری مودالیتههای جدید از طریق تصاویر و صوتهای مستقل تا مدل با ماهیت این دادهها آشنا شود.
۲. جفتشده (Paired): همراستاسازی مودالیتهها با استفاده از جفتهای تصویر-شرح و صوت-متن برای پیوند دادن آنها به زبان.
۳. سرمایش (Cooldown): تمرکز ویژه بر دادههای باکیفیت ریاضی و کدنویسی برای تقویت استدلال.
۴. زمینه بلند (Long Context): گسترش تدریجی پنجره متنی گامبهگام از ۸ هزار به ۲۶۲ هزار توکن.
برای حفظ تواناییهای زبانی نسخه ۱.۰، بیش از نیمی از توکنهای آموزشی متنی باقی ماندند. دادههای متنی با منابعی چون FineWeb2-HQ+، FinePDFs و Nemotron-CC بهروزرسانی شدند. تمام دادههای جدید، از جمله مجموعههای چندوجهی، استانداردهای سختگیرانهای داشتند: دسترسی عمومی، لایسنسهای باز و رعایت فایل robots.txt به صورت عطف به ماسبق. تمام منابع در مخزن apertus-data-transparency فهرست شدهاند.
استدلال و پنجره زمینه بلند
یکی از ویژگیهای برجسته، «حالت تفکر» (Thinking Mode) اختیاری است. وقتی این حالت فعال باشد، مدل پیش از ارائه پاسخ نهایی، زنجیرههای استدلالی (Reasoning Traces) تولید میکند که باعث بهبود چشمگیر عملکرد در محکهای دشواری مثل AIME میشود.
پنجرهٔ زمینه (Context Window) چهار برابر شده و به ۲۶۲,۱۴۴ توکن رسیده است. برای جلوگیری از «فراموشی» که معمولاً در مراحل تنظیم نظارتشده (SFT) با زمینه کوتاه رخ میدهد، تیم توسعه یک مرحله SFT مخصوص زمینه بلند در همان بازه کامل ۲۶۲ هزار توکنی اجرا کرد تا توانایی بازیابی دادهها در متون طولانی که معمولاً توسط SFT کوتاه تخریب میشود، بازیابی شود.
پسآموزش و همراستاسازی
فرآیند پسآموزش از یک خط لوله پنجمرحلهای دقیق پیروی کرد: SFT $
ightarrow$ SFT زمینه بلند $
ightarrow$ RL $
ightarrow$ DPO $
ightarrow$ SDPO.
- SFT: روی ۳.۷ میلیون نمونه متنی به همراه دادههای تصویری و گفتاری انجام شد. زنجیرههای استدلالی فقط به پرامپتهایی اضافه شدند که مدل بدون آنها قادر به حل نبود.
- RLVR: یادگیری تقویتی با پاداشهای قابل تأیید (Reinforcement Learning with Verifiable Rewards) روی حدود ۳۵۰ هزار پرامپت در حوزههای ریاضی، کد، پیروی از دستورات، چندزبانه و بینایی اعمال شد، در حالی که حالت تفکر به صورت متناوب فعال و غیرفعال میشد.
- DPO: برای بهبود کیفیت چت، استفاده از ابزار و ایمنی، از جفتهای ترجیحی امتیازدهیشده توسط داور استفاده شد. استخر ترجیحات و جفتهای آموزشی منتشر شدهاند.
- SDPO: مرحلهای تخصصی که از بازخورد داوران و خود-تقطیری (Self-distillation) برای اطمینان از پایبندی شدیدتر به منشور Apertus استفاده کرد تا شفافیت در ارزشها و اصول مدل ایجاد شود.
- استفاده از ابزار: آموزش تنها بر روی مسیرهای تأییدشده توسط اجرا (execution-verified trajectories) محدود شد تا قابلیت اطمینان در فراخوانی APIها و ابزارهای خارجی تضمین شود.
محکها و عملکرد
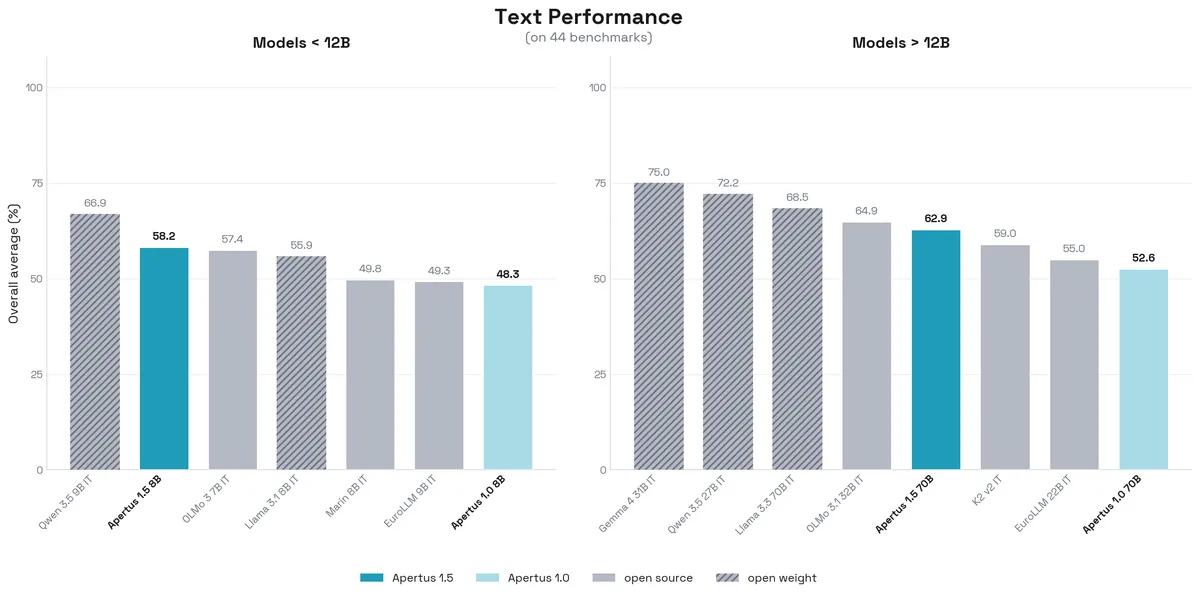
دامنه ارزیابی در نسخه ۱.۵ بهشدت گسترش یافت. تیم از خط لوله MLLM-eval-suite استفاده کرد که چارچوبهای lmms-eval و VLMEvalKit را برای تستهای چندوجهی ادغام میکند. بنچمارکهای متنی نیز از طریق نسخهای تغییریافته (Fork) از lm-evaluation-harness مدیریت شدند.
طبق گزارش فنی، مدل 8B در وظایف پیروی از دستورات (IF) و کارهای چندزبانه از مدلهای وزنباز هماندازه پیشی گرفته است. در ترجمه ماشینی، این مدل با GPT-OSS-20B برابری کرده و در محک Last Translation از Claude Haiku 4.5 و گوگل ترنسلیت بهتر عمل کرده است.
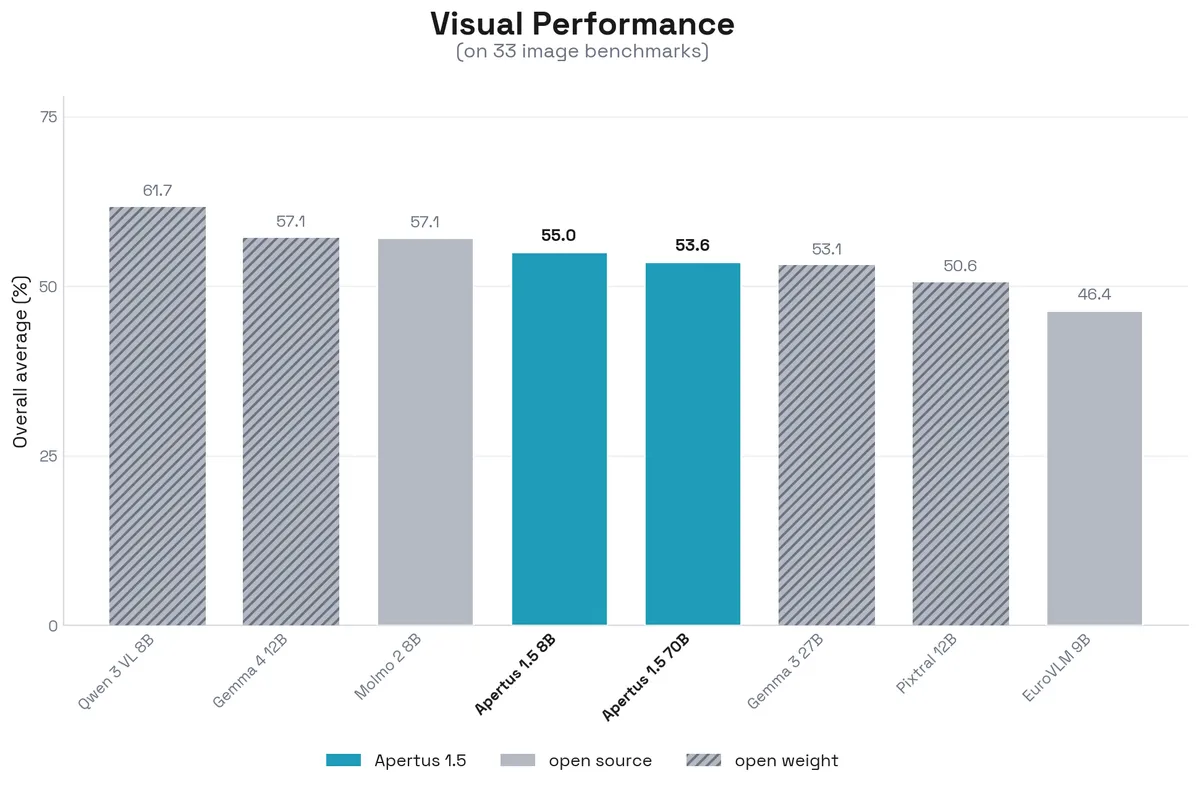
عملکرد چندوجهی این مدل با Gemma 4 12B رقابتی است، بهویژه در درک فضایی (Spatial Understanding) در میان مدلهای وزنباز و تحلیل اسناد و نمودارها در میان مدلهای متنباز. همچنین در وظایف حقوقی سوئیس (Swiss Legal)، برابری نزدیکی با مدلهای پیشرو وزنباز نشان داده است.
شفافیت رادیکال و بازتولیدپذیری
پروژه Apertus از طریق ائتلاف EvalEval به دنبال استاندارد جدیدی در حاکمیت هوش مصنوعی است. آنها از طرح Every Eval Ever (EEE) استفاده میکنند که نه تنها امتیازات، بلکه تنظیمات دقیق تولید، هویت اجراکننده، نحوه دسترسی به مدل و نحوه تفسیر معیارها را ثبت میکند.
این گزارشدهی ساختاریافته با ۵۶ مورد از ۶۰ عنصر مورد نیاز ماده ۵۵ قانون هوش مصنوعی اتحادیه اروپا (EU AI Act) و کد رویه GPAI همراستا است. برای پشتیبانی از این هدف، پروژه موارد زیر را منتشر کرده است:
- دستورالعملهای کامل آموزش و تحلیلهای حذف (ablations) در گزارش فنی.
- نقاط بازرسی (Checkpoints) میانی شامل Base، SFT، RLVR و DPO در Hugging Face.
- ترکیبهای دادههای آموزشی و مجموعه SFT متنی در Hugging Face.
منابع دادهای دقیق شامل ناسا، Our World in Data، اسمیتسونیان و swisstopo برای مرحله سرمایش است و برای گسترش زمینه از وظایف مصنوعی LongContextQA استفاده شده است. همچنین از Megatron-LM برای اسکریپتهای اجرا و کتابخانه verl برای مراحل RL و DPO بهره گرفته شده است.
جزئیات پیادهسازی فنی
برای تضمین بازتولیدپذیری کامل، ابزارهای مورد استفاده در چرخه آموزش به تفصیل ذکر شده است:
- پیشآموزش (مراحل ۱-۲): استفاده از Megatron-LM و اسکریپتهای خاص در
pretrain-code. توکنسازی توسطapertus-omni-tokenizerو توکنسازهای تصویر و صوت بنچمارک، شامل یک سازنده متنی-گفتاری درهمتنیده انجام شد. - پیشآموزش (مرحله ۳): ادامه کار با Megatron-LM و مجموعهدادههای منتخب از ناسا، Our World in Data، اسمیتسونیان و swisstopo.
- گسترش زمینه: پیادهسازی از طریق Megatron-LM با استفاده از وظایف مصنوعی LongContextQA.
- SFT و SFT زمینه بلند: استفاده از مخزن
posttraining-dataو اسکریپتهای اجرای SFT در Megatron-LM. - RL (RLVR) و DPO: بهرهگیری از کتابخانه
verlو دستورالعملهایverl-recipeبرای یادگیری تقویتی و بهینهسازی ترجیحات. - SDPO: برای مدل 8B، همراستاسازی از طریق self-distillation با استفاده از
gretelai/gretel-safety-alignment-en-v1انجام شد.
یافتههای تحلیل حذف (Ablation)
گزارش فنی به یافتههای کلیدی اشاره میکند. یکی از مشاهدات اصلی این است که ترکیب دادههای چندوجهی با دادههای متنی در مرحله SFT، عملکرد را در تمام مودالیتهها بهبود میبخشد.
علاوه بر این، تیم دریافت که مزایای زنجیرههای استدلالی چندوجهی حتی پس از یادگیری تقویتیِ صرفاً متنی نیز باقی میماند. بهطور مشخص، شروع از یک نقطه بازرسی SFT که با ردپاهای استدلالی چندوجهی آموزش دیده بود، منجر به پیشرفتهای بیشتری در ریاضیات طی مرحله RL شد در مقایسه با شروع از یک نقطه بازرسی صرفاً متنی. این مزیت استدلالی در سراسر فرآیند آموزش حضور داشت.
ادغام در اکوسیستم
این مدلها هماکنون در اپلیکیشنهایی مانند Proton Lumo و Infomaniak Euria فعال هستند. دسترسی API نیز توسط Swisscom، Infomaniak، Phoeniqs و سایر ارائهدهندگان فهرست شده در راهنمای General Availability فراهم شده است.
در مورد آینده، تیم در اجلاس AI+X در زوریخ، نقشه راه Apertus 2.0 را معرفی کرد. نسل بعدی به معماری ترکیب خبرهها (MoE) با حدود ۶۰۰ میلیارد پارامتر کل منتقل خواهد شد و برنامه آموزشی گستردهتری خواهد داشت که اولویت را بر عاملها (Agents)، ریاضیات و کدنویسی قرار میدهد.
این چرخش به سمت معماریهای عظیم MoE نشان میدهد که پروژه قصد دارد مرزهای استدلال در مدلهای وزنباز را جابهجا کند، در حالی که تعهد خود به دادههای باز و ارزشهای اخلاقی را حفظ میکند. این پروژه اخیراً رکورد ۵ میلیون دانلود در Hugging Face را ثبت کرد.
پژوهشگران و توسعهدهندگان اکنون میتوانند وزنها را تحت لایسنس Apache 2.0 دانلود کرده و گزارش فنی کامل را در arXiv (2610.15542) با عنوان «Apertus 1.5: From Open Text Models to Open Multimodal Reasoners» مطالعه کنند.
گام بعدی شما
- اگر روی تحلیل اسناد پیچیده یا نمودارهای فنی کار میکنید، مدل 70B را برای تست درک فضایی امتحان کنید.
- برای بهبود دقت در کارهای ریاضی، «حالت تفکر» را فعال کرده و زنجیرههای استدلالی مدل را تحلیل کنید.
- مخزن apertus-data-transparency را بررسی کنید تا متوجه شوید دادههای باکیفیت چگونه برای آموزش مدلهای باز جمعآوری میشوند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو