اگر امروز برای آموزش مدلهای استدلالی بودجهای محدود دارید، دیگر مجبور نیستید بین دقت و هزینه یکی را انتخاب کنید. مدل DAPO-Qwen-32B توانست در محک AIME 2024 به امتیاز ۵۰ برسد و در حالی که تنها نیمی از گامهای آموزشی مدلهای پیشین را طی کرده بود، آنها را به چالش بکشد. این نتیجه نشاندهنده یک تغییر جهت قابل توجه در نحوه آموزش بهینه مدلهای زبانی بزرگ (LLM) برای استدلالهای پیچیده ریاضی است.
این دستاورد در حالی رخ میدهد که صنعت به سمت استدلال «سیستم ۲» حرکت میکند؛ یعنی مدلهایی که بهجای پیشبینی سریع توکن بعدی، مسائل را گامبهگام تحلیل میکنند. مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — اکنون از طریق یادگیری تقویتی (Reinforcement Learning) — شبیه به آموزش یک سگ با پاداش برای رفتارهای درست — به جای پیشآموزش ساده، صیقل داده میشود. همانطور که در تحلیل قبلی ما دربارهی دستورالعملهای پیشآموزش کمهزینه مثل Magic اشاره کردیم، تمرکز اکنون از «چگونه مدل را پیشآموزش دهیم» به «چگونه آن را با استفاده از یادگیری تقویتی (RL) اصلاح کنیم» تغییر کرده است. این رویکرد در ادامه تلاشهایی است که در دستوردهٔ پیشآموزش Magic برای کاهش ۱۰ برابری هزینههای محاسباتی مدلهای باز دنبال شده بود. برای اکثر توسعهدهندگان، RL تاکنون مانند یک «جعبه سیاه» بوده که تنها در اختیار آزمایشگاههایی با بودجههای عظیم پردازشی قرار داشت.
به نقل از مستندات پروژه، تیمهای ByteDance Seed و Tsinghua AIR برای شکستن این سد، الگوریتم DAPO (بهینهسازی سیاست نمونهبرداری پویا و برش مجزا - Decoupled Clip and Dynamic sAmpling Policy Optimization) را بهصورت متنباز منتشر کردند. این سامانه بر پایه چارچوب verl بنا شده و دستورالعمل کامل برای RL در مقیاس بزرگ، شامل زیرساخت کد و مجموعه دادههای منتخب DAPO-Math-17k را ارائه میدهد تا دسترسی به یادگیری تقویتی مقیاسپذیر برای جامعه پژوهشی و کل جامعه ممکن شود.
زیرساخت و بازتولید
این پروژه برای حداکثر بازتولیدپذیری طراحی شده است. تیم توسعه یک سیستم کاملاً متنباز برای RL مدلهای زبانی بزرگ در مقیاس وسیع ارائه کرده است که الگوریتم، زیرساخت کد و مجموعه دادهها را در بر میگیرد. هدف این تلاش، فراهم کردن دسترسی عملی به یادگیری تقویتی مقیاسپذیر برای محققان است.
آموزش این مدل روی پلتفرم یادگیری ماشین Volcano Engine انجام شده است. تیم متعهد شده است که یک راهنمای کامل بازتولید را در این پلتفرم ارائه دهد تا کاربران بتوانند آزمایشها را دقیقاً تکرار کنند. این سیستم برای دستیابی به عملکرد در سطح استانداردهای جهانی (SoTA)، از قابلیتهای چارچوب verl بهره میبرد.
گسستهای فنی در آموزش
سامانه DAPO برای پایدار کردن آموزش از دو مکانیزم اصلی استفاده میکند:
- برش مجزا و نمونهبرداری پویا: این قابلیت به مدل اجازه میدهد مسیرهای استدلالی پیچیدهتری را جستوجو کند بدون اینکه در تکرارهای بیپایان یا خروجیهای تصادفی سقوط کند.
- تابع زیان PG در سطح توکن: یک تابع زیان (Loss Function) اصلاحشده — شبیه به یک خطکش دقیق که به مدل میگوید دقیقاً کدام کلمه یا بخش از زنجیره تفکر باعث رسیدن به جواب درست شده است — که یادگیری را بهینهتر میکند.
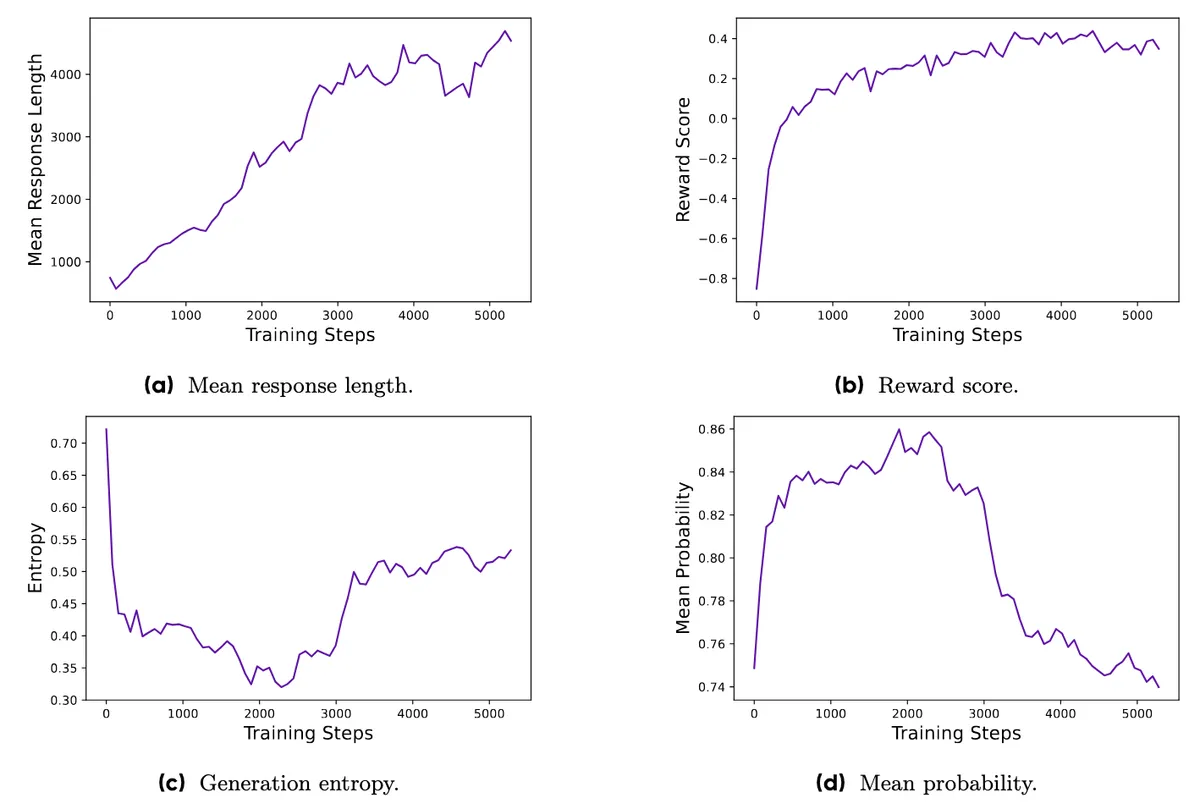
بر اساس بررسی مخزن گیتهاب این پروژه، تیم سه معیار حیاتی را برای تضمین پایداری در طول آموزش رصد کرده است:
- پایداری و رشد طول پاسخ: افزایش تدریجی و ثابت در طول پاسخها به مدل اجازه میدهد تا فضای بیشتری را برای اکتشاف داشته باشد. این امر توانایی مدل را برای یادگیری رفتارهای استدلالی پیچیدهتر تسهیل کرده و به پایداری کلی آموزش کمک میکند.
- پایداری امتیاز پاداش: رشد پایدار در سیگنال پاداش نشان میدهد که مدل با موفقیت در حال انطباق با توزیع دادههای آموزشی است. این موضوع تضمین میکند که فرآیند یادگیری بدون نوسانات شدید، مستحکم و سازگار باقی میماند.
- روند آنتروپی و احتمال میانگین: تیم توانست پس از یک کاهش اولیه، افزایش کنترلشدهای در آنتروپی ایجاد کند. این کار باعث ایجاد تعادل سالم بین «اکتشاف» (Exploration) مسیرهای جدید و «بهرهبرداری» (Exploitation) از دانش موجود میشود تا مدل دچار بیشبرازش (Overfitting) — شبیه به دانشآموزی که سوالات را حفظ میکند اما مفهوم را نمیفهمد — یا تصادفیشدن بیش از حد نشود.
تحلیل بنچمارکها
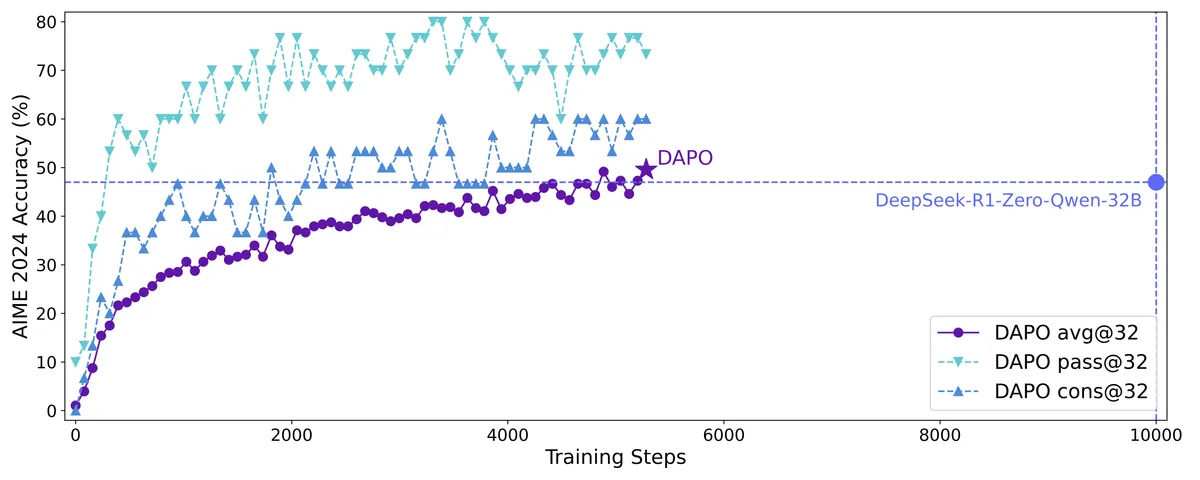
بهرهوری این روش خیرهکننده است. پیادهسازی کامل DAPO بر روی مدل پایه Qwen2.5-32B توانست به امتیاز ۵۰ در AIME 2024 دست یابد. این نتیجه از مدل پیشین SoTA یعنی DeepSeek-R1-Zero-Qwen-32B برتر است، در حالی که تنها ۵۰٪ گامهای آموزشی آن را طی کرده است.
برای اعتبارسنجی اثر مکانیزمهای خاص خود، تیم سوابق آموزشی نسخهای اولیه از DAPO را منتشر کرد. این نسخه که فاقد «نمونهبرداری پویا» و «تابع زیان PG در سطح توکن» بود، تنها به دقت ۴۴٪ در AIME 2024 رسید. این موضوع ثابت میکند که جهش عملکرد ناشی از انتخابهای الگوریتمی خاص در DAPO است و نه صرفاً استفاده از دادههای بیشتر.
استقرار و کاربرد عملی
برای متخصصان و توسعهدهندگان، این سیستم برای کاربرد فوری طراحی شده است. تیم وزنهای مدل DAPO-Qwen-32B و دستورالعملهای دقیق برای راهاندازی محیط با استفاده از conda (پایتون ۳.۱۰) را ارائه کرده است.
استقرار مدل برای استنتاج با توان عملیاتی بالا (High-throughput) با استفاده از Ray Serve و vLLM بهینه شده است. برای ارزیابی روی AIME 2024، پیکربندی پیشنهادی شامل موارد زیر است:
- Temperature (دما): ۱.۰
- Top_p: ۰.۷
- Max tokens (حداکثر توکن): ۲۰,۴۸۰
- Tensor-parallel-size: ۸
این تحول نشان میدهد عصر «زور خالص» در یادگیری تقویتی — جایی که هرچه GPU بیشتر، استدلال بهتر — در حال پایان است. DAPO با مجزا کردن فرآیندهای برش و نمونهبرداری ثابت کرد که کارایی الگوریتمی میتواند جایگزین ساعتهای گرانقیمت پردازشی شود و سد ورود آزمایشگاههای کوچک را برای ساخت مدلهای استدلالی که با غولهای این صنعت رقابت کنند، بشکند.
اگر در حال ساخت برنامههایی با تمرکز بر ریاضیات هستید، ارزش فوری این پروژه در وزنهای متنباز و دستورالعمل آموزش آن است. دیگر نیازی به حدس زدن ابرپارامترها برای RL ندارید و میتوانید با یک خط مبنای تأییدشده شروع کنید که از نسخههای اولیه R1-Zero پیشی گرفته است.
توسعهدهندگان اکنون میتوانند وزنهای مدل را مستقیماً از Hugging Face (در مسیر BytedTsinghua-SIA/DAPO-Qwen-32B) دریافت کنند یا آموزش را روی پلتفرم Volcano Engine بازتولید نمایند. نقطه عطف بعدی این خواهد بود که ببینیم آیا این بهرهوری در وظایف استدلالی غیرریاضی مانند کدنویسی یا تحلیلهای حقوقی نیز تکرار میشود یا خیر. در این راستا، رقابتهای شدید در بنچمارکهای کدنویسی، مانند پیشی گرفتن Claude Opus 4.8 از GPT-5.5، نشان میدهد که استانداردهای عملکردی در حال جابجایی سریع هستند.
گام بعدی شما
- وزنهای مدل DAPO-Qwen-32B را از Hugging Face دریافت و روی دادههای تخصصی خود تست کنید.
- برای کاهش هزینه آموزش مدلهای استدلالی، مکانیزم «برش مجزا» را در خط لوله RL خود پیادهسازی کنید.
- مستندات پلتفرم Volcano Engine را برای بازتولید دقیق نتایج مطالعه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو