اگر به دنبال جایگزینی برای مدلهای استدلالی بسته هستید که بدون ریسک حریم خصوصی روی سختافزار محلی اجرا شوند، خانواده Granite 4.2 دقیقاً برای همین هدف طراحی شده است. این مدلها برخلاف اکثر مدلهای زبانی که فقط دستورات را اجرا میکنند، بر روی «تفکر تأملی» متمرکز شدهاند تا پاسخهایشان صریح و قابل راستیآزمایی باشد.
طبق اعلام IBM در ۲۵ اوت ۲۰۲۶، این مدلها به کاربران اجازه میدهند بین حالتهای «متفکر» و «غیرمتفکر» سوئیچ کنند تا تعادلی میان سرعت استنتاج و عمق استدلال برقرار شود. هر مدل در این خانواده میتواند پیش از ارائه پاسخ نهایی، یک زنجیره تفکر (Chain-of-Thought) — شبیه وقتی شاگرد ریاضی پای تخته بلند بلند فکر میکند تا به جواب برسد — تولید کند. همچنین یک حالت «کمتلاش» (low-effort) برای پاسخ به سؤالات ساده پیشبینی شده تا بودجه محاسباتی کوتاهی صرف شود و منابع بیهوده مصرف نشود. این رویکرد بهینهسازی هزینهها یادآور مدلهای جدیدی است که تلاش میکنند هزینه استنتاج را از ساختار سنتی تعداد توکنها جدا کنند تا بهرهوری اقتصادی مدلها افزایش یابد.
این عرضه در زمانی رخ میدهد که صنعت از رابطهای چت ساده به سمت عاملهای خودمختار (Autonomous Agents) حرکت میکند. همانطور که در تحلیل قبلی ما دربارهی گردشکارهای ترکیبی مدلهای محلی و APIهای ابری اشاره کردیم، IBM مدل Granite 4.2 را به عنوان ستون فقرات آماده برای استقرار استکهای عاملمحور محلی معرفی میکند. این مدلها تحت لایسنس Apache 2.0 منتشر شدهاند و هدف آنها توسعهدهندگانی هستند که به قابلیتهای استدلالی بالا نیاز دارند اما نمیخواهند ریسکهای حریم خصوصی APIهای بسته را بپذیرند. این مدلها از طریق نقاط انتهایی سازگار با OpenAI (مانند vLLM) و همچنین SGLang قابل سرویسدهی هستند.
معماری و بنیاد پیشآموزش
خانواده Granite 4.2 شامل سه مدل ترنسفورمر (Transformer) متراکم و فقط-رمزگشا (decoder-only) در اندازههای ۳، ۸ و ۳۰ میلیارد پارامتر است. هر سه مدل از یک طراحی هستهای مشترک بهره میبرند که شامل مکانیزم توجه پرسوجوی گروهی (GQA) با ۴۰ سر توجه و ۸ سر KV است. همچنین از رمزگذاری موقعیت دورانی (RoPE) با مقدار $\theta = 10,000,000$ استفاده میکنند. در لایههای MLP از فعالساز SwiGLU و نرمالسازی RMSNorm با $\epsilon = 1e-5$ بهره گرفتهاند. نکته مهم این است که جاسازیهای (embeddings) ورودی و خروجی در این مدلها مجزا هستند (tied نیستند) و با دقت bfloat16 ارائه شدهاند.
مشخصات فنی دقیق مدلها به شرح زیر است:
- مدل 3B Dense: دارای ۴۰ لایه، اندازه بردار معنایی ۲۵۶۰، اندازه پنهان MLP ۸۱۹۲، ۴۰ سر توجه و اندازه هر سر ۶۴.
- مدل 8B Dense: دارای ۴۰ لایه، اندازه بردار معنایی ۴۰۹۶، اندازه پنهان MLP ۱۲۸۰۰، ۳۲ سر توجه و اندازه هر سر ۱۲۸.
- مدل 30B Dense: دارای ۶۴ لایه، اندازه بردار معنایی ۴۰۹۶، اندازه پنهان MLP ۳۲۷۶۸، ۳۲ سر توجه و اندازه هر سر ۱۲۸.
بر اساس مستندات فنی، پیشآموزش این مدلها یک عملیات عظیم بود که حدود ۱۵ تریلیون توکن (Token) را در بر میگرفت. آیبیام از یک استراتژی پنجمرحلهای برای ساخت مدلهای پایه استفاده کرد. دو فاز اول بر ایجاد دانش بنیادی متمرکز بود، در حالی که فازهای سوم و چهارم بر «میانی-آموزش» (mid-training) با استفاده از دادههای پالایششده با کیفیت بالاتر متمرکز شدند. در مرحله نهایی، آموزش با متنهای طولانی (long-context training) معرفی شد که پنجره متنی (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد — را به مقدار عظیم ۵۱۲ هزار توکن افزایش داد. هر فاز از یک ترکیب دادهای مجزا و برنامه نرخ یادگیری (learning-rate schedule) خاص استفاده کرد که به تدریج از دادههای گسترده وب به سمت منابع منتخب و تخصصی تغییر یافت.
تنظیم نظارتشده (SFT) و کنترل کیفیت
برای تبدیل مدلهای پایه به دستیاران هوشمند، آیبیام از تنظیم نظارتشده (SFT) — شبیه وقتی به یک پزشک عمومی تخصص پوست میدهیم تا روی یک حوزه دقیق شود — با ۷.۲ میلیون نمونه (حدود ۱۰۰ میلیارد توکن) استفاده کرد که از این مقدار، حدود ۶۵ میلیارد توکن قابل آموزش بودند. توزیع دادهها به دو بخش تقسیم شد:
۱. دادههای عاملمحور (۳۱.۶٪): این مجموعه عمدتاً توسط مهندسی نرمافزار (۶۹٪) تسلط یافته بود و پس از آن فراخوانی ابزار (۱۲.۱٪)، استفاده از ترمینال (۸.۰٪)، ریاضیات (۳.۵٪)، جستوجو (۰.۸٪) و اکشن (۰.۲٪) قرار داشتند. این دادهها با استفاده از چارچوبهایی مانند OpenHands, OpenCode, Terminus-2, SWE-agent, OpenResearcher, MiniSWE, OpenSeeker, EnvScaler, Gemini CLI, Hermes, Codex و Goose تولید شده بودند. در این راستا، رقابت میان مدلهای بزرگ و کوچک برای تسلط بر این حوزه شدت یافته است، بهطوری که برخی مدلهای بسیار کوچک حتی در فراخوانی ابزارها از مدلهای بزرگتر پیشی گرفتهاند.
۲. دادههای غیرعاملمحور (۶۸.۴٪): شامل پیروی از دستورات (۱۸.۸٪)، کدنویسی (۱۸.۸٪)، ریاضیات (۱۴.۶٪)، چندزبانه (۷.۰٪)، علوم (۵.۴٪)، استدلال (۳.۰٪) و ایمنی (۰.۸٪) بود.
برای کنترل کیفیت، آیبیام ابتدا دادهها را به فرمت استاندارد OpenAI Chat تبدیل کرد. سپس از مدلهای Gemma 4 و GPT-OSS-120B به عنوان داور (LLM judges) استفاده کرد تا توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که وجود ندارد —، اطلاعات ساختگی و فراخوانیهای نامعتبر ابزارها را حذف کند. همچنین برای اطمینان از اینکه مجموعه آموزشی فشرده و با سیگنال بالا باقی بماند، از حذف دادههای تکراری (deduplication) مبتنی بر هش SHA-256 روی ترکیب فیلدهای ابزارها و پیامها استفاده کردند.
آموزش SFT روی ۳۲ تا ۱۲۸ نود (بسته به اندازه مدل) با ۴ عدد Grace/GB200 در هر نود انجام شد. پیکربندی شامل طول توالی بستهبندی شده ۱۳۱,۰۷۲ (128K)، اندازه دسته جهانی (global batch size) ۱۲۸ و نرخ یادگیری 1.0e-5 (ثابت پس از گرمشدن ۲.۵٪) بود. موازیسازی با TP=2، PP=1 و CP=4 یا CP=2 تنظیم شده بود.
برای مدل 30B، آیبیام یک فاز SFT دوم را اضافه کرد. این فاز بهطور خاص دادههای عاملمحور، SWE و کدنویسی را افزایش داد (upsampled) تا توانایی مدل در مدیریت مخازن پیچیده نرمافزاری تقویت شود. حدود ۱۶٪ از ترکیب دادهها به عنوان دادههای بازپخش (replay data) از مجموعه SFT اصلی حفظ شد و مدل برای حدود یک اپوک اضافی با نرخ یادگیری پایینتر 3.0e-6 تنظیم شد.
خط لوله یادگیری تقویتی (RL) مرحلهبندیشده
قلب تپنده Granite 4.2، برنامه آموزشی یادگیری تقویتی است. آیبیام به جای یک مرحله بزرگ، از زنجیرهای از مراحل متمرکز استفاده کرد که هر کدام از نقطه بازرسی (checkpoint) قبلی شروع میشدند.
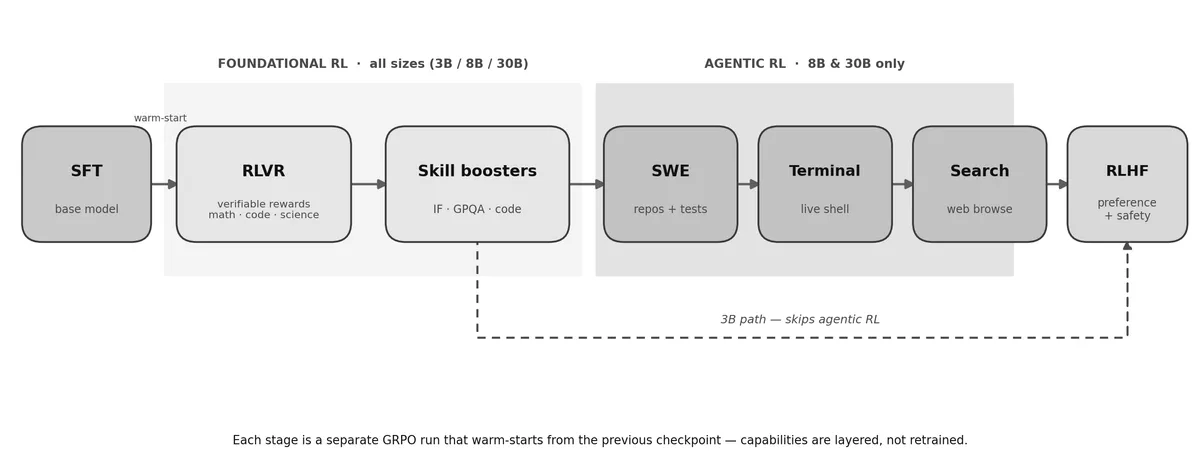
همه مدلها با RLVR (یادگیری تقویتی از پاداشهای قابل تأیید) شروع کردند. در این مرحله از پاداشهای عینی — مانند تستهای واحد (Unit Tests) و بررسیکنندههای ریاضی — استفاده شد تا استدلال بنیادی شکل بگیرد. RLVR گستردهترین ترکیب دادهها را داشت و شامل ریاضیات (زنجیره تفکر با بررسی پاسخهای باکسشده و اثبات رسمی Lean)، کدنویسی رقابتی (تستهای پنهان در محیط Sandbox)، سوالات چندگزینهای STEM، پیروی از دستورات (خروجیهای ساختاریافته) و پازلهای استدلالی بود. RLVR برای مدلهای 3B و 8B دو دور و برای مدل 30B سه دور اجرا شد.
پس از آن، «تقویتکنندههای مهارت» (skill boosters) برای بهبود پیروی از دستورات (چتهای چند-راند، inverse-IFEval، خروجیهای ساختاریافته) و کدنویسی رقابتی اضافه شدند. اینها اجراهای کوچک و متمرکزی بودند که از جریمه KL سبک (۰.۰۵) استفاده میکردند تا مهارتهای خاص را بدون تخریب رفتارهای موجود تقویت کنند.
برای مدلهای 8B و 30B، یک بلوک «RL عاملمحور» اضافه شد تا مدلها در محیطهای واقعی (Sandbox) به جای محیطهای شبیهسازی شده عمل کنند.
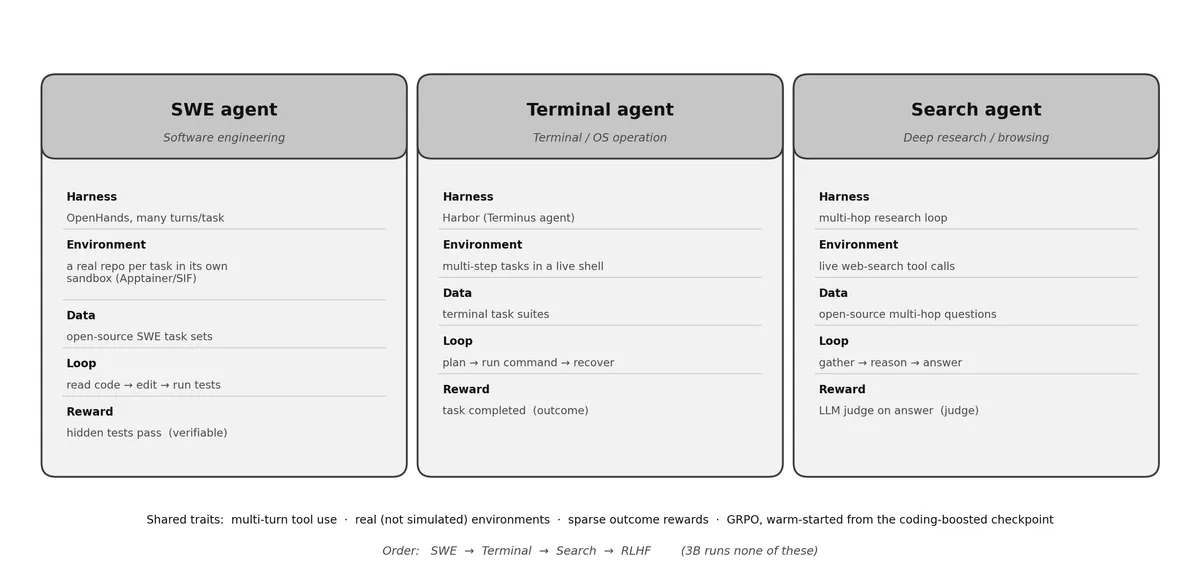
این بلوک طبق توالی سختگیرانه «مهندسی نرمافزار (SWE) $\rightarrow$ ترمینال $\rightarrow$ جستوجو» پیش رفت.
محیطهای RL عاملمحور:
- عامل SWE: از هارنس OpenHands با مخازن واقعی در محیطهای ایزوله استفاده میکند. مدل کدها را میخواند، فایلها را ویرایش میکند و تستها را اجرا میکند. پاداش به صورت باینری است: آیا تستهای پنهان پاس شدند؟
- عامل ترمینال: از Harbor / Terminus-2 برای تسکهای چندمرحلهای در یک شل (shell) زنده استفاده میکند. این مرحله حلقه چند-راند را در سطح GRPO پیش میبرد و خروجیها تا ۶۴ نوبت محیطی ادامه مییابند.
- عامل جستوجو: یک حلقه عامل مرورگر برای تحقیقات چند-گامی (multi-hop) است. چون درستی پاسخها باز است، پاداش توسط یک مدل داور (LLM judge) روی پاسخ نهایی داده میشود.
زیرساخت فنی و GRPO
آیبیام از الگوریتم بهینهسازی سیاست نسبی گروهی (GRPO) استفاده کرد که نیاز به یک شبکه ارزش (value network) مجزا را از بین میبرد و پاسخها را با میانگین پاداش یک گروه (یک خط مبنای leave-one-out) میسنجد. برای مثال، در RLVR، هر مرحله ۲۵۶ پرامپت را با ۱۶ پاسخ نمونهبرداری شده برای یک دسته ۴,۰۹۶ نمونهای جفت میکند.
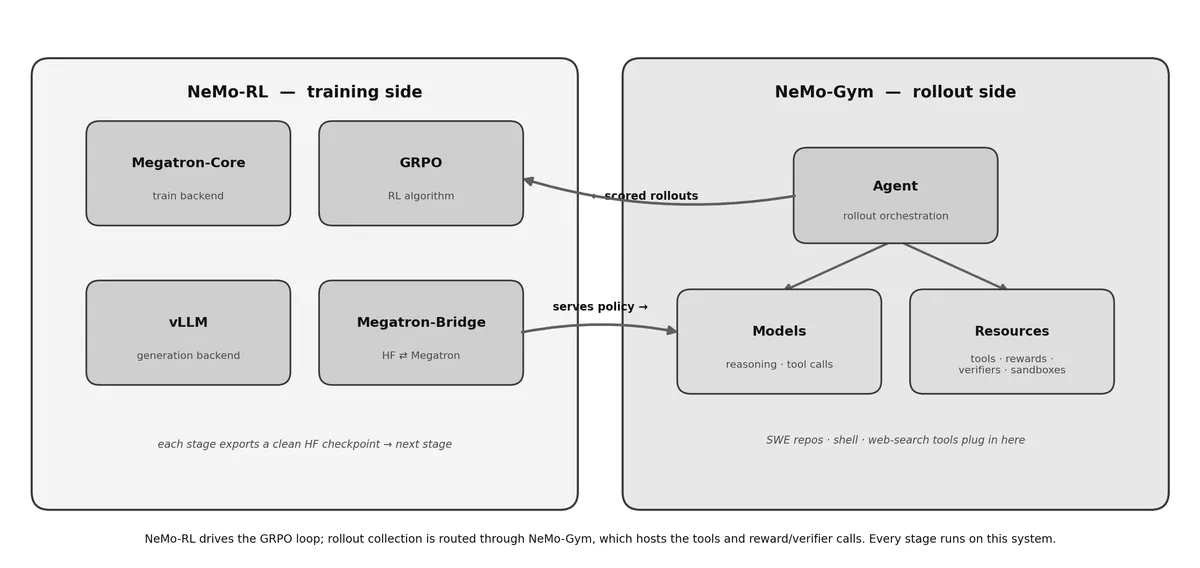
این زیرساخت از طریق یک حلقه ناهمگام (asynchronous) با استفاده از NeMo-RL و NeMo-Gym پیادهسازی شد. کارگران تولید (generation workers) و آموزشدهندگان روی استخرهای GPU مجزا عمل میکردند تا از بیکار ماندن سختافزار جلوگیری شود. برای مدیریت عدم تطابق بین آموزشدهنده و تولیدکننده، آیبیام از نمونهبرداری اهمیت کوتاه شده (truncated importance sampling) برای محدود کردن نسبت احتمال لگاریتمی استفاده کرد تا توکنهای قدیمی بر بهروزرسانیها غلبه نکنند. کارگران از KV cache موجود خود استفاده میکنند و آن را دوباره نمیسازند، به شرطی که بیش از یک بهروزرسانی از آموزشدهنده عقب نمانند.
جزئیات آموزش RL
ابرپارامترهای مشترک:
- الگوریتم: GRPO (بدون شبکه ارزش؛ مزایای نسبی گروهی)
- استک آموزشی: NeMo-RL (Megatron-Core + vLLM) با محیطهای NeMo-Gym
- Ratio Clip: 0.2 / 0.28
- Micro-batch Size: 1
- موازیسازی: Tensor-parallel 2–4؛ بدون موازیسازی خط لوله یا متن
تنظیمات خاص مراحل مدل 30B:
- RLVR (x3): ۲۵۶ پرامپت/گام، ۱۶ تولید/پرامپت، حداکثر طول توالی 64K، KL 0، نرخ یادگیری 5e-7
- IF Booster: ۲۵۶ پرامپت/گام، ۱۶ تولید/پرامپت، حداکثر طول توالی 64K، KL 0، نرخ یادگیری 5e-7
- Code Booster: ۶۴ پرامپت/گام، ۱۶ تولید/پرامپت، حداکثر طول توالی 64K، KL 0.05، نرخ یادگیری 5e-7
- SWE: ۱ پرامپت/گام، ۶۴ تولید/پرامپت، حداکثر طول توالی 128K، KL 0.01، نرخ یادگیری 5e-7
- SWE 2: ۳۲ پرامپت/گام، ۱۶ تولید/پرامپت، حداکثر طول توالی 128K، ۱۲۸ نوبت rollout، KL 0، نرخ یادگیری 5e-7
- Terminal: ۸ پرامپت/گام، ۳۲ تولید/پرامپت، حداکثر طول توالی 64K، ۶۴ نوبت rollout، KL 0.01، نرخ یادگیری 1e-6
- Search: ۳۲ پرامپت/گام، ۱۶ تولید/پرامپت، حداکثر طول توالی 128K، ۶۴ نوبت rollout، KL 0.01، نرخ یادگیری 5e-7
- RLHF: ۱۲۸ پرامپت/گام، ۱۶ تولید/پرامپت، حداکثر طول توالی 48K، KL 0.05، نرخ یادگیری 5e-7
تمام این استک روی یک خوشه NVIDIA GB200 NVL72 میزبانی شده توسط CoreWeave اجرا شد. سختافزار یک دامنه NVLink با ۷۲ پردازنده گرافیکی و یک شبکه InfiniBand NDR 400 Gb/s Fat-Tree غیرمسدودکننده را فراهم کرد که برای همگامسازی هزاران GPU در طول rolloutهای عظیم RL ضروری بود. استک نرمافزاری در قالب تصاویر کانتینری .sqsh با استفاده از تصویر پایه NGC PyTorch (اوبونتو ۲۲.۰۴، CUDA ۱۲.۸، پایتون ۳.۱۲) بستهبندی شد.
عملکرد و محکها
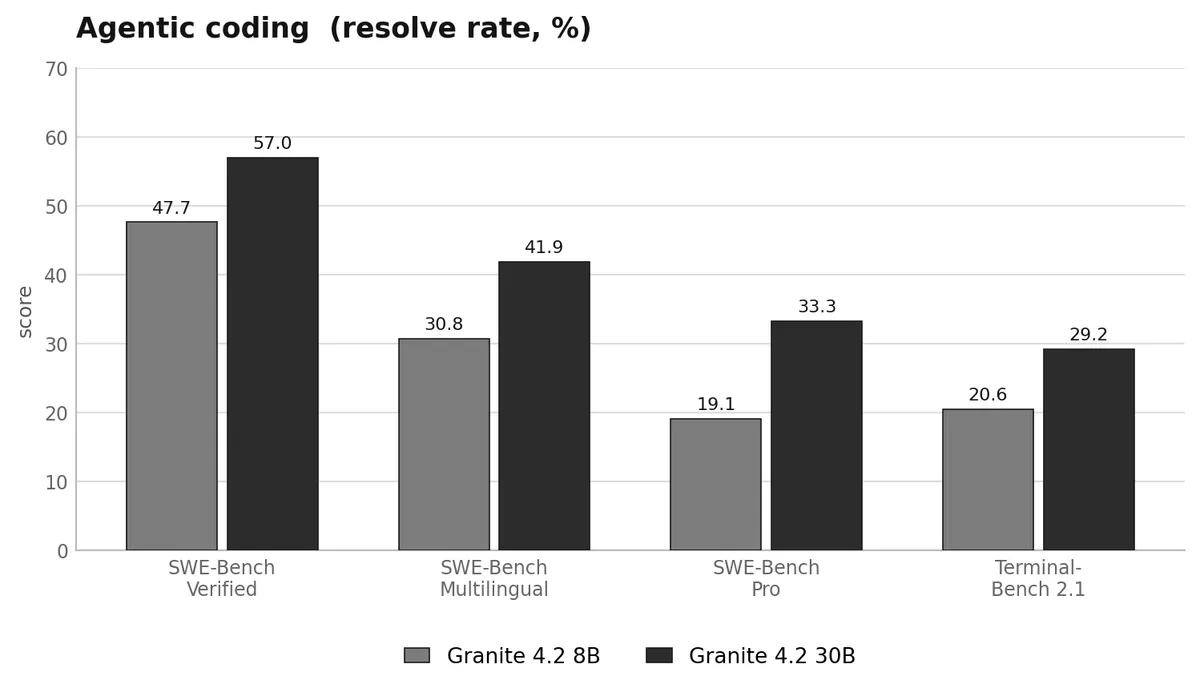
به نقل از گزارش فنی، مدل 30B در کدنویسی عاملمحور پیشتاز است و امتیاز ۵۷.۰۰ را در SWE-Bench Verified و ۲۹.۲۴ را در Terminal-Bench کسب کرد. همچنین امتیاز ۴۱.۸۹ در SWE-Bench Multilingual و ۳۳.۲۹ در SWE-Bench Pro به دست آورد.
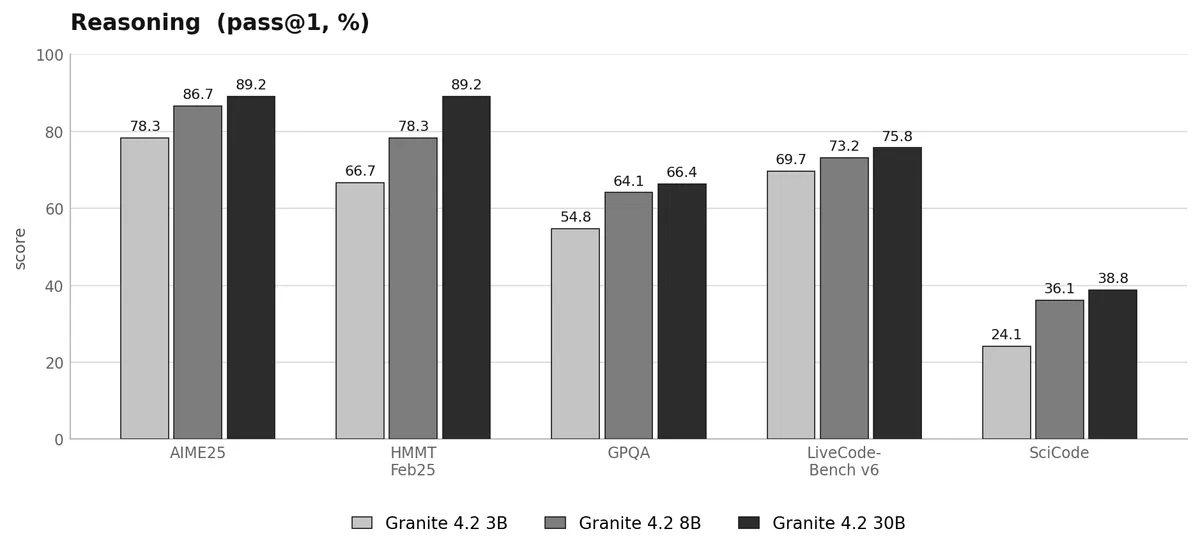
در زمینه استدلال خالص، مدل 30B در هر دو آزمون AIME25 و HMMT Feb25 به امتیاز ۸۹.۱۷ رسید که نشاندهنده پیروی از قوانین مقیاسپذیری (Scaling Laws) است؛ یعنی با افزایش اندازه مدل، توانایی استدلال به طور مستقیم بالا میرود. همچنین امتیاز ۶۶.۴۱ در GPQA و ۷۵.۷۷ در LiveCodeBench v6 را ثبت کرد.
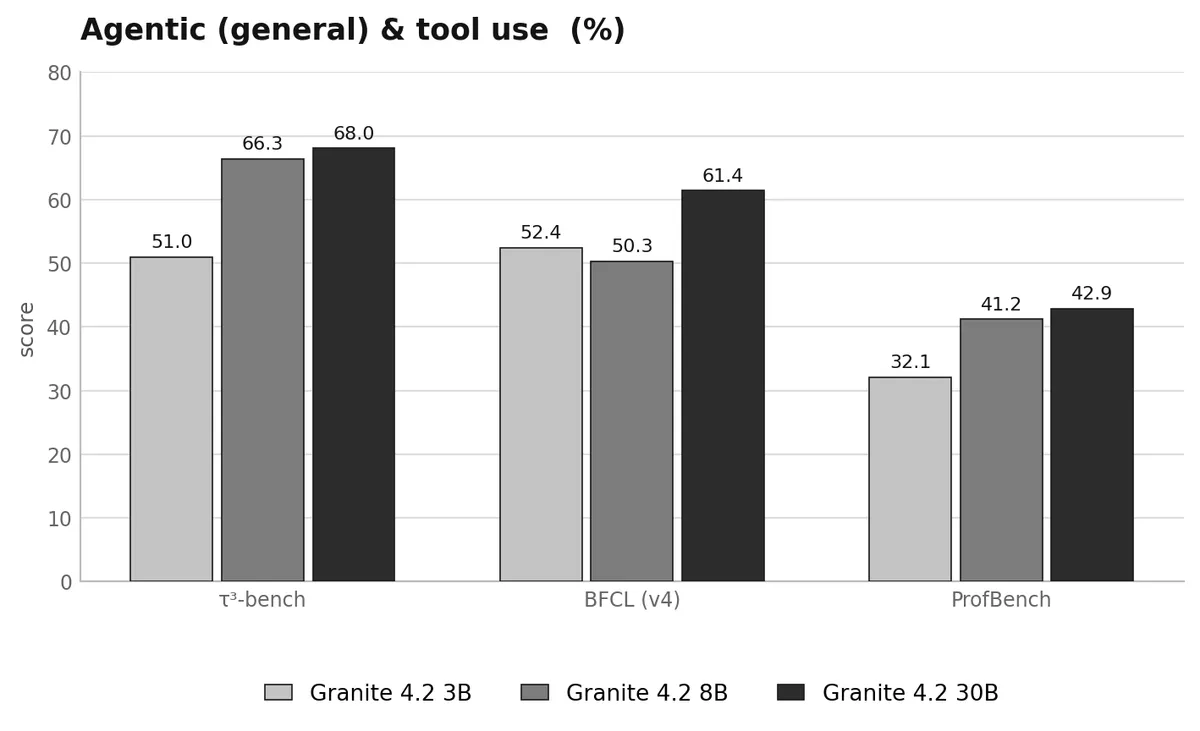
قابلیتهای عاملمحور عمومی نیز در تمام مدلها قوی بود. مدل 30B امتیاز ۶۸.۰۵ در $\tau^3$-bench و ۶۱.۳۹ در BFCL (v4) را به دست آورد که کارایی آن را به عنوان یک کاربر ابزار همهمنظوره ثابت میکند. مدل 3B، با وجود نداشتن بلوک RL عاملمحور، همچنان عملکرد خوبی در $\tau^3$-bench (۵۰.۹۹) و BFCL (۵۲.۴۱) داشت. سایر نتایج قابل توجه برای مدل 30B شامل ۴۲.۹۰ در ProfBench و ۱۲۲۵.۰۰ در GDPval است.
استقرار و کوانتش
برای دسترسی راحتتر، نسخههای کوانتش (Quantization) — یعنی کاهش دقت اعداد برای اشغال فضای کمتر در حافظه — در قالبهای FP8، NVFP4 و MXFP4 بهینهشده برای vLLM منتشر شدهاند. نسخه FP8 از وزنهای پویا در هر کانال و فعالسازهای در هر توکن استفاده میکند. نسخههای FP4 با استفاده از GPTQ و کالیبراسیون روی ۲ هزار نمونه از مجموعه SFT با حداکثر طول متن ۲ هزار توکن کوانتیده شدهاند.
برای کسانی که روی سختافزارهای مصرفکننده اجرا میکنند، فرمتهای GGUF از Q2_K تا Q8_0 از طریق llama.cpp در دسترس هستند. این شامل فرمتهای خاصی مانند Q4_K_M، Q5_K_S و Q6_K است. توسعهدهندگان میتوانند این مدلها را با استفاده از کتابخانه Transformers پیادهسازی کنند. مدلها از حالت تفکر low_effort برای سؤالات ساده پشتیبانی میکنند که با صرف حداقل بودجه استدلالی، در محاسبات صرفهجویی میکند.
تحلیل: تغییر به سمت عاملیت قابل راستیآزمایی
Granite 4.2 نشاندهنده تغییری در نحوه تفکر ما درباره آموزش مدلها است. آیبیام با قرار دادن پاداشهای قابل راستیآزمایی (ریاضی، کد) در ابتدای مسیر و سپس حرکت به سمت پاداشهای مبتنی بر ترجیحات (RLHF)، مدلی ساخته است که کمتر احتمال دارد یک مسیر استدلالی را «توهم» کند. مرحله نهایی RLHF یک جریمه برای طول استدلال اعمال میکند تا از رفتار بیش از حد پرحرف (verbose) که اغلب در طول RLVR به دست میآید، جلوگیری کند.
برای توسعهدهنده، این بدان معناست که مدلهای 8B و 30B را میتوان بدون نیاز به «کدهای چسب» (glue code) معمول برای رفع خطاهای فرمتبندی، مستقیماً در هارنسهای عاملمحور مانند OpenCode، Pi یا OpenHands قرار داد. پشتیبانی بومی از فراخوانی توابع سازگار با OpenAI، آنها را به جایگزینی مستقیم برای مدلهای استدلالی بسته در محیطهای محلی تبدیل میکند. این مدلها از طیف گستردهای از زبانها از جمله انگلیسی، آلمانی، اسپانیایی، فرانسوی، ژاپنی، پرتغالی، عربی، چکی، ایتالیایی، کرهای، هلندی و چینی پشتیبانی میکنند.
گام بعدی شما
- توسعهدهندگان باید قابلیتهای ترمینال مدل 30B را در یک محیط ایزوله تست کنند تا ببینند آیا میتواند جایگزین اسکریپتهای دستی CLI شود.
- برای بهینهسازی روی سختافزارهای لبه، مجموعه Granite HF را برای دریافت وزنهای کوانتیده جدید دنبال کنید.
- حالت
low_effortرا برای تسکهای ساده فعال کنید تا هزینه استنتاج را کاهش دهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو