تصور کنید ابزاری دارید که نه تنها زبان انسان را میفهمد، بلکه هرگز در محاسبات ریاضی اشتباه نمیکند. این دقیقاً همان چیزی است که ترکیب یک مدل زبانی کوچک و یک موتور ریاضی نمادین فراهم میکند. در حالی که موتورهای استدلال عظیم مبتنی بر ابر معمولاً به عنوان استاندارد برای منطق پیچیده شناخته میشوند، ادغام محلی Spark-X2.5-1.7B و SymPy ثابت میکند که مدلهای کوچک و محلی میتوانند استخراج دقیق پارامترها را مدیریت کنند. این سیستم یک خط لوله (Pipeline) قابل اعتماد برای تبدیل الزامات زبان طبیعی به ابعاد فیزیکی تأیید شده را به نمایش میگذارد.
بسیاری از مدلهای هوش مصنوعی در فاصله میان صحت جبری و واقعیت فیزیکی شکست میخورند؛ مثلاً ممکن است یک مسئله ریاضی پاسخی منفی تولید کند که در معادله درست است اما برای عرض یک جسم فیزیکی غیرممکن است. این نمایش با جداسازی استخراج دادهها از محاسبات نمادین و بررسی نهایی محدودیتها، این شکاف را پر میکند.
همانطور که در تحلیلهای قبلی ما دربارهی کاهش توهم در مدلهای بازمتن اشاره کردیم، کلید موفقیت در سپردن کارهای تخصصی به ابزارهای تخصصی است. در اینجا، مدل زبانی کوچک (SLM) — شبیه به یک دستیاری که فقط فرمهای ورودی را پر میکند و خودش تصمیم نمیگیرد — تنها وظیفه استخراج پارامترها را بر عهده دارد. این رویکرد بهینه در راستای ترند جدیدی است که در آن مدلهای کوچکتر با معماریهای بهینه، از رقبای بسیار بزرگتر خود در وظایف خاص پیشی میگیرند.
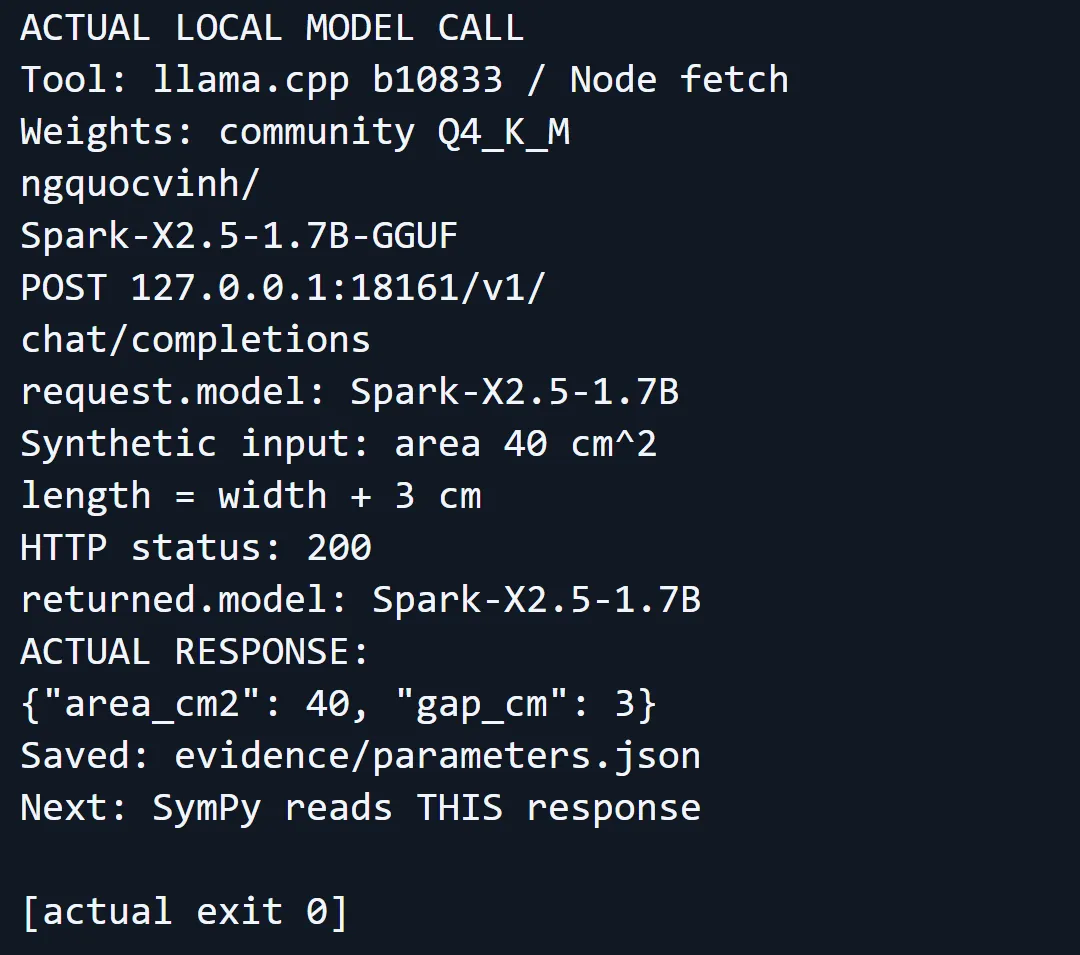
به نقل از گزارشی در dev.to که در ۱۶ اکتبر ۲۰۲۶ منتشر شد، این گردشکار از تقسیم کار دقیقی بهره میبرد. مدل Spark-X2.5-1.7B که از طریق نسخه llama.cpp b10833 (9ac8c408a) اجرا میشود، صرفاً به عنوان استخراجکننده پارامتر عمل میکند. در یک مورد آزمایشی شامل یک قطعه بستهبندی مستطیلی مصنوعی با مساحت ۴۰ سانتیمتر مربع و طولی که ۳ سانتیمتر بیشتر از عرض آن است، مدل یک شیء JSON تمیز برگرداند: {"area_cm2": 40, "gap_cm": 3}.
این JSON سپس به یک آداپتور محلی منتقل میشود که به SymPy 1.14.0، یک کتابخانه محاسبات علمی، متصل است. سیستم برای مدیریت ریاضیات نمادین از کتابخانه Scientific Agent Skills استفاده میکند؛ کتابخانهای که در ۱۶ اکتبر ۲۰۲۶ رتبه سوم ترندهای گیتهاب را به دست آورده بود. این پیادهسازی از نسخه ۱.۵ مهارتهای SymPy پیروی میکند که به کامیت مخزن a1043ef544e3a100c28e70a736b6cf32554d0677 متصل (Pinned) شده است. برای مدیریت چنین جریانهای کاری پیچیده در محیطهای محلی، استفاده از چارچوبهای متنباز مدیریت عاملها میتواند بهرهوری توسعهدهندگان را به شدت افزایش دهد.
جزئیات فنی اجرای این سیستم به شرح زیر است:
- محیط: ویندوز، پایتون ۳.۱۲، SymPy 1.14.0 و mpmath 1.3.0.
- وزنهای مدل: نسخه Q4_K_M GGUF از جامعه ngquocvinh (مشتق شده از مدل عمومی XHToken).
- تنظیمات استنتاج: دمای (Temperature) صفر، غیرفعال کردن قابلیت تفکر (Thinking disabled) و استفاده از یک طرحواره (Schema) عدد صحیح-JSON برای تضمین خروجی قطعی. درخواست ارسالی وضعیت HTTP 200 را برگرداند.
- منطق ریاضی: سیستم عرض را به عنوان
xو طول را به عنوانx + 3تعریف میکند. سپس عبارتx * (x + 3) - 40 = 0را با استفاده از تابعsolvesetدر دامنهdomain=S.Realsحل میکند. - اعتبارسنجی: آداپتور به جای ارزیابی رشتههای عبارتی تولید شده توسط مدل، از اعداد صحیح دقیق و اشیاء
Integerاستفاده میکند. همچنین SymPy مقدار SHA-256 فایل پارامتر مصرف شده را ثبت کرد.
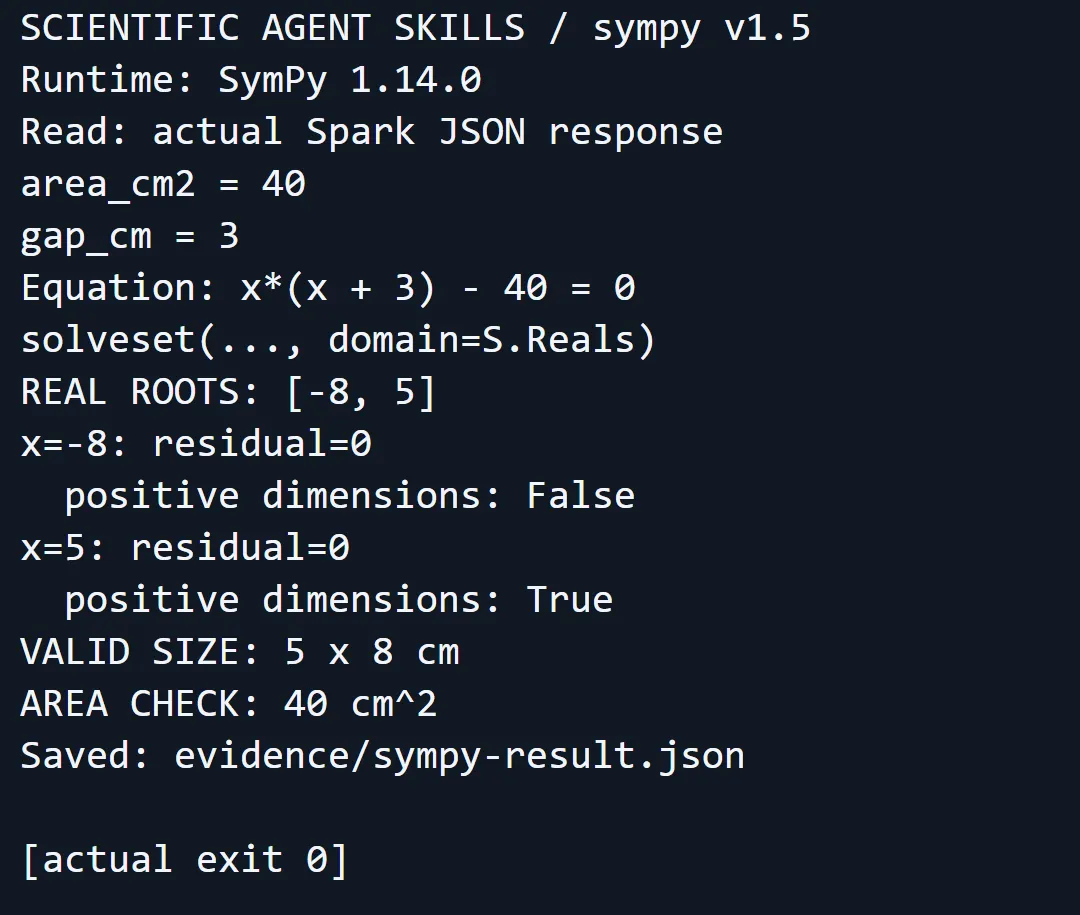
محاسبات دو ریشه -۸ و ۵ را برگرداند. جایگذاری هر یک از این ریشهها در عبارت اصلی، باقیماندهای برابر با صفر تولید کرد. در حالی که -۸ از نظر جبری معتبر است (که منجر به طول -۵ و حاصلضرب ۴۰ میشود)، بررسی نهایی سیستم، ابعاد منفی را فیلتر میکند. در نتیجه، عرض ۵ سانتیمتر و طول ۸ سانتیمتر به عنوان پاسخ نهایی تایید شد که کاملاً با الزامات مساحت (۵×۸=۴۰) و فاصله (۸-۵=۳) مطابقت دارد.
این پیادهسازی یک نمایش محلی است و نه یک ادغام رسمی. تصاویر ارائه شده، برشهای افقی از model.png و solve.png هستند که از ضبطهای ترمینال اصلی rec/model.mp4 و rec/solve.mp4 استخراج شدهاند. هر دو دستور اصلی با کد خروجی ۰ به پایان رسیدند.
برای بازتولید استخراج زبان طبیعی و محاسبات، توسعهدهندگان میتوانند از اسکریپتهای نمایشی model-call.mjs و solve-sizing.py موجود در دایرکتوری تحویل محلی استفاده کنند. این فرآیند شامل آمادهسازی پایتون با SymPy، باز کردن مهارت پین شده و اجرای حل عبارت در دامنه اعداد حقیقی است.
در واقع، بار «حقیقت» از دوش مدل زبانی برداشته شده و به محیط نمادین منتقل شده است تا احتمال توهم (Hallucination) — مثل دوستی که خاطرهای را اشتباه تعریف میکند — به صفر برسد. به جای اینکه از مدل بخواهیم ریاضیات را حل کند (جایی که ممکن است دچار توهم شود)، مدل فقط متغیرها را شناسایی میکند. محاسبات واقعی در یک محیط نمادین رخ میدهد که نتایج در آن دقیق و قابل تأیید هستند. برای توسعهدهندگان، این بدان معناست که اگر مدلهای بسیار کوچک (زیر ۲ میلیارد پارامتر) را در یک اعتبارسنج نمادین قرار دهید، میتوانید ابزارهای با دقت بالا بسازید. این کار نیاز به مدلهای گرانقیمت با استدلال بالا را برای کارهایی که از قوانین سخت ریاضی پیروی میکنند، کاهش میدهد.
گام بعدی شما
- اگر از مدلهای بزرگ برای محاسبات ریاضی استفاده میکنید، خروجیها را به یک کتابخانه نمادین مثل SymPy متصل کنید.
- برای کاهش هزینه استنتاج، از مدلهای زیر ۲ میلیارد پارامتر برای استخراج متغیرها (Variable Extraction) استفاده کنید.
- سیستمهای اعتبارسنجی فیزیکی (Physical Constraints) را به انتهای زنجیره پردازش خود اضافه کنید.
اما داستان سختافزاری اجرای این مدلهای کوچک روی دستگاههای لبه حتی شگفتانگیزتر است — به تحلیل ما دربارهی رایانش لبه مراجعه کنید.



گفتگو