تصور کنید یک توهم ساده از سوی هوش مصنوعی، تمام فایلهای حیاتی سیستمعامل شما را پاک کند. با اجرای Opencode در کنار Ollama روی مک و استفاده از محیطهای ایزوله Docker (داکر)، توسعهدهندگان میتوانند محیط اجرای مدل را کاملاً جدا کنند تا پایداری سیستم میزبان در حین ساخت اپلیکیشنهای وب حفظ شود. این رویکرد در ادامه روند گستردهتر انتقال پردازشها به محیطهای محلی است که رشد چشمگیر تعداد دانلودهای اولاما را به عنوان نشانهای از تغییر پارادایم به سمت هوش مصنوعی محلی تایید میکند.
توسعه مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — به نقطهای رسیده است که مدلهایی مانند Qwen 3.8 و Gemma 4 برای کدنویسی در سطح تولید (Production) کاربردی هستند. برای کاربران اپل سیلیکون، ادغام MLX در اولاما سرعت لازم برای عملیاتی کردن این گردشکار را فراهم کرده است. طبق راهنمای منتشر شده در ۱۱ سپتامبر ۲۰۲۶ از سوی Tensors & Tokens، یک مکبوک پرو M5 با ۴۸ گیگابایت رم، «نقطه بهینه» برای این تنظیمات است و میتواند مدلهای ۳۰ میلیارد پارامتری را با پنجره متنی کافی مدیریت کند. پیش از این نیز مشاهده کردیم که چگونه یک مکمینی با حافظه کمتر توانسته است با ترکیب اولاما و Qwen، جایگزینی برای ابزارهای ابری مانند گیتهاب کوپایلت باشد.
همانطور که در بحثهای گذشته ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، جداسازی محیط اجرا تنها راه مقابله با رفتارهای پیشبینینشده مدلهاست. برای پیادهسازی این معماری به سه ابزار نیاز دارید: Docker Sandbox (sbx) برای ایزولهسازی، Opencode به عنوان چارچوب توسعه و Ollama برای مدیریت مدلها. این ساختار نیازمند پیکربندی خاص sbx-kit است تا محیط ایزوله از طریق host.docker.internal:11434 به شبکه مک متصل شود.
پیکربندیهای پیشنهادی مدل
- Qwen 3.8 27B mxfp8: یک مدل ۳۲ گیگابایتی برای کارهای طولانی. برای جلوگیری از هنگ کردن سیستم، پنجره متنی (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد، شبیه میز کاری که جا برای چند ورق دارد — روی ۶۴ هزار توکن محدود شده است. در بررسیهای فنی ما، بهینهسازیهای مدل Qwen 3.8 نشان داد که اگرچه سرعت استنتاج در برخی موارد تغییر میکند، اما پاسخها با بهرهوری بیشتری به پایان میرسند.
- Gemma 4 31B mxfp8: مدلی متراکم با حجم ۳۴ گیگابایت برای تحلیل عمیق فایلها و استدلالهای پیچیده که از ۲۵۶ هزار توکن پشتیبانی میکند.
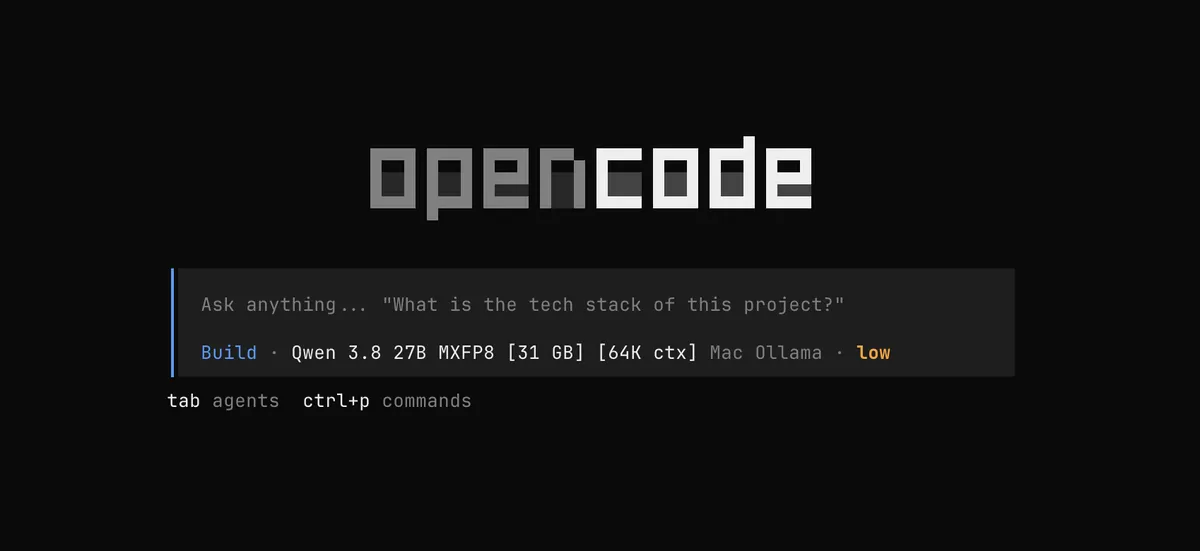
به گزارش Tensors & Tokens، کاربرانی که حافظه یکپارچه ۴۸ گیگابایتی ندارند، باید نسخههای استاندارد MLX این مدلها را دریافت کنند تا با خطای کمبود حافظه مواجه نشوند. این تنظیمات شامل ایجاد یک فایل spec.yaml برای تعریف مجوزهای شبکه در پورتهای ۱۱۴۳۴، ۵۱۷۳ و ۴۰۰۰ است.
این چرخش به سمت توسعه محلی در محیط ایزوله، این فرض قدیمی را میشکند که توسعهدهنده باید بین سرعت سیستم میزبان و امنیت کانتینر یکی را انتخاب کند. اکنون میتوان از تنظیمات «تلاش برای استدلال» (Reasoning Effort) در سطوح low تا xhigh در محیطی کاملاً کنترلشده استفاده کرد.
برای یک توسعهدهنده، این یعنی تبدیل لپتاپ به یک آزمایشگاه امن هوش مصنوعی. شما میتوانید روی اپلیکیشنهای پیچیده با مدلهای بالای ۳۰ میلیارد پارامتر کار کنید و مطمئن باشید که یک دستور توهمآمیز مثل rm -rf در محیط داکر زندانی شده و به سیستم شما آسیبی نمیزند.
گام بعدی شما
- ابزارهای مورد نیاز را از طریق Homebrew نصب کنید.
- فایل
opencode-local.jsonرا برای اتصال به نمونه Ollama خود پیکربندی کنید. - برای اجرای دستور
sbx runحتماً وارد حساب کاربری Docker شوید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو