تصور کنید دستیار صوتی شما بهجای تبدیل صدای شما به متن و سپس فکر کردن، مستقیماً با همان موجهای صوتی استدلال کند. این یعنی حذف تأخیرهای آزاردهنده و حفظ تمام ظرافتهای لحن و احساس در پاسخهای پیچیده.
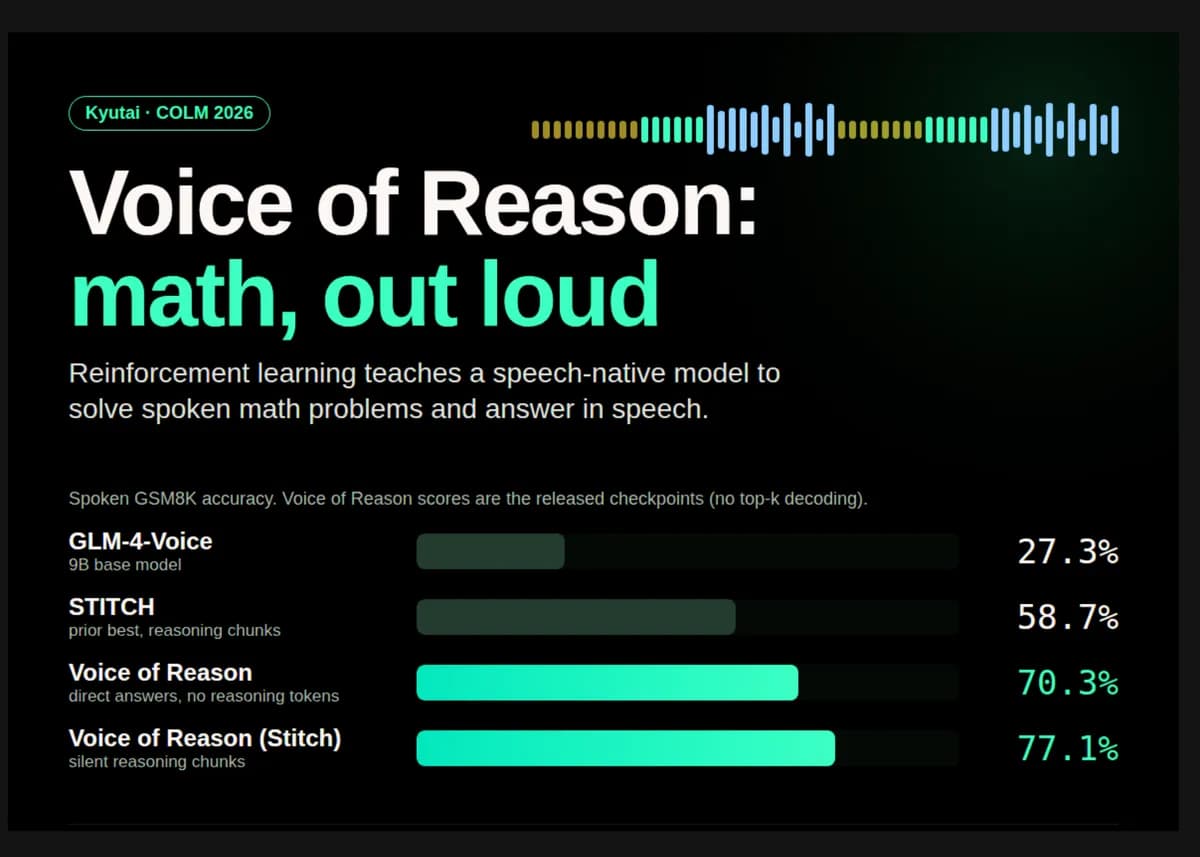
مدلهای Voice of Reason از شرکت Kyutai موفق شدند در محک GSM8K، صحت پاسخهای ریاضی صوتی را به ۷۷.۱٪ برسانند. این دستاورد یک چرخش راهبردی است؛ چراکه مدل را از وابستگی به خط لولههای متوالی (Cascaded Pipelines) — که بر مراحل مجزای تبدیل گفتار به متن (Speech-to-Text) و متن به گفتار (Text-to-Speech) تکیه دارند — رها میکند.
زمینه و بستر استدلال صوتی
اکثر دستیارهای صوتی فعلی از یک فرآیند سهمرحلهای استفاده میکنند: ابتدا صوت را به متن تبدیل (Transcribe) میکنند، سپس آن را با یک مدل زبانی بزرگ (LLM) پردازش کرده و در نهایت نتیجه را دوباره به گفتار تبدیل میکنند. طبق گزارشهای فنی، اگرچه این روش مؤثر است، اما علاوه بر ایجاد تأخیر (Latency)، نشانههای فرازبانی مانند لحن، آهنگ صدا و احساسات را کاملاً حذف میکند. در همین راستا، تلاش برای بهینهسازی لایهی اول این فرآیند ادامه دارد؛ برای مثال مدل Muse Voice متا توانست نرخ خطای تبدیل گفتار به متن را به ۳.۱٪ برساند.
مدلهای بومیِ صوت (Speech-native) با چالشی منحصربهفرد روبرو هستند: آنها باید خروجی صوتی را در فواصل زمانی منظم تولید کنند تا تعاملی باقی بمانند. این محدودیت باعث میشود تعداد توکنهای استدلالی نهان (Hidden Reasoning Tokens) که مدل میتواند تولید کند، بسیار محدود شود. برای درک این شکاف، باید به اعداد نگاه کرد: مدل پایه GLM-4-Voice تنها ۲۷.۳٪ صحت در GSM8K داشت، در حالی که متد STITCH پیشین با افزودن تکههای استدلالی، این عدد را به ۵۸.۷٪ رسانده بود. این رویکرد استفاده از توکنهای نهان برای بهبود استدلال، یادآور مدل BDH-CQ است که با بهرهگیری از استدلال نهان توانست هزینههای استنتاج در محک ARC-AGI را به شدت کاهش دهد.
با تکیه بر منطق یادگیری تقویتی (RL) که پیشتر در تحلیل مدلهای معاملات کمی (Quantitative Trading) بررسی کردیم، Kyutai اصول بهینهسازی مشابهی را در دامنه صوتی به کار گرفت تا شکاف استدلالی را پر کند. این پژوهش در واقع اولین کاربرد یادگیری تقویتی برای استدلال ریاضی در مدلهای بومیِ صوت است.
به نقل از گزارش فنی Marktechpost، پژوهشگران با استفاده از مدل پایه GLM-4-Voice-9B و یک فرآیند آموزشی دو مرحلهای پیش رفتند.
جزئیات آموزش
در مرحله اول، آنها از تنظیم نظارتشده (SFT) با استفاده از ۱۵۰,۶۱۶ مسئله از مجموعه Orca-Math بهره بردند. این مسائل توسط مدل Qwen3-235B برای قالب صوتی بازنویسی شدند و سپس از طریق DSM TTS با صداهای متنوع تولید شدند. این گام اولیه بهتنهایی صحت پاسخها را از ۲۷.۳٪ به ۶۱.۷٪ افزایش داد.
در مرحله دوم، یک هدف یادگیری تقویتی از نوع group-relative REINFORCE پیادهسازی شد. سازوکار این مرحله به شرح زیر بود:
- نمونهگیری: برای هر سؤال صوتی، مدل ۴ پاسخ مختلف با دمای (Temperature) ۰.۹ تولید کرد.
- داوری: مدل Qwen3-235B-A22B-2507 بهعنوان داور، متن رمزگشایی شده را بدون دیدن پاسخ مرجع، با یک پاداش باینری (صفر و یک) امتیازدهی کرد. در ۱۰۰ مورد که بهصورت دستی بررسی شد، این داور در ۸۸٪ موارد با انسانها همنظر بود.
- بهینهسازی: پاداشها در هر گروه مرکزیت یافتند. این متد با GRPO مرتبط است اما برشهای PPO (PPO clipping) و منظمسازی KL را حذف میکند.
این فاز یادگیری تقویتی روی ۱۶ پردازنده H100 طی ۱,۵۰۰ بهروزرسانی انجام شد. دو مکانیزم فنی کلیدی در این موفقیت نقش داشتند:
اول، اصلاح دما؛ لاجیتها پیش از تابع زیان log-softmax بر دمای نمونهگیری تقسیم شدند. بدون این اصلاح، صحت در GSM8K از ۶۵.۵٪ به ۱۲.۳٪ سقوط میکرد. دوم، ادغام توکنهای صوتی (Audio-Token Merging)؛ در هر موقعیت صوتی، تمام احتمالات واژگان صوتی در یک توکن انتزاعی جمع شدند. در اینجا تابع زیان فقط میپرسد که آیا «صوت» در جایگاه بعدی قرار دارد یا خیر، نه اینکه دقیقاً کدام توکن صوتی استفاده شده است. ثابت شده است که این تخمینگر بدون سوگیری (Unbiased) است و واریانس کمتری دارد.
شرکت Kyutai دو نقطه بازرسی (Checkpoint) متمایز را در Hugging Face منتشر کرد. مدل glm-4-voice-of-reason-9b مستقیماً به سؤالات پاسخ میدهد. اما مدل glm-4-voice-of-reason-stitch-9b از تکههای استدلالی ۱۰۰ توکنی «ساکت» بین بلوکهای صوتی استفاده میکند. از آنجا که این تکهها همزمان با پخش صدای قبلی تولید میشوند، فرآیند «تفکر» هیچ تأخیر محسوسی برای تجربه کاربر ایجاد نمیکند.
عملکرد و بنچمارکها
دادههای عملکردی نشان میدهد مدل Stitch به صحت ۷۷.۱٪ در GSM8K (نسخه منتشر شده) رسیده است که بهطور قابلتوجهی از عدد ۵۸.۷٪ در متد STITCH قدیمی بالاتر است. برای مقایسه، مدل مستقیم (Direct) به صحت ۷۰.۳٪ رسید.
در حالی که سیستمهای بزرگتری مانند Qwen3-Omni (۳۰ میلیارد پارامتری) با ۹۴.۶٪ در خروجی متنی پیشتاز هستند و سیستمهای متوالی ASR-LLM-TTS به ۹۵.۷٪ رسیدهاند، مدلهای ۹ میلیاردی Kyutai ثابت کردند که استدلال سطح بالا در معماریهای کوچکتر و بومیِ صوت نیز ممکن است. یافتههای دیگر عبارتند از:
- گفتار واقعی: در تست با Qwen3-ASR-1.7B، مدل Stitch امتیاز ۷۲.۰ ± ۱.۹٪ کسب کرد. این در حالی است که رقبا نیز در حال ارتقای زیرساختهای خود هستند و مثلاً مدل Grok Voice Transcribe 2.0 توانسته است دقت تبدیل گفتار به متن را دو برابر کند.
- طبیعی بودن: امتیاز UTMOSv2 تقریباً ثابت ماند و برای مدل مستقیم از ۴.۰۶۷ به ۴.۰۶۹ تغییر کرد.
- کارایی: یادگیری تقویتی در واقع میانگین طول پاسخهای مدل مستقیم را از ۴۱.۹ به ۳۶.۴ ثانیه کاهش داد.
- بهرهوری داده: با استفاده از تنها ۱۰٪ از دادههای SFT، یک اجرای طولانیتر RL توانست به صحت ۵۸.۵٪ برسد، در حالی که SFT بهتنهایی تنها ۴۳.۹٪ صحت داشت.
این پیشرفت معیار تعامل با هوش مصنوعی را تغییر میدهد و ثابت میکند که یادگیری تقویتی را میتوان مستقیماً روی توکنهای صوتی اعمال کرد تا منطق مدل بهبود یابد. این یعنی «مالیات استدلال» — یعنی همان تأخیری که معمولاً با تفکر پیچیده همراه است — میتواند از طریق تولید متناوب صوت و متن پنهان شود.
البته این پیشرفت هزینهای داشت. پژوهشگران متوجه افت در دانش عمومی شدند؛ امتیاز Spoken TriviaQA از ۴۰.۶٪ به ۳۴.۰٪ کاهش یافت که این اثر جانبی عمدتاً به فرآیند SFT با دادههای کامل نسبت داده شد، نه فاز RL. برای اطمینان از اعتبار ارزیابی، تیم موارد AddSub, MultiArith, SingleEQ و SVAMP را از ارزیابی حذف کرد. از ۶۷۸ سؤال بررسی شده، ۵۴.۰٪ آنها در سطح بازنویسی (Paraphrase) با Orca-Math همپوشانی داشتند.
برای استقرار، هر دو نقطه بازرسی BF16 روی یک GPU H100 قابل اجرا هستند. کاربران برای توکنساز و رمزگشای صوتی به مخزن GLM-4-Voice نیاز دارند و وزنها تحت لایسنس GLM-4-Voice منتشر شدهاند.
گام بعدی شما
- اگر روی دستیارهای صوتی کار میکنید، مدل Stitch را برای کاهش تأخیر در استدلالهای پیچیده تست کنید.
- معماری ادغام توکنهای صوتی (Audio-Token Merging) را برای کاهش واریانس در مدلهای مولد صوت بررسی کنید.
- توازن بین استدلال ریاضی و دانش عمومی (General Knowledge) را در مدلهای کوچکتر پایش کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو