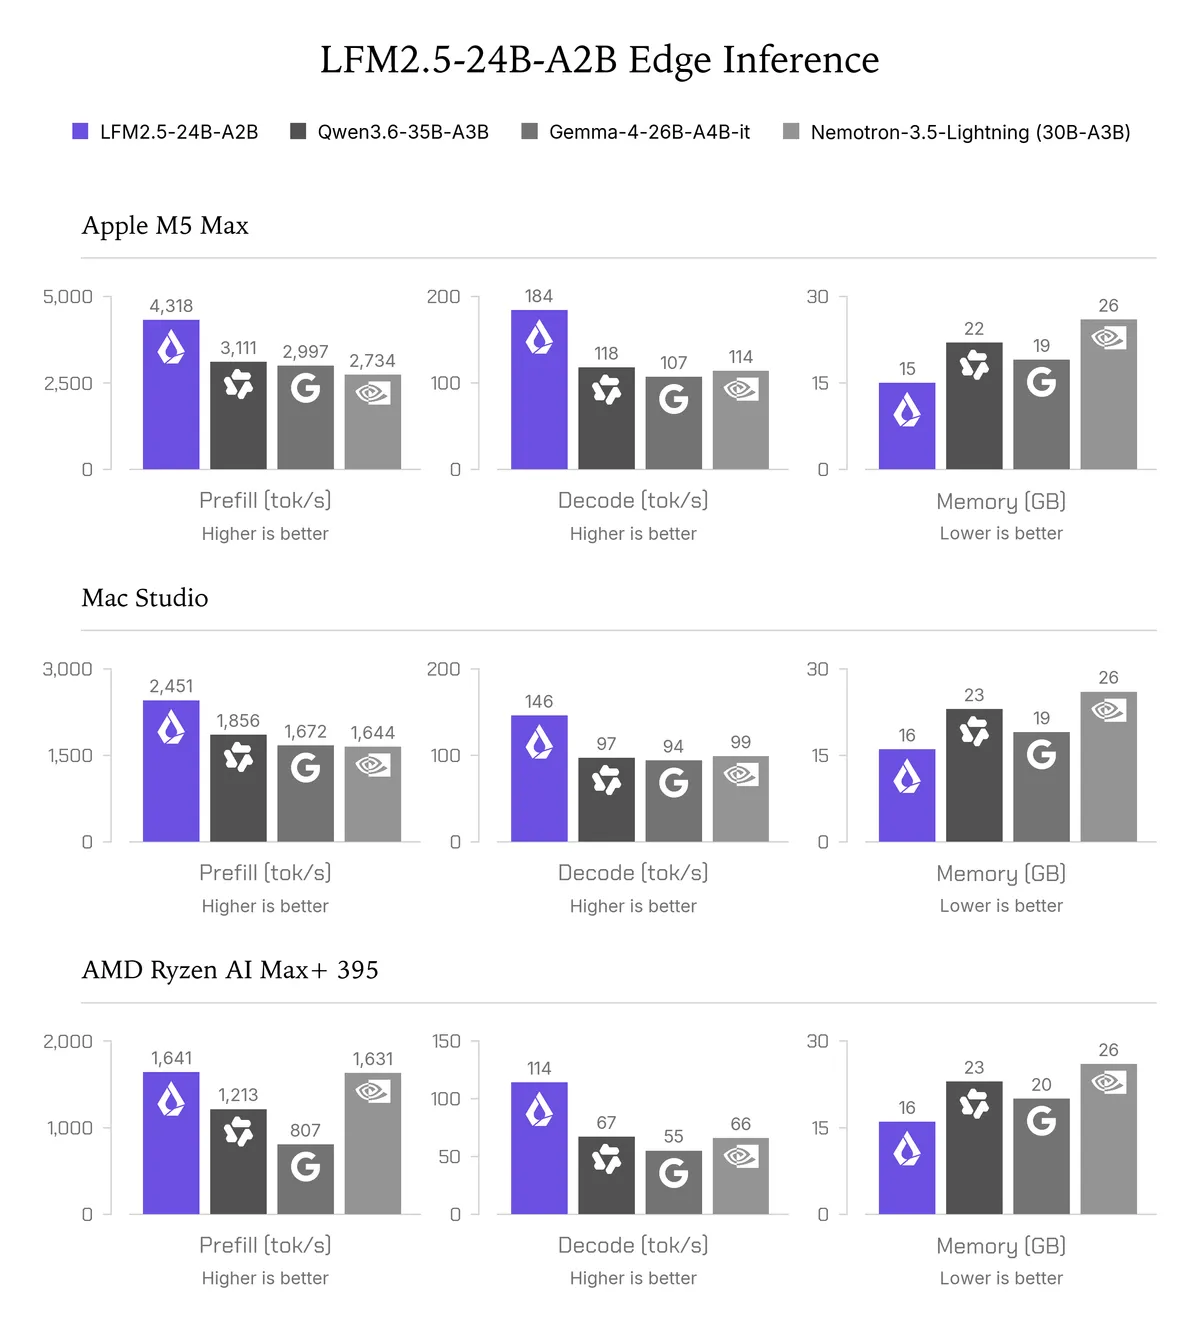
اگر امروز برای اجرای عاملهای هوش مصنوعی به سرورهای ابری متکی هستید، باید بدانید که عصر پردازش محلی با سرعتی باورنکردنی در حال بازگشت است. مدل LFM2.5-24B-A2B روی تراشه Apple M5 Max به سرعت ۱۸۴ توکن در ثانیه رسید تا ثابت کند استدلال پیچیده لزوماً به سختافزارهای عظیم نیاز ندارد. طبق اعلام Liquid AI در ۱۳ اکتبر ۲۰۲۶، این مدل به توسعهدهندگان اجازه میدهد عاملهای خصوصی و چندمرحلهای را مستقیماً روی دستگاه کاربر مستقر کنند؛ عاملهایی که پیش از هر اقدامی، ابتدا فکر میکنند.
بیشتر هوشهای مصنوعی محلی با یک تضاد همیشگی میان هوشمندی و سرعت دستوپنجه نرم میکنند. مدلهای بزرگ استدلال بهتری دارند اما روی سختافزارهای مصرفی بسیار کند هستند یا باتری را بهسرعت تخلیه میکنند. Liquid AI این مشکل را با معماری ترکیب خبرهها (Mixture of Experts یا MoE) حل کرده است که در آن تنها بخشی از کل پارامترها در هر لحظه فعال هستند.
این ساختار را شبیه به یک کتابخانه عظیم تصور کنید که در آن کتابدار برای هر کلمهای که میگوید، بهجای خواندن کل آرشیو، فقط سه کتاب مرتبطترین را بیرون میکشد. این بهرهوری باعث میشود توکنهای استدلالی «ارزان» شوند و به عامل اجازه دهد بدون کند کردن سیستم، یک تکگویی داخلی مداوم برای حل مسائل پیچیده داشته باشد.
معماری فنی و آموزش
این مدل بر پایه نسخه قبلی (LFM2-24B-A2B) ساخته شده و دارای ۴۰ لایه و ۶۴ خبره در هر بلوک MoE با مسیریابی top-4 است. این مدل از ترکیبی از کانولوشنهای کوتاه گیتدار (gated short convolutions) و توجه پرسوجوی گروهی (Grouped-Query Attention یا GQA) استفاده میکند. برخلاف نسل پیشین، این یک مدل استدلالی (Reasoning Model) است که پیش از پاسخ نهایی، یک زنجیره تفکر (Chain-of-Thought) صریح تولید میکند.
تیم توسعه مقیاس دادهها و قابلیتهای مدل را بهطور قابلتوجهی افزایش داده است:
- مقیاس دادهها: پیشآموزش از حدود ۱۷ تریلیون به ۳۳ تریلیون توکن (Token) افزایش یافت.
- پنجره زمینه: از ۳۲ هزار به ۱۳۱ هزار توکن گسترش یافت تا متون بسیار طولانیتری را در حافظه فعال خود نگه دارد.
- واژگان: تعداد توکنهای واژگان از ۶۵ هزار به ۱۲۸ هزار رسید. این کار از طریق گسترش توکنساز در جایگاه (in-place tokenizer expansion) برای بهبود توکنبندی زبانهای غیرلاتین انجام شد.
- تمرکز بر استدلال: یک فاز میان-آموزشی (mid-training) اضافه شد که در آن ۲ تریلیون توکن با پنجره زمینه ۳۲ هزار، با وزن بیشتر روی ریاضیات، کدنویسی، پیروی از دستورات و متون چندزبانه اضافه گردید.
- آموزش زمینه طولانی: ۳۰۰ میلیارد توکن اضافی با پنجره زمینه ۱۳۱ هزار، با تمرکز بر دادههای با متن طولانی به مدل تزریق شد.
همچنین، فراخوانی ابزارها (Tool calls) و مسیرهای چند-گام (multi-turn trajectories) در هر دو فاز پیشآموزش و میان-آموزش ادغام شدند تا قابلیت اطمینان عاملمحور مدل تضمین شود.
خط لوله پسآموزش
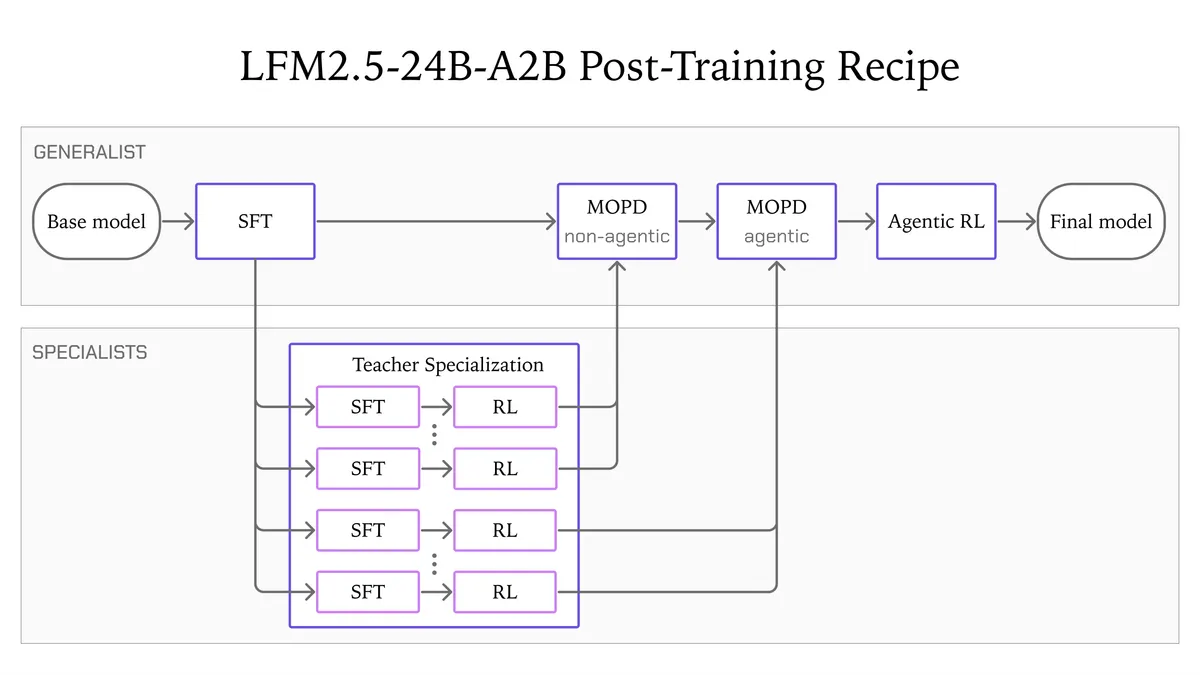
برای تبدیل مدل پایه به یک عامل کاربردی، Liquid AI یک فرآیند پنجمرحلهای را اجرا کرد:
۱. تنظیم نظارتشده (SFT): برای همراستاسازی اولیه مدل.
۲. تخصصی کردن معلم (Teacher Specialization): ایجاد مدلهای خبره برای حوزههای خاص.
۳. MOPD غیرعاملمحور: تقطیر سیاست-در-لحظه (on-policy distillation) در چندین دامنه برای انتقال دانش متخصصان به وظایف غیرعاملمحور.
۴. MOPD عاملمحور: مرحله دوم تقطیر که بهطور خاص بر وظایف عاملمحور تمرکز داشت.
۵. یادگیری تقویتی عاملمحور (Agentic RL): آموزش مدل در محیطهای فعال عامل مانند OpenCode، Pi، Hermes Agent و OpenClaw.
محکهای عملکردی
به گزارش huggingface.co، این مدل در برابر مدلهای بزرگتری مثل Qwen3.6-35B-A3B که تقریباً ۵۰٪ پارامتر فعال و کل بیشتری دارد، بسیار رقابتی است. در محک LiveClaw، مدل LFM2.5-24B-A2B امتیاز ۴۸.۰۹ را کسب کرد که بهطور قابلتوجهی بالاتر از امتیاز ۳۸.۱۹ مدل Qwen است.
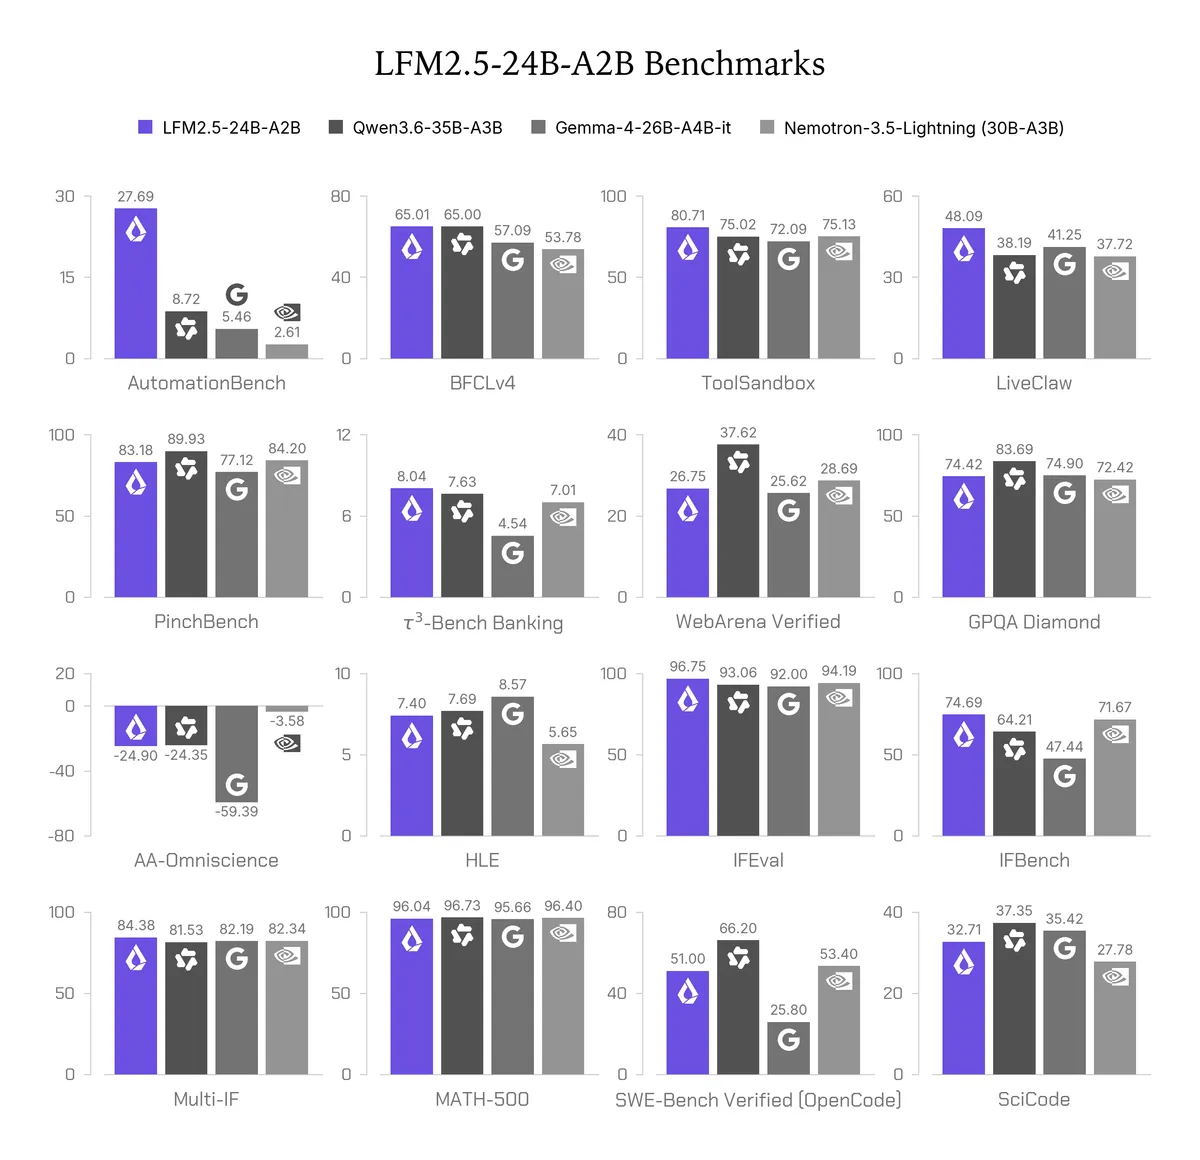
این مدل در استفاده از ابزار (Tool Use) و پیروی از دستورات پیشتاز است و در پنج مورد از هشت محک عاملمحور، رقبای خود را شکست داده یا با آنها برابر شده است. بهطور خاص، در AutomationBench، امتیاز ۲۷.۶۹ را به دست آورد که بیش از سه برابر مدل رقیب (Qwen3.6-35B-A3B با امتیاز ۸.۷۲) است. نتایج قدرتمند دیگر عبارتند از:
- BFCLv4: امتیاز ۶۵.۰۱ (برابر با ۶۵.۰۰ مدل Qwen)
- ToolSandbox: امتیاز ۸۰.۷۱
- τ³-Bench Banking: امتیاز ۸.۰۴
- IFEval: امتیاز ۹۶.۷۵ (پیشتاز در تمام مدلهای مقایسه شده)
- IFBench: امتیاز ۷۴.۶۹
- Multi-IF: امتیاز ۸۴.۳۸
با این حال، مدلهای بزرگتر همچنان در وظایف دانشمحور برتری دارند؛ برای مثال در GPQA Diamond، مدل Qwen امتیاز ۸۳.۶۹ و LFM امتیاز ۷۴.۴۲ را کسب کرد. همچنین در محکهای HLE، AA-Omniscience و کدنویسی پیچیده در SWE-Bench Verified (OpenCode) و SciCode، مدلهای بزرگتر جلوتر هستند. به همین دلیل، Liquid AI توصیه میکند برای این حجم از کارهای دانشی، مدل را با سیستمهای بازیابی (Retrieval) یا جستجوی وب ترکیب کنید.
بهرهوری سختافزاری
سرعت استنتاج، نقطه تمایز اصلی این مدل است. در لبه (Edge)، این مدل روی Ryzen AI Max+ 395 به ۱۱۴ توکن بر ثانیه میرسد که تا ۱.۷ برابر سریعتر از نزدیکترین رقیب است و در عین حال کمترین مقدار حافظه را مصرف میکند. این بهینهسازی در مصرف منابع، یادآور تلاشهایی است که برای اجرای مدلهای زبانی روی سختافزارهای محدود با استفاده از استریم SSD صورت گرفته است.
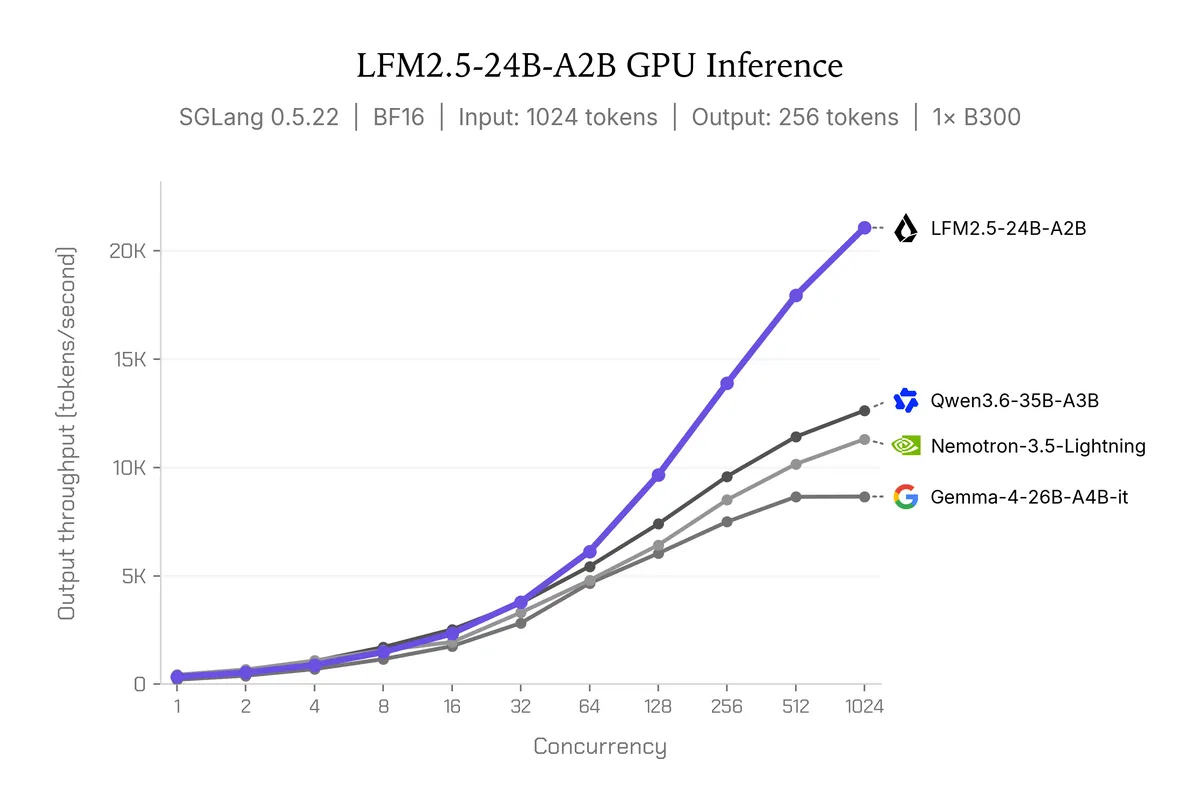
در مراکز داده، این مدل روی یک GPU NVIDIA B300 میتواند در حالت همزمانی بالا به بیش از ۲۱ هزار توکن خروجی در ثانیه برسد. این عملکرد به دلیل ادغام روز اول با اکوسیستمهای گستردهای مثل llama.cpp، MLX، vLLM، SGLang و ONNX ممکن شده است. در همین راستا، زیرساختهای جدیدی مانند سرور Superfluid توانستهاند زمان پاسخدهی عاملهای محلی را تا ۳۰ برابر کاهش دهند تا سرعت استنتاج در مقیاس صنعتی بهینه شود.
برای کاربر نهایی، این یعنی شکاف «عاملمحور» در حال بسته شدن است. دیگر نیازی به اشتراکهای ابری گرانقیمت نیست تا هوش مصنوعی بتواند بهطور مستقل فایلهای شما را مدیریت کند یا APIهای محلی را با قابلیت اطمینان بالا فراخوانی کند. ارزش اکنون از «اندازه مدل» به «بهرهوری مسیریابی» منتقل شده است.
توسعهدهندگان میتوانند این مدل را از طریق بکاندهای سازگار با OpenAI در محیطهایی مثل Hermes Agent یا OpenClaw مستقر کنند. برای کسانی که به دنبال مدیریت بهینه این مدلها هستند، بررسی ۱۱ چارچوب متنباز برای مدیریت عاملهای محلی در سال ۲۰۲۶ میتواند راهنمای مفیدی در انتخاب ابزار مناسب باشد. چون مدل زنجیره تفکر صریحی تولید میکند، منطق عامل شفاف است و عیبیابی آن بسیار سادهتر از مدلهای جعبهسیاه سنتی است.
باید منتظر بود و دید این بهرهوری چگونه بر موج بعدی لپتاپها و گوشیهای هوشمند ادغامشده با AI تأثیر میگذارد؛ جایی که استدلال محلی احتمالاً جایگزین رابطهای ساده چت ابری خواهد شد.
گام بعدی شما
- اگر توسعهدهنده هستید، مدل را از طریق llama.cpp روی سختافزار محلی تست کنید تا تأخیر استنتاج را بسنجید.
- برای کارهای دانشی، حتماً یک لایه RAG ساده برای جلوگیری از توهمات مدل اضافه کنید.
- بررسی کنید که آیا گردشکارهای فعلی شما میتواند از مدلهای MoE کوچکتر برای کاهش هزینه GPU استفاده کند یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو