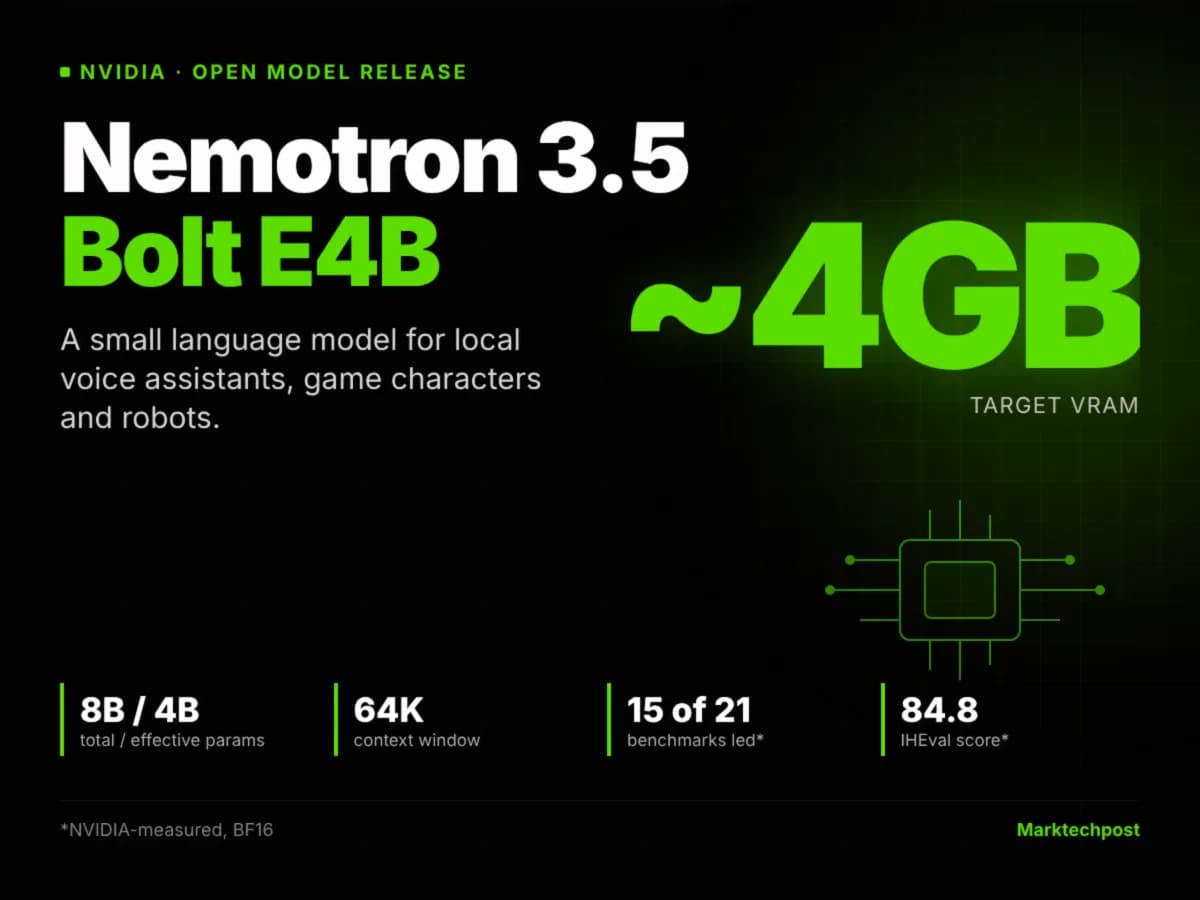
انویدیا یک مدل زبانی کوچک (SLM) را با ۸ میلیارد پارامتر کل و ۴ میلیارد پارامتر موثر عرضه کرد که ۱۵ از ۲۱ محکِ عاملمحور را در تستهای NeMo-Gym پیش میگیرد. نمروترون ۳.۵ بولت E4B 4GB در ۲۴ اکتبر ۲۰۲۶ با مجوز OpenMDW-1.1 و دادهها و دستورالعملهای آموزشی کامل منتشر شد.
زمینه: چرا این انتشار مهم است
- ظرفیت حافظه: برچسب «۴ گیگابایت» یک بودجه هدف VRAM است، نه اندازه فایل. بیلد Q4_K_M GGUF روی هاگینگفیس ۶.۱۸ گیگابایت است.
- سه بار کاری هدف: دستیارهای دستگاه و صوتی، شخصیتهای تعاملی (NPCهای بازی)، و عاملهای جاسازیشده یا صنعتی.
- ریشه ACE: انویدیا بولت را نسل سوم مدلهای کوچک برای شخصیتهای بازی ACE مینامد.
- نمایش ربات: گزارش تحقیق ربات Reachy Mini روی Jetson Orin Nano ۸ گیگابایت را نشان میدهد. Cosmos 3 Edge بینایی را مدیریت میکند و بولت پاسخهای گفتاری و فراخوانی ابزارها را بر عهده دارد.
- رتبهبندی Scale Labs: بولت در میان مدلهای کوچک در MultiChallenge با ۵۶.۰۳٪ رتبه اول را کسب کرد، بر اساس یک پست X از Scale Labs.
معماری و مشخصات
- پارامترها: ۸ میلیارد کل، ۴ میلیارد موثر
- پنجره زمینه (Context Window): ۶۴ هزار توکن برای تاریخچه، تعاریف ابزار و حالت برنامه
- مدل پایه: جما ۴ E4B گوگل (چگال با تعبیههای لایهبهلایه)
- مجوز: OpenMDW-1.1 (وزنها، دادهها و دستورالعملها باز)
- ورودیها: فقط متن روی کارت مدل؛ NIM همچنین تصویر و صدا میپذیرد
متدولوژی آموزش: فقط یادگیری تقویتی (RL-only)
انویدیا از تنظیم دقیق نظارتشده (SFT) صرفنظر کرد. بر اساس گزارش تحقیق، SFT فراخوانی ابزار را بهبود میداد اما کیفیت گفتاری و کثرتگویی جما را آسیب میرساند. تیم تحقیق از موارد زیر استفاده کرد:
- RLVR و RLHF از طریق NeMo-RL و NeMo-Gym
- نمونهگیری دوحالت: هر نمونه آموزشی در هر دو حالت استدلالی و غیراستدلالی اجرا میشد
- نسبت دسته: ۲ به ۱ به نفع نمونههای غیراستدلالی
- جریمه طول: محیط GenRM از رشد پاسخها در طول آموزش جلوگیری میکرد
- آرتیفکتهای عمومی: دادهها و دستورالعمل کامل در دسترساند
کوانتیزه و رمزگشایی گمانهزنانه (Speculative Decoding)
- کوانتیزه: چکپوینت BF16 به Q4_K_M با کالیبراسیون ماتریس اهمیت
- داده کالیبراسیون: حدود ۱ میلیون توکن از رولاوتهای RL
- درافر DFlash: با درافر رمزگشایی گمانهزنانه عرضه میشود
- نتیجه سرعت: روی RTX 5070، بولت با DFlash به ۲۷۲.۶ توکن در ثانیه رسید در حالی که جما ۴ E4B با درافر MTP ۲۲۵.۹ توکن در ثانیه ثبت کرد (۱.۲۱ برابر سریعتر)
نتایج محکها (BF16، اندازهگیری انویدیا در NeMo-Gym)
انویدیا ۲۱ محک را در ۵ حوزه توانایی دستهبندی کرد. بولت در حالت استدلالی در ۱۵ ردیف پیشرو بود. انویدیا میانگین نمرات را حدود ۴۰٪ بالاتر از نمروترون ۳ نانو ۴B و تا ۸۰٪ توکن خروجی کمتر در مقایسههای با استدلال گزارش میدهد.
نقاط قوت:
- IHEval: ۸۴.۸ (برابر جما ۶۷.۰، کوئن ۶۰.۶، نمروترون ۳ نانو ۵۱.۳)
- MultiChallenge: ۵۳.۱ (برابر جما ۴۲.۱، کوئن ۵۱.۸، نمروترون ۳ نانو ۳۵.۳)
نقاط ضعف:
- Tau2-Bench: ۵۵.۱ (برابر کوئن ۷۵.۱، جما ۳۸.۵، نمروترون ۳ نانو ۲۹.۲) — شکاف ۲۰ امتیازی
- RULER 64K: ۸۷.۰ (برابر کوئن ۹۵.۱، جما ۸۶.۵، نمروترون ۳ نانو ۹۱.۵)
- LongBench v2: ۵۰.۵ (برابر کوئن ۵۹.۹، جما ۵۲.۱، نمروترون ۳ نانو ۴۴.۸)
- BFCL-v3: ۶۸.۵ (برابر کوئن ۷۰.۹، جما ۶۵.۲، نمروترون ۳ نانو ۵۸.۱)
- EQ-Bench v3: ۳۹.۴ (برابر جما ۴۱.۱، کوئن ۳۸.۷، نمروترون ۳ نانو ۳۴.۲)
ویژگیهای اصلی برای توسعهدهندگان
- استفاده از ابزار چندمرحلهای با راهنمایی برای فراخوانیهای ناهمگام
- پرچم conversational_mode برای پاسخهای کوتاه و مناسب گفتار
- استدلال قابل پیکربندی با بودجه تفکر در زمان اجرا برای سقف تأخیر
- ۶۴ هزار زمینه برای تاریخچه، تعاریف ابزار و حالت برنامه
عملکرد سختافزاری (Q4_K_M، llama.cpp، اندازه دسته ۱، ۳ هزار توکن ورودی / ۵۰ توکن خروجی)
| دستگاه | VRAM (گیگابایت) | زمان تا نخستین توکن (میلیثانیه) | توکن در ثانیه |
|---|---|---|---|
| RTX 5070 (۱۲ گیگابایت) | ۳.۵ | ۵۴ | ۱۳۳.۴ |
| RTX Spark (۳۲ گیگابایت) | ۳.۱ | ۹۳ | ۱۰۶.۷ |
| Jetson AGX Orin (۳۲ گیگابایت) | ۴.۲ | ۳۶۸۷ | ۲۴.۰ |
| Jetson Orin Nano (۸ گیگابایت) | ۴.۲ | ۵۷۸۵ | ۱۵.۵ |
سختافزارهای پشتیبانیشده: GeForce RTX، Jetson، RTX Spark و DGX Spark.
کانالهای استقرار
- Hugging Face (GGUF و BF16)
- Ollama
- LM Studio
- Unsloth
- Jetson AI Lab
- NVIDIA NIM (API رایگان روی build.nvidia.com)
- In-Game Inferencing SDK برای شخصیتهای بازی ACE
منظر مقایسهای
| ویژگی | نمروترون ۳.۵ بولت E4B | جما ۴ E4B | کوئن ۳.۵-۴B | نمروترون ۳ نانو ۴B |
|---|---|---|---|---|
| پارامترها | ۸ میلیارد کل، ۴ میلیارد موثر | ۸ میلیارد با تعبیه، ۴.۵ میلیارد موثر | ۴ میلیارد | ۳.۹۷ میلیارد |
| معماری | جما ۴ E4B، پسآموزش RL | چگال با تعبیههای لایهبهلایه | Gated DeltaNet + توجه ترکیبی | Mamba-2 + ترنسفورمر ترکیبی |
| زمینه | ۶۴ هزار | ۱۲۸ هزار | ۲۶۲ هزار | ۲۶۲ هزار |
| مجوز | OpenMDW-1.1 | MDW-1.1 | Apache 2.0 | Apache 2.0 |
| ورودیها | متن (کارت)؛ NIM: تصویر، صدا | متن، تصویر، صدا | متن، تصویر، ویدیو | متن |
نکات کلیدی
- جما ۴ E4B توسط انویدیا با فقط RL پسآموزش دیده، بدون SFT
- در ۱۵ از ۲۱ محک عامل در تسخیر انویدیا پیشرو است
- IHEval ۸۴.۸ برجسته است؛ Tau2-Bench ۵۵.۱ نقطه ضعف است
- «۴ گیگابایت» هدف VRAM است؛ فایل GGUF ۶.۱۸ گیگابایت است
- وزنها، دادهها و دستورالعملها تحت OpenMDW-1.1 باز هستند
پیامدها برای تیمهای هوش مصنوعی لبه
هدف ۴ گیگابایتی VRAM معیار عملی است: بولت روی RTX 5070 با حاشیه برای Whisper و یک انکودر بینایی جا میشود و عاملهای صوتی کاملاً محلی را امکانپذیر میکند. مسیرهای NIM و In-Game Inferencing SDK اصطکاک یکپارچهسازی را برای استودیوهای بازی و توسعهدهندگان رباتیک کاهش میدهند.
مقايسهها و شکافها
ضعف Tau2-Bench (۵۵.۱ در برابر ۷۵.۱ کوئن) نشان میدهد که ارکستراسیون پیچیده چندمرحلهای ابزار همچنان شکافی برای رویکردهای فقط RL است. معماری ترکیبی Gated DeltaNet کوئن ۳.۵-۴B در بازیابی متن طولانی (RULER 64K، LongBench v2) هم برتری دارد. توسعهدهندگانی که بولت را انتخاب میکنند، عمق فراخوانی ابزار را برای طبیعی بودن گفتاری و VRAM پایینتر فدای میکنند. برای دیدگاه گستردهتری درباره جایگاه نمروترون ۳.۵ در میان مدلهای استدلالی، این تحلیل مقایسهای را مطالعه کنید.
چه چیزهایی را باید رصد کرد
- کوانتیزههای جامعه پایینتر از Q4_K_M
- فورکهای دستورالعمل NeMo-RL برای وظایف عامل خاص دامنه
- گزارش فنی، مدل GGUF، مدل BF16 و دستورالعمل آموزش (همه از صفحه انتشار لینک شدهاند)
دستورالعمل پسآموزش فقط RL انویدیا خط لوله استاندارد SFT-سپس-RL را چالش میکند. با حفظ روانی گفتاری پایه جما در حالی که رفتارهای عامل را از طریق تقویت تزریق میکند، بولت پیروی از دستورالعمل قویتری را بدون جریمه کثرتگویی که بسیاری از مدلهای کوچک تنظیمدقیقشده را آزار میدهد، دستیابی میکند. دادههای باز و تسخیر NeMo-Gym به توسعهدهندگان اجازه میدهد دستورالعمل را تکرار یا گسترش دهند.
گام بعدی شما
- بیلد Q4_K_M را از Hugging Face دانلود و روی RTX 5070 یا Jetson Orin Nano با llama.cpp تست کنید تا مصرف VRAM و تأخیر را در گردشکار خود بسنجید.
- اگر عامل صوتی میسازید، پرچم conversational_mode و بودجه تفکر را برای تعادل طبیعی بودن و سرعت تنظیم کنید.
- دستورالعمل NeMo-RL و دادههای عمومی را برای آموزش مجدد روی وظایف عامل خاص دامنه (Domain-specific) بررسی کنید.
این مدل نشان میدهد که مسیر RL-only میتواند بدون SFT، کثرتگویی را کنترل کند و در عین حال رفتار عامل را تزریق نماید — گزارش فنی کامل، مدل GGUF، مدل BF16 و دستورالعمل آموزش همه از صفحه انتشار لینک شدهاند.
گفتگو