پژوهشگران دانشگاه نیویورک (NYU) و دانشگاه تگزاس در آستین (UT Austin) با بررسی ۱۴ مدل زبانی، شش الگوی زبانی را شناسایی کردند که خوانایی متن هوش مصنوعی را پایین میآورد. به گفتهٔ آنها، ریشهٔ مشکل اهداف آموزشی است که تراکم اطلاعات را بیش از وضوح برای انسان پاداش میدهند.
روش پژوهش و مدلهای بررسیشده
تیم پژوهش ۱۴ مدل را در سه نوع کار آزمود: گفتوگوی روزمره، جلسههای کدنویسی و مقالهٔ استدلالی. Claude، GPT-5.6، GLM-5، Kimi K2.5، Llama و Olmo از جمله این مدلها بودند.
پژوهشگران این دادهها را تحلیل کردند:
- ۱۲۰ گفتوگو
- ۴۵ جلسهٔ کدنویسی
- ۹۸۰ مقاله
در مجموع ۱٬۱۴۵ نمونهٔ تولیدشده با هوش مصنوعی بررسی شد. نمونههای انسانی برای مقایسه از زیرنویس فیلمها، پستهای StackExchange و مقالههای دانشجویی آمد.
پژوهش به تغییری مهم در آموزش مدلها هم میپردازد: گذار از RLHF به یادگیری تقویتی با پاداشهای قابل تأیید (RLVR). در RLVR بازخورد انسانی بهطور کامل از چرخهٔ آموزش حذف میشود.
شش الگویی که خوانایی متن هوش مصنوعی را کم میکند
مدلها اکنون برای ریاضیات، کدنویسی و استدلال بهینه میشوند. در این کارها درستی پاسخ مهم است، نه خوانایی آن. جکسون کرنیون (Jackson Kernion)، کارمند آنتروپیک، تأیید کرد که Opus 4.6 آخرین «مدل نویسندهٔ» قوی این شرکت بود. پس از آن، آنتروپیک تمرکز بیشتری بر بنچمارکهای فنی گذاشت.
مدلهای جدیدتر نوعی گویش پیدا کردهاند. این گویش برای فشردهسازی اطلاعات میان مدلهای هوش مصنوعی خوب است، اما برای انسان فشرده و غیرطبیعی است. شش الگوی شناساییشده اینهاست: این الگوهای تکراری شبیه به اثر انگشتهای زبانی که قبلاً در مدلهای هوش مصنوعی شناسایی شد است.
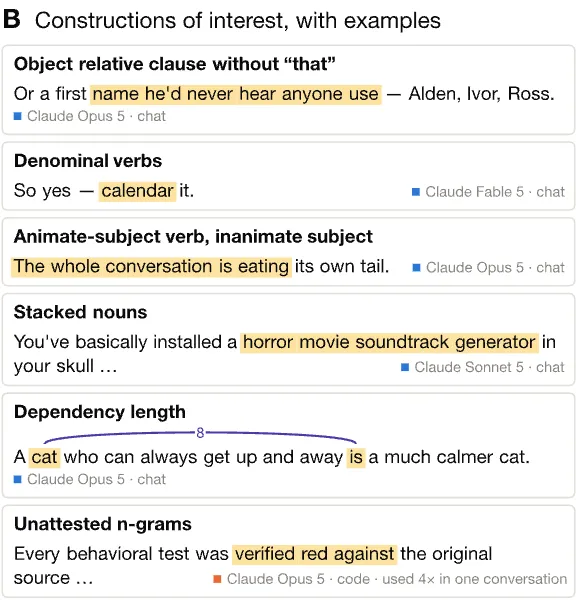
- ترکیبهای واژگانی نامعمول که در نوشتهٔ انسانی کم دیده میشوند، مانند «reader-patience budget» (بودجهٔ صبر خواننده).
- فاصلهٔ زیاد میان نهاد و گزارهٔ اصلی که حافظهٔ کاری را خسته میکند. Claude Opus 5 جملهٔ «A cat who can always get up and away is a much calmer cat» را نوشت که در آن نهاد و گزارهٔ اصلی با بندی طولانی از هم جدا شدهاند.
- حذف حرف ربط در ارجاع: «the book the professor wrote» بهجای «the book that the professor wrote». این کار یک کلمه صرفهجویی میکند، اما خواننده را لحظهای سردرگم میکند.
- پشتسرهم آوردن اسمها، مانند «horror movie soundtrack generator»، که خواننده را وادار میکند خودش حدس بزند کدام واژه وصف کدام است.
- تبدیل اسم به فعل، مانند «calendar it» در متن Claude Fable 5، جایی که انسان میگوید «آن را در تقویم بگذار».
- نسبت دادن فعل جانداران به فاعل بیجان. Claude Opus 5 نوشت «The whole conversation is eating its own tail» (کل گفتوگو دارد دم خودش را میخورد)، در حالی که گفتوگو نه دم دارد و نه میتواند بخورد.
مقایسهٔ مدلها
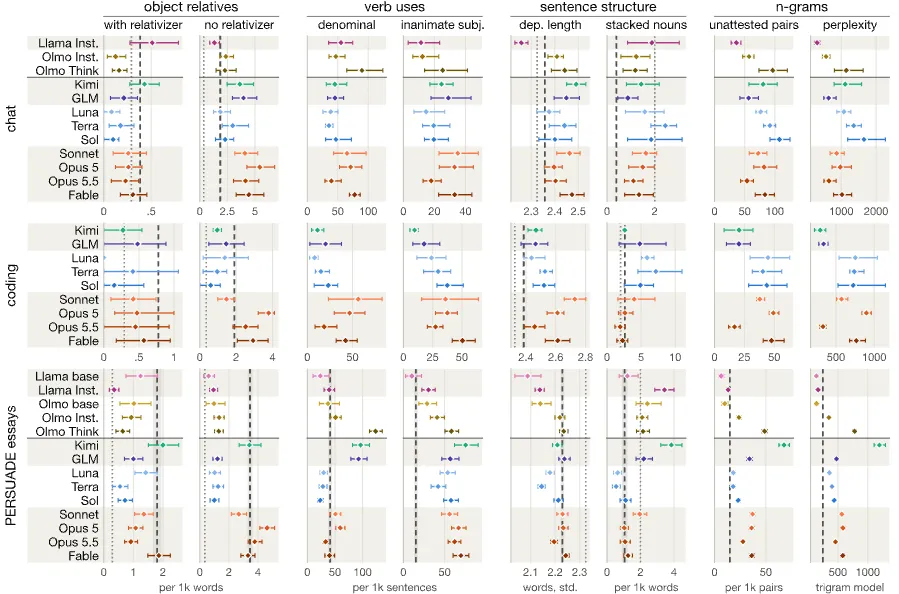
Llama و مدل پایهٔ Olmo بیشترین شباهت را به نوشتهٔ انسانی داشتند. در خانوادهٔ Olmo، خوانایی از مدل پایه به نسخهٔ Instruct و سپس به مدل استدلالی Olmo Think پیوسته کم شد. Olmo Think به میزان انحرافی در سطح مدلهای پیشرو رسید. این نتیجه نشان میدهد پسآموزش (post-training) عامل اصلی است.
Claude Opus 5.5 این روند را برعکس کرد. این مدل پس از تنظیم دقیق (fine-tuning) هدفمند، در ۱۹ از ۲۱ مقایسهٔ خوانایی از مدل قبلی، Opus 5، بهتر بود. این بهبود خوانایی در Claude با پیشی گرفتن مدلهای آنتروپیک در شبیهسازی لحن انسانی همخط است.
نقش روش آموزش در خوانایی
زبان انسان میان آسانی تولید و آسانی فهم تعادل برقرار میکند. به گفتهٔ پژوهشگران، مدلهای امروزی بیشتر روی ریاضیات، کد و استدلال منطقی آموزش میبینند. در این کارها درستی پاداش میگیرد و وضوح نه. گذار از RLHF به RLVR انسان را کاملاً از چرخهٔ بازخورد بیرون میکند. نتیجه نوعی «گویش» است که برای فشردهسازی اطلاعات و حل مسائل پیچیده کارآمد است، اما برای خوانندهٔ انسانی نه.
پژوهشگران برای اثبات این ایده، یک مدل زبانی کوچکتر را با جریمهای آموزش دادند که پاسخ کوتاهتر را پاداش میداد. در برخی شرایط، این مدل تقریباً همیشه عبارت کوتاهتر را برگزید، فارغ از بافت جمله. حتی این ترجیح را به الگوهایی تعمیم داد که هرگز در آموزش ندیده بود. انسانها اما بسته به موقعیت میان شکل کوتاه و بلند انتخاب میکنند.
تأیید از درون آنتروپیک
توضیحی مشابه از درون صنعت هم آمده است. جکسون کرنیون که روی تنظیم دقیق Claude کار میکند، اخیراً توضیح داد چرا Opus 4.6 آخرین «مدل نویسندهٔ» خوب آنتروپیک بود. به گفتهٔ او، بهینهسازی مدلهای جدید برای ریاضیات، کد و توضیحات فنی خطاب به دیگر مدلها، Claude را به سبکی کشاند که برای هوش مصنوعی مناسب است، اما برای انسان بیش از حد فشرده و غیرطبیعی است.
کرنیون این تغییر را سازگاری با «روانشناسی LLM» نامید. آنتروپیک با Opus 5.5 برای نخستین بار در برابر این روند ایستاد و روی وضوح جملهها و بخشهای پر از اطلاعات کار کرد. به گفتهٔ این پژوهش، این تلاش موفق بود.
پیامدها برای صنعت
یافتهها از تنشی ساختاری خبر میدهند. رقابت برای عملکرد استدلالی قابل تأیید، همان رابطی را تضعیف میکند که بیشتر کاربران به آن متکیاند. شرکتهایی که از هوش مصنوعی برای محتوای مشتریمحور استفاده میکنند، شاید به تنظیم ویژهٔ خوانایی یا مدلهای پایهٔ کوچکتر برای پیشنویس نیاز داشته باشند. این یافتهها میتوانند با ابزارهای تشخیص ساختاری ایدههای هوش مصنوعی تکمیل شوند.
Opus 5.5 نشان داد این آسیب با تلاش آگاهانه برگشتپذیر است. آزمایشگاههای دیگر احتمالاً همین راه را میروند، اما ساختار انگیزهها تغییری نکرده است: پاداشهای RLVR همچنان بار شناختی انسان را نادیده میگیرند. احتمال دارد بنچمارکهای خوانایی به جدولهای رتبهبندی راه پیدا کنند و سازمانها نسخههای «انسانمحور» بخواهند.
گام بعدی شما
- اگر متن مشتریمحور تولید میکنید، مدلهای پایهٔ Llama یا Olmo را هم برای پیشنویس امتحان کنید.
- خروجی مدل را با این شش الگو بسنجید و جملههای فشرده را بازنویسی کنید.
- ورود بنچمارکهای خوانایی به جدولهای رتبهبندی را دنبال کنید.
گفتگو