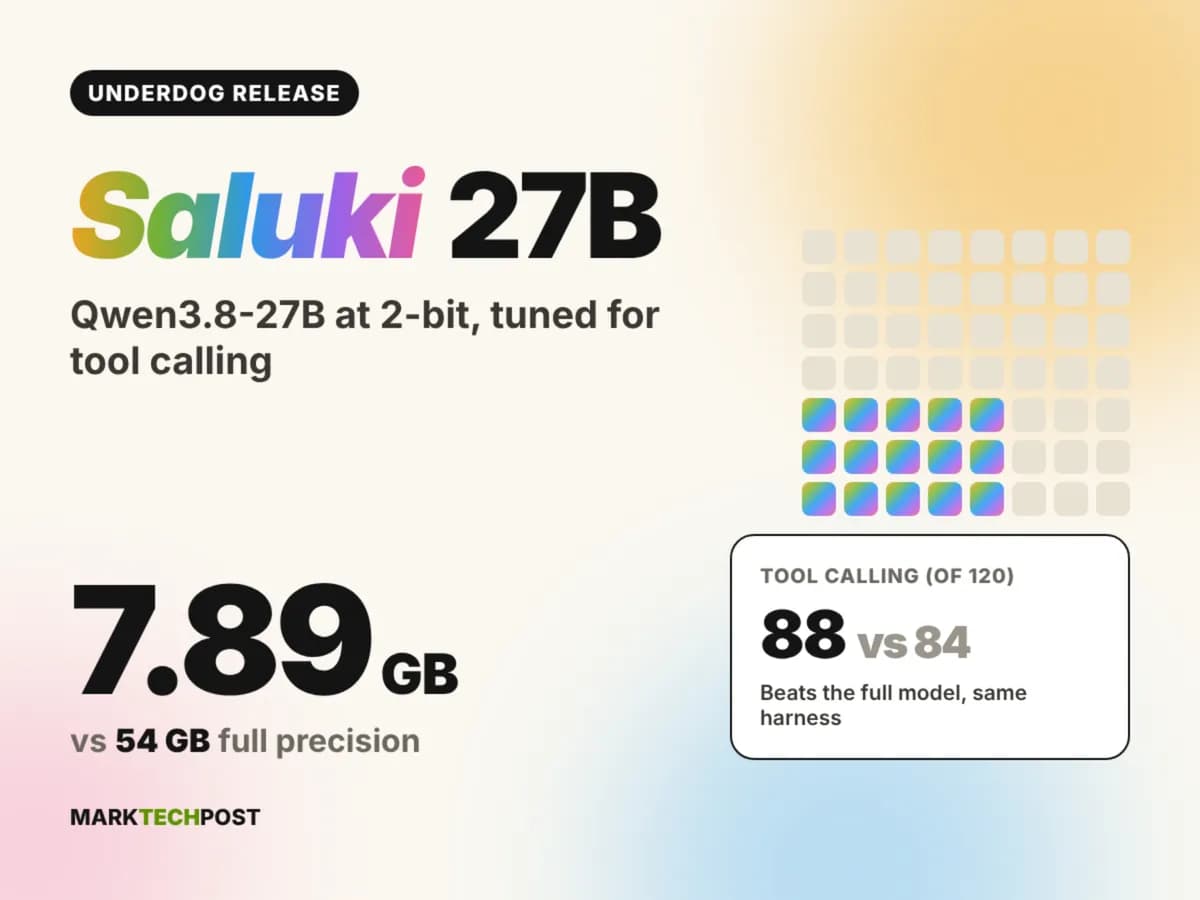
۷.۸۹ گیگابایت؛ این تمام فضای دیسکی است که برای اجرای Underdog Saluki 27B نیاز دارید. این مدل در واقع یک نسخه ۲-بیتی GGUF از مدل Qwen3.8-27B است که توسط Conway Research منتشر شده است. در حالی که مدلهای کلاس ۲۷ میلیارد پارامتری معمولاً به سختافزارهای گرانقیمت نیاز دارند، این نسخهٔ کوانتیده (Quantized) ثابت کرد که میتوان حجم یک مدل ۵۴ گیگابایتی را به ۱۴٪ اندازهٔ اولیه رساند و حتی در برخی قابلیتها، از مدل اصلی هم پیشی گرفت. برای درک بهتر تفاوتهای فنی در این زمینه، میتوانید بررسی جامع ما درباره چهار فرمت رایج بهینهسازی برای استقرار مدلهای زبانی را مطالعه کنید.
این دستاورد در زمانی رخ میدهد که صنعت به سمت عاملهای (Agents) محلی و اجرا روی دستگاه (On-device) حرکت میکند. همانطور که در تحلیل قبلی ما دربارهی سازوکارهای اجرای ابزار توسط عاملهای هوش مصنوعی اشاره کردیم، مدل Saluki 27B دقیقاً روی همان پل فنی تمرکز کرده است که یک مدل چت ساده را به یک عامل کاربردی تبدیل میکند. برای توسعهدهندگان، این یعنی یک عامل در سطح ۲۷ میلیارد پارامتر اکنون میتواند روی سختافزارهای مصرفکننده و با استفاده از لاماسیپلاسپلاس (llama.cpp) بهطور کامل روی GPU اجرا شود.
به نقل از گزارش MarkTechPost، معماری Saluki 27B بر پایه یک فرآیند بهینهسازی سهلایه بنا شده است. لایه نخست، مدل پایه Qwen3.8-27B است؛ مدلی از تیم Qwen که دارای ۶۴ لایه است و در آن توجه خطی Gated DeltaNet با توجه گیتدار (Gated Attention) ترکیب شده و پشتیبانی بومی از ۲۶۲,۱۴۴ توکن (Token) را ارائه میدهد.
در لایه دوم، از متدولوژی ISTA-DASLab و مدل Qwen3.8-27B-GSQ-RCO-GGUF استفاده شده است. در این مرحله، از GSQ برای یادگیری شبکههای اسکالر دقیق برای هر تنسور و از RCO برای تخصیص انواع کوانتش به هر تنسور تحت یک بودجهٔ حجمی ثابت استفاده میشود. برای درک بهتر، کوچکترین فایل این مرحله (IQ2_XS) با نرخ ۲.۵۰ بیت به ازای هر وزن، حدود ۸.۴ گیگابایت بود.
لایه نهایی، یک پردازش اختصاصی توسط تیم Underdog است که حجم فایل را باز هم کاهش داد تا به ۷.۸۹ گیگابایت برسد و خروجی را به فرمت IQ2-mix با تگ imatrix تبدیل کرد. اگرچه دستورالعمل دقیق این مرحله منتشر نشده، اما طبق مستندات، این تنظیمات بهطور ویژه برای محافظت از قابلیت فراخوانی تابع (Function Calling) بهینهسازی شده است.
مشخصات فنی و عملکرد این مدل به شرح زیر است:
- حجم فایل: ۷.۸۹ گیگابایت (در مقابل ۵۴ گیگابایت برای نسخه BF16).
- سازگاری: اجرا روی نسخه استاندارد llama.cpp و اپلیکیشنهای مرتبط با آن بدون نیاز به فورکهای سفارشی.
- پشتیبانی بینایی: افزودنیهای اختیاری با حجم ۶۲۹ یا ۹۲۸ مگابایت در دسترس است.
- مجوز: Apache 2.0.
- حفظ کیفیت: بهطور میانگین ۹۶٪ از تواناییهای مدل اصلی در ۹ محک (Benchmark) مختلف حفظ شده است.
در تستهای رودررو، Saluki 27B در Underdog Bench (شامل ۱۲۰ تکلیف از BFCL v4، بدون حالت تفکر و با دمای صفر) امتیاز ۸۸ کسب کرد که از امتیاز ۸۴ مدل اصلی و امتیاز ۷۰ مدل Bonsai 2 متعلق به PrismML پیشی گرفت. این برتری در فراخوانیهای موازی ابزارها چشمگیرتر بود؛ جایی که مدل فشرده با امتیاز ۴۲ در برابر امتیاز ۳۵ مدل اصلی، نرخ حفظ کیفی ۱۲۰ درصدی را ثبت کرد.
سایر نتایج متغیر بود. این مدل در IFEval (در حالت prompt-loose) امتیاز ۹۳.۵ (در مقابل ۹۱.۵ مدل اصلی) و در IFBench امتیاز ۷۲.۷ (در مقابل ۷۱.۰ مدل اصلی) را به دست آورد. با این حال، در آزمونهای کدنویسی مانند MBPP+ با امتیاز ۷۸.۰ در برابر ۸۳.۹ مدل اصلی و در MuSR با امتیاز ۶۷.۵ در برابر ۷۹.۶ مدل اصلی، عقب افتاد.
بهای این فشردهسازی شدید، کاهش توان استدلال در مسائل پیچیده است. بر اساس بررسی منابع، در محک AIME 2025، امتیاز Saluki از ۹۶.۷ در مدل اصلی به ۷۹.۲ سقوط کرد. به همین ترتیب، در AIME 2026 امتیاز مدل از ۹۴.۶ به ۸۰.۰ کاهش یافت. این یعنی برای ریاضیات سطح رقابتی و منطق چندمرحلهای، نرخ حفظ کیفیت حدود ۸۲٪ است و ۱۸٪ از توان مدل از دست رفته است. این کاهش در توان استدلال، در تضاد با رویکردهایی مانند مدل ThinkingCap قرار دارد که توانست حجم توکنهای استدلال را در مدل Qwen3.8-27B کاهش دهد بدون اینکه لزوماً کیفیت منطقی را فدا کند.
این تغییر در عملکرد، یک موازنه (Trade-off) جدید در کوانتش مدلها را معرفی میکند. در حالی که تلاشهای قبلی بر حفظ دانش عمومی متمرکز بود، Underdog ثابت کرد که قابلیتهای عاملمحور (Agentic) مانند فراخوانی ابزار را میتوان در حین فشردهسازی شدید، محافظت یا حتی تقویت کرد. این یافته، این فرض قدیمی را که برای رفتار عاملانهٔ قابلاعتماد حتماً به تعداد پارامتر بالا نیاز است، به چالش میکشد.
برگ برندهٔ فنی این مدل، حذف وابستگی به نسخههای تغییریافته (Custom Forks) است. برخلاف رقیبی مانند Bonsai 2 از PrismML که نرخ حفظ ۹۸.۲ درصدی در ۱۴ محک حالت تفکر و امتیاز ۹۵.۰۰ در AIME25 را گزارش میکند اما برای اجرا به یک فورک خاص از llama.cpp نیاز دارد، Saluki 27B با ابزارهای استاندارد و بهصورت آماده (Out of the box) کار میکند.
توسعهدهندگان اکنون میتوانند این مدل را از طریق کارت مدل در Hugging Face تست کنند تا ارزیابی کنند که آیا موازنه بین عمق استدلال و کارایی فراخوانی ابزار با گردشکار عاملهای آنها سازگار است یا خیر.
گام بعدی شما
- اگر در حال توسعه عاملهای محلی هستید، مدل Saluki 27B را از طریق کارت مدل در Hugging Face تست کنید تا موازنه بین عمق استدلال و سرعت فراخوانی ابزار را بسنجید.
- بررسی کنید که آیا گردشکار شما به ریاضیات پیچیده نیاز دارد یا صرفاً بر تعامل با APIها متکی است؛ در حالت دوم، این مدل جایگزینی بهینه است.
- برای کاهش هزینه استنتاج در محیطهای لبه، جایگزینی مدلهای BF16 با نسخههای IQ2-mix را آزمایش کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو